KI im HR messen: Kennzahlen für Recruiting, Service und Mitarbeitererlebnis
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
KI im HR zu messen bedeutet, einen kleinen Satz von Vorher-Nachher-Kennzahlen in vier Bereichen zu verfolgen (Geschwindigkeit und Qualität der Einstellung, HR-Service, Mitarbeitererlebnis sowie Fairness und Risiko), jeweils verglichen mit einer Baseline, die Sie vor dem Start erfasst haben, und, wo möglich, mit einer Gruppe, die das Tool nicht erhalten hat. Ohne Baseline ist „Die KI hat uns Zeit gespart“ eine Meinung. Mit ihr haben Sie eine Zahl, die Sie vor einem CFO, einem Prüfer oder einem skeptischen Recruiter vertreten können.
Diese Seite richtet sich an HR-Direktoren, People-Analytics-Verantwortliche und HR-Manager, die ein KI-Tool eingeschaltet haben (einen Screener, einen Chatbot, einen Terminassistenten) und nun zeigen müssen, dass es wirkt. Sie liefert die Kennzahlen nach HR-Funktion, eine Tabelle zum Kopieren, eine Einrichtung Schritt für Schritt und die Fehler, die Ergebnisse besser aussehen lassen, als sie sind. Für das Gesamtbild, wo KI in die Funktion passt, beginnen Sie mit KI im Personalwesen. Dies sind allgemeine Informationen, keine Rechtsberatung.
Wichtige Fakten
- Das Recruiting-Benchmarking 2026 von SHRM nennt einen Median von 39 Kalendertagen bis zur Besetzung (Time-to-Fill) für Positionen ohne Führungsebene, weniger als im Vorjahr; die Kosten pro Einstellung auf Führungsebene steigen demnach, die für Positionen ohne Führungsebene bleiben relativ stabil (SHRM).
- Nach der US-Bundesrichtlinie zur „Vier-Fünftel-Regel“ gilt eine Auswahlquote unter 80 % der Quote der am besten abschneidenden Gruppe von den Bundesbehörden im Allgemeinen als Hinweis auf nachteilige Auswirkung, wobei kleine Stichproben eine Lücke statistisch bedeutungslos machen können (29 CFR 1607.4).
- Das Local Law 144 der Stadt New York untersagt den Einsatz eines automatisierten Tools für Beschäftigungsentscheidungen, wenn es nicht innerhalb eines Jahres vor der Nutzung einem Bias-Audit unterzogen wurde, und die Stadt setzt es seit dem 5. Juli 2023 durch (NYC DCWP).
- Die Europäische Kommission stuft Software zur Sortierung von Lebensläufen als Hochrisiko-Anwendung ein, und Hochrisiko-Systeme unterliegen nach dem aktuellen Zeitplan ab dem 2. Dezember 2027 strengen Pflichten (Europäische Kommission).
- Das AI Risk Management Framework des NIST, am 26. Januar 2023 zur freiwilligen Nutzung veröffentlicht, nennt Measure als eine seiner vier Funktionen neben Govern, Map und Manage (NIST).
Warum die meisten Messungen von KI im HR scheitern
Drei Dinge gehen immer wieder schief.
Keine Baseline. Ein Team führt im März ein Screening-Tool ein, stellt im Juni fest, dass die Time-to-Hire gesunken ist, und schreibt das dem Tool zu. Doch der Einstellungsstopp endete im April, und im Mai kamen zwei Recruiter hinzu. Niemand hat festgehalten, wie hoch die Time-to-Hire im Februar war, nach Rollenfamilie, also kann niemand das Tool von allem anderen trennen, was sich geändert hat.
Aktivität statt Ergebnisse zählen. „Der Chatbot hat 4.000 Fragen beantwortet“ sagt etwas über das Volumen. Es sagt nicht, ob Beschäftigte die richtige Antwort erhielten oder ob die Fallzahl im HR-Service tatsächlich sank.
Nur die Vorteile messen. Ein Tool kann die Einstellung beschleunigen und leise den Anteil einer Gruppe verkleinern, die das Screening besteht. Wenn Ihr Dashboard nur Tempo und Kosten enthält, sehen Sie das nicht. Fairness und Fehlerquoten gehören auf dieselbe Seite wie die Einsparungen.
Die Lösung ist in jedem Fall dieselbe: die Kennzahlen festlegen, die Baseline erfassen und Tempo, Qualität und Risiko gemeinsam berichten. Die allgemeine Logik behandelt Messung des KI-ROI; diese Seite wendet sie auf das HR an.
Die vier Kennzahlenfamilien
1. Recruiting: Tempo, Qualität und Bewerbererlebnis
Das sind die Kennzahlen, die die meisten Teams schon haben, weshalb sie der einfachste Einstieg sind.
- Time-to-Fill: Tage von einer genehmigten Stellenanforderung (oder Stellenanzeige) bis zum angenommenen Angebot. Das Recruiting-Benchmarking 2026 von SHRM nennt für Positionen ohne Führungsebene einen Median von 39 Kalendertagen (SHRM). Betrachten Sie das als Kontext, nicht als Ziel: Ihre Mischung aus Rollen, Standorten und Seniorität wird abweichen, und Sie sollten zuerst mit Ihrer eigenen Historie vergleichen.
- Time-to-Hire: Tage vom Eintritt eines Bewerbers in den Prozess bis zur Zusage. Unternehmen definieren Start- und Endpunkt unterschiedlich, halten Sie Ihre Definition also schriftlich fest und ändern Sie sie nicht.
- Recruiter-Stunden pro Einstellung: die Zeit, die Recruiter für Vorauswahl, Terminplanung und Koordination aufwenden. Genau das versprechen Screening- und Terminplanungs-Tools zu verringern, messen Sie es also mit einer kurzen Zeiterfassungsstichprobe vorher und nachher.
- Bewerberabbruch: der Anteil der Bewerber, die in jeder Phase aussteigen. Wenn KI-Terminplanung Gespräche beschleunigt, der Abbruch in der Assessment-Phase aber steigt, haben Sie das Problem nur verschoben.
- Einstellungsqualität (Quality of Hire): ein Verbund aus Leistungsbewertung der neuen Mitarbeitenden, Verbleib nach 6 oder 12 Monaten und Zufriedenheit der einstellenden Führungskraft. Sie reift langsam, richten Sie sie also früh ein und rechnen Sie damit, sie ein Jahr später auszulesen.
- Angebotsannahmequote: ein schneller Indikator dafür, ob Bewerber ein gutes Erlebnis hatten.
Wie Screening-Tools die Scores hinter diesen Zahlen erzeugen, steht in KI-gestützte Lebenslauf-Vorauswahl.
2. HR-Service: Lösung, Anfragenvermeidung und Eskalation
Wenn Sie einen KI-Assistenten einsetzen, der Fragen von Beschäftigten zu Urlaub, Payroll, Benefits oder Richtlinien beantwortet, messen Sie ihn wie jeden Service Desk.
- Falllösungszeit: vom Öffnen bis zum Schließen des Tickets, aufgeteilt nach Falltyp.
- Lösung beim ersten Kontakt: der Anteil der Fragen, die beim ersten Mal vollständig beantwortet wurden, ohne Nachfrage.
- Anfragenvermeidung durch Self-Service (Deflection): der Anteil der Fragen, die der Assistent ohne Anlage eines Falls für einen Menschen gelöst hat. Deflection ist nur gut, wenn die Antwort stimmte, koppeln Sie sie also mit einer Stichprobenprüfung oder einer Bewertung „War das hilfreich?“ und einer Zählung wiederholter Kontakte zum selben Thema.
- Eskalationsquote: der Anteil, der an einen Menschen übergeben wird. Eine sehr niedrige Quote kann bedeuten, dass der Bot zu selbstsicher ist; eine sehr hohe, dass er nicht hilft.
- Fehlerquote: der Anteil der Antworten, die eine Prüfperson als falsch markiert. Ziehen Sie jede Woche eine feste Zahl an Stichproben, gewichtet auf sensible Themen wie Gehalt, Urlaub und Kündigung.
3. Mitarbeitererlebnis: Stimmung, Akzeptanz und Vertrauen
- Akzeptanz und Nutzung (Adoption): der Anteil der berechtigten Beschäftigten oder Führungskräfte, die das Tool in einem Monat nutzen, und wie viele wiederkommen. Geringe wiederholte Nutzung ist ein frühes Warnzeichen, dass das Tool nicht nützlich ist.
- Stimmung: eine Ein-Frage-Pulsbefragung nach einer Interaktion („Hat das Ihr Problem gelöst?“) funktioniert besser als eine vierteljährliche Umfrage, weil sie den Wert an das Tool bindet.
- eNPS oder Veränderung des Engagements: Verfolgen Sie sie, aber seien Sie ehrlich, dass vieles das Engagement bewegt. Vergleichen Sie Gruppen mit und ohne Tool, statt eine unternehmensweite Veränderung zu behaupten.
- Zeit der Führungskräfte für Verwaltung: Bei Tools, die Beurteilungen oder Stellenbeschreibungen entwerfen, ermitteln Sie per Stichprobe, wie lange die Aufgabe jetzt gegenüber früher dauert.
4. Risiko und Fairness: Verzerrung, Übersteuerungen und Fehler
Diese Familie ist diejenige, nach der Aufsichtsbehörden und Prüfer fragen, sie braucht also eigene Zahlen.
- Auswahlquote nach Gruppe und Impact Ratio (Verhältnis der Auswahlquoten): Berechnen Sie für jede Phase, in der ein Tool Menschen vorauswählt oder reiht, den Anteil jeder Gruppe, der weiterkommt, und teilen Sie dann die Quote jeder Gruppe durch die Quote der besten Gruppe. Die Bundesrichtlinie betrachtet ein Verhältnis unter vier Fünfteln (80 %) im Allgemeinen als Hinweis auf nachteilige Auswirkung, und sie sagt zugleich, dass sich das Bild mit der Stichprobengröße ändert: Eine größere Lücke bei kleinen Zahlen ist womöglich nicht signifikant, während eine kleinere Lücke zählen kann, wenn sie statistisch und praktisch signifikant ist (29 CFR 1607.4). Das Verhältnis ist ein Signal zur Untersuchung, kein Bestanden oder Durchgefallen.
- Übersteuerungsquote: wie oft eine Prüfperson die Empfehlung des Tools ändert. Nahe null kann bedeuten, dass Prüfende abnicken. Sehr hoch bedeutet, dass dem Tool nicht vertraut wird oder dass es nicht gut ist. Verfolgen Sie auch die Richtung der Übersteuerungen.
- Fehler- und Beschwerdequote: falsche Antworten, bei der Prüfung entdeckte zu Unrecht abgelehnte Bewerber und Beschwerden von Beschäftigten über das Tool.
- Prüfabdeckung: der Anteil nachteiliger Ergebnisse (etwa einer durch eine K.-o.-Regel ausgelösten Absage), den tatsächlich eine Person angesehen hat.
Wo Sie ein automatisiertes Tool bei Bewerbern in New York City einsetzen, verlangt das Gesetz ein Bias-Audit innerhalb eines Jahres vor der Nutzung, und die Stadt setzt es seit dem 5. Juli 2023 durch (NYC DCWP). In der EU ist Software zur Sortierung von Lebensläufen eine aufgeführte Hochrisiko-Anwendung, mit strengen Pflichten für Hochrisiko-Systeme ab dem 2. Dezember 2027 (Europäische Kommission). Dieses Datum stammt aus dem aktuellen Zeitplan nach den Änderungen durch das AI Omnibus, bestätigen Sie es also erneut, bevor Sie darauf planen. Wie die Audit-Seite mit der prüfenden Person zusammenhängt, steht in menschliche Aufsicht bei KI im HR.
Die Messtabelle
Kopieren Sie sie in Ihren Tracker und füllen Sie die Spalte „Baseline-Quelle“ vor dem Start aus.
| Kennzahl | Definition / Formel | Baseline-Quelle | So sieht gute Entwicklung aus | Worauf Sie achten sollten |
|---|---|---|---|---|
| Time-to-Fill | Tage von genehmigter Stellenanforderung bis zum angenommenen Angebot | ATS-Daten, letzte 4 bis 6 Quartale, nach Rollenfamilie | Sinkend, bei gleichbleibender oder steigender Einstellungsqualität | Einstellungsstopps, Saisonalität und neue Recruiter bewegen sie ebenfalls |
| Recruiter-Stunden pro Einstellung | Stunden für Vorauswahl, Terminplanung und Koordination pro besetzter Rolle | Zeitstichprobe über zwei Wochen oder Kalenderprüfung | Sinkend bei Verwaltungsaufgaben | Selbst berichtete Zeit ist zu optimistisch; ziehen Sie Stichproben |
| Bewerberabbruch nach Phase | Bewerber, die in einer Phase aussteigen / Bewerber, die in sie eintreten | ATS-Phasendaten | Gleichbleibend oder sinkend in jeder Phase | Schnellere frühe Phasen können den Abbruch nach hinten verschieben |
| Einstellungsqualität | Verbund aus Leistungsbewertung nach 6 oder 12 Monaten, Verbleib und Zufriedenheit der Führungskraft | Frühere Einstellungsjahrgänge | Gleichbleibend oder steigend gegenüber vergleichbaren Jahrgängen | Reift langsam; beurteilen Sie nicht im ersten Quartal |
| Lösung beim ersten Kontakt | Beim ersten Kontakt vollständig beantwortete Fragen / alle Fragen | Service-Desk-Tickets vor dem Start | Steigend | Falsche Antworten können trotzdem „gelöst“ aussehen |
| Anfragenvermeidung durch Self-Service | Ohne Fall für einen Menschen gelöste Fragen / alle Fragen | Fallvolumen pro 100 Beschäftigte vor dem Start | Das Fallvolumen sinkt und die Fehlerquote steigt nicht | Deflection ohne Genauigkeit ist verdecktes Scheitern |
| Eskalationsquote | An einen Menschen übergebene Fragen / alle Fragen | Chat- oder Ticket-Logs | Stabil und je Thema plausibel | Sehr niedrig kann Selbstüberschätzung bedeuten |
| Akzeptanz und wiederholte Nutzung | Monatliche Nutzer / berechtigte Nutzer und Anteil der Wiederkehrenden | Nutzungs-Logs des Tools | Steigend, mit wiederholter Nutzung | Einmalige Neugier sieht aus wie Akzeptanz |
| Puls der Beschäftigten nach Interaktion | Anteil, der „Ja, das hat es gelöst“ antwortet | Kurze Umfrage im Tool, ab dem Start | Hoch und stabil über Gruppen hinweg | Niedrige Rücklaufquoten verzerren das Ergebnis |
| Impact Ratio | Auswahlquote einer Gruppe / Auswahlquote der besten Gruppe, je Phase | Frühere Stellenanforderungen, die dieselbe Phase durchlaufen haben | Bei oder über 0,80, untersuchen, wenn darunter | Kleine Gruppen machen Verhältnisse sprunghaft; betrachten Sie die absoluten Zahlen |
| Übersteuerungsquote | Von einer Prüfperson geänderte Empfehlungen / alle geprüften | Protokoll der Prüfenden | Ungleich null, mit erklärten Gründen | Null Übersteuerungen können bedeuten, dass es keine echte Prüfung gibt |
| Fehlerquote | In einer wöchentlichen Stichprobe gefundene falsche Ergebnisse / Stichprobengröße | Bewertungsraster für Stichproben | Niedrig und sinkend | Die Stichprobe muss sensible Themen enthalten, nicht nur leichte |
Die meisten dieser Zellen stützen sich auf Daten, die Sie bereits haben. Falls nicht, ist das ein Problem der Datengrundlagen, das Sie beheben sollten, bevor Sie irgendetwas messen.
So richten Sie die Messung Schritt für Schritt ein
- Benennen Sie ein primäres Ergebnis pro Tool. Das Ergebnis eines Screeners könnten Recruiter-Stunden pro Einstellung sein. Das eines Chatbots die Lösung beim ersten Kontakt. Alles andere ist sekundär. Zu viele „Ziele“ bedeuten, dass Sie immer eines finden, das gut aussieht.
- Definieren Sie jede Kennzahl in einem Satz und frieren Sie sie ein. Wo beginnt die Uhr für die Time-to-Hire? Was zählt als „gelöst“? Wer die Definition mitten im Jahr ändert, zerstört den Vergleich.
- Erfassen Sie die Baseline vor dem Start. Ziehen Sie mindestens vier bis sechs Quartale Historie, aufgeteilt nach Rollenfamilie, Standort und Falltyp. Ist die Historie unordentlich, führen Sie einige Wochen lang eine kurze manuelle Messung durch. Halten Sie sie schriftlich fest.
- Fügen Sie wo immer möglich eine Vergleichsgruppe hinzu. Führen Sie das Tool zuerst in einer Region, einem Geschäftsbereich oder bei der Hälfte der Stellenanforderungen ein und behalten Sie den Rest als Vergleich. Wenn Sie randomisieren können, tun Sie es. Wenn nicht, gleichen Sie die Gruppen wenigstens nach Rolle, Seniorität und Saison ab. Das ist der wirksamste Weg, einen saisonalen Ausschlag nicht für ein Ergebnis zu halten.
- Nehmen Sie die Risikokennzahlen von Tag eins an auf. Richten Sie die Berechnung der Auswahlquote nach Gruppe und die wöchentliche Stichprobenprüfung beim Start ein, nicht nach der ersten Beschwerde.
- Legen Sie Prüfrhythmus und Verantwortliche fest. Monatliche operative Prüfung, vierteljährliche Prüfung durch die Führung und eine benannte verantwortliche Person für jede Kennzahl.
- Setzen Sie Schwellenwerte, die Maßnahmen auslösen. Zum Beispiel: Fällt die Impact Ratio für eine Gruppe in irgendeiner Phase unter 0,80, pausieren Sie den automatisierten Schritt und lassen Sie einen Menschen prüfen, bis es erklärt ist. Entscheiden Sie das, bevor Sie die Zahlen sehen.
- Übersetzen Sie Stunden in Entscheidungen, nicht in Dollar, es sei denn, es fließt Geld. Dazu gleich mehr.
- Berichten Sie Tempo, Qualität und Risiko auf einer Seite. Eine Führungskraft, die nur die Einsparungen sieht, optimiert auf sie.
Eingesparte Stunden sind kein eingespartes Geld
Das ist die häufigste Übertreibung in Berichten zu KI im HR. Spart ein Assistent jedem Recruiter drei Stunden pro Woche, haben Sie 3 Stunden Kapazität, keine Kostensenkung von 3 Stunden. Das Geld erscheint nur, wenn Sie mit dieser Kapazität etwas tun: Agentur- oder Überstundenkosten senken, eine geplante Einstellung vermeiden oder die Zeit auf Arbeit umlenken, die messbaren Output erzeugt (mehr Gespräche mit Bewerbern, schnellere Angebote, besseres Onboarding).
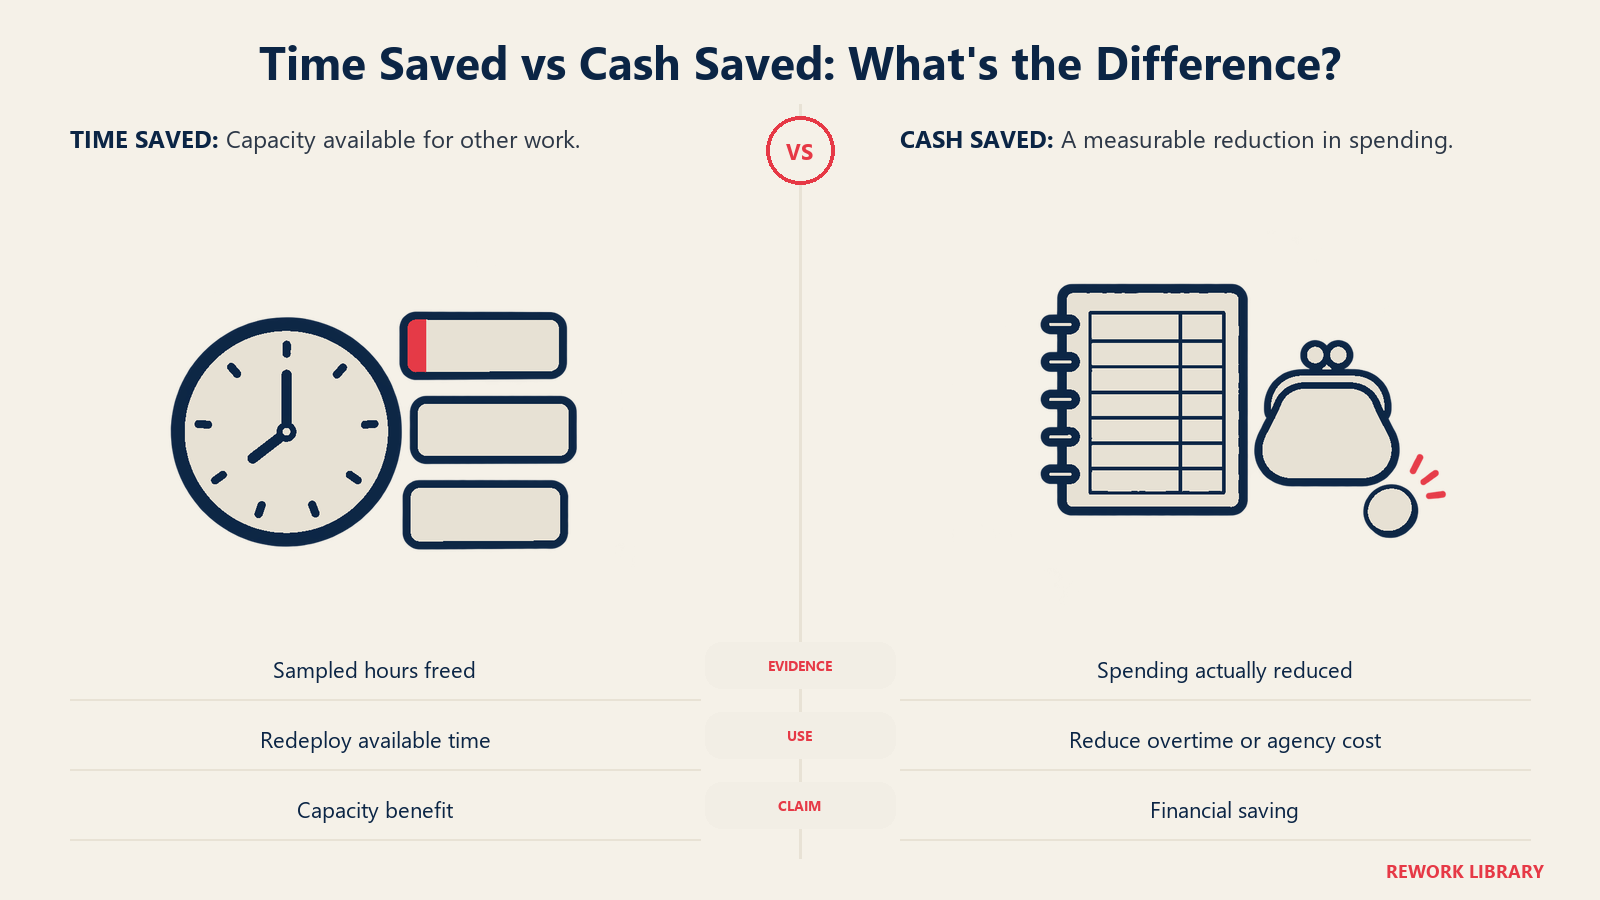
Berichten Sie also in zwei Zeilen. Erstens die freigewordenen Stunden, belegt durch eine Zeitstichprobe. Zweitens, was Sie damit getan haben und die daraus folgende Veränderung einer harten Zahl, falls es eine gibt. Wenn Sie Zeit freigesetzt und für nichts Messbares verwendet haben, sagen Sie das; es ist dennoch ein echter Vorteil, nennen Sie ihn aber Kapazität. Gesparte Zeit vs. Umsatzwirkung behandelt diese Unterscheidung für KI allgemein.
Zählen Sie auch die Kosten. Lizenzen, Integrationsarbeit, die Personen, die Ergebnisse prüfen, Audit-Gebühren und die Schulungszeit gehören auf die andere Seite der Bilanz. Ein Tool, das Recruitern 100 Stunden im Monat spart, aber 60 Stunden Prüfung braucht, ist ein kleinerer Gewinn, als es aussieht.
Beispiele nach HR-Funktion
| Funktion | Tool | Primäre Kennzahl | Begleitende Kennzahlen im Blick |
|---|---|---|---|
| Talent Acquisition | Lebenslauf-Screener | Recruiter-Stunden pro Einstellung | Impact Ratio je Phase, Übersteuerungsquote, Bewerberabbruch |
| Talent Acquisition | Assistent für Terminplanung von Gesprächen | Tage von der Freigabe des Gesprächs bis zum geplanten Gespräch | Bewerberabbruch, Angebotsannahmequote |
| HR Operations | Q&A-Assistent für Beschäftigte | Lösung beim ersten Kontakt | Fehlerquote in Stichprobenantworten, Eskalationsquote, wiederholte Kontakte |
| Onboarding | Assistent für die Onboarding-Checkliste | Tage bis zu den abgeschlossenen Onboarding-Aufgaben | Pulswert neuer Mitarbeitender, Rückfragen der Führungskraft |
| Lernen | Kursempfehlung | Abschluss empfohlener Kurse | Bewertung der Relevanz durch die Führungskraft, Akzeptanz und wiederholte Nutzung |
| Leistungsmanagement | Assistent zum Entwerfen von Beurteilungen | Zeit der Führungskraft pro Beurteilung | Wahrnehmung von Fairness bei Beschäftigten, Verteilung der Bewertungen nach Gruppe |
| Personalplanung | Tool für Einsatzplanung oder Prognose | Planänderungen pro Woche | Besetzungslücken, Überstunden, Beschwerden von Beschäftigten |
Beachten Sie, dass jede Zeile eine Einsparungskennzahl mit einer Qualitäts- oder Fairness-Begleitkennzahl koppelt. Diese Kopplung ist die Gewohnheit, die sich aufzubauen lohnt. Zur Analytik siehe People Analytics und KI, und für die Verzerrungsdimension speziell bei der Einstellung Verzerrung bei der Personalauswahl durch KI.
Häufige Fallstricke
- Mit dem Dashboard statt mit der Frage beginnen. Wählen Sie die Entscheidung, über die die Zahl informieren soll, und bauen Sie dann das Diagramm.
- Nur die Begeisterung der Pilotgruppe messen. Frühe Nutzer sind freundlicher als der durchschnittliche Beschäftigte. Beziehen Sie die ein, die sich nicht angemeldet haben.
- Einen Starmonat mit einem saisonalen Höhepunkt vergleichen. Vergleichen Sie Gleiches mit Gleichem, idealerweise im Jahresvergleich oder mit einer Parallelgruppe.
- Vom Anbieter gelieferte Kennzahlen als einzige Kennzahlen akzeptieren. Anbieter-Dashboards berichten, was der Anbieter ausgewählt hat. Ziehen Sie Ihre eigenen Zahlen aus Ihren eigenen Systemen.
- Die Vier-Fünftel-Zahl als rechtlichen sicheren Hafen behandeln. Sie ist ein Screening-Signal, und die Richtlinien selbst warnen vor kleinen Zahlen.
- Die Menschen ignorieren, die das Tool nicht erreicht. Kann ein Teil Ihrer Belegschaft den Assistenten nicht nutzen (etwa Schichtarbeitende ohne Zugang zu Geräten), schmeicheln die Akzeptanzkennzahlen dem Tool.
- Eine Kennzahl nie abschaffen. Wenn niemand danach handelt, streichen Sie sie. Eine kürzere Scorecard wird gelesen.

Senior Customer Retention Strategist
On this page
- Wichtige Fakten
- Warum die meisten Messungen von KI im HR scheitern
- Die vier Kennzahlenfamilien
- 1. Recruiting: Tempo, Qualität und Bewerbererlebnis
- 2. HR-Service: Lösung, Anfragenvermeidung und Eskalation
- 3. Mitarbeitererlebnis: Stimmung, Akzeptanz und Vertrauen
- 4. Risiko und Fairness: Verzerrung, Übersteuerungen und Fehler
- Die Messtabelle
- So richten Sie die Messung Schritt für Schritt ein
- Eingesparte Stunden sind kein eingespartes Geld
- Beispiele nach HR-Funktion
- Häufige Fallstricke