KI-Verzerrung bei der Personalauswahl: Ursachen und wie Sie sie prüfen
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
KI-Verzerrung bei der Personalauswahl ist ein systematischer Unterschied darin, wie ein automatisiertes Tool Bewerber aus verschiedenen Gruppen behandelt, verursacht durch die Daten, aus denen es gelernt hat, die Signale, die es nutzt, oder die Art seines Einsatzes, nicht durch irgendetwas, das die Bewerber getan haben. Sie sieht selten nach Vorurteil aus. Sie zeigt sich als Ranking, als Score oder als Ausschlussregel, die zufällig Männer häufiger durchlässt als Frauen oder jüngere Bewerber häufiger als ältere, und niemand bemerkt es, weil niemand gezählt hat.
Diese Seite richtet sich an HR-Direktoren, Leiter von Talent Acquisition und Unternehmensjuristen, die Screening- oder Assessment-Tools bereits nutzen oder bald kaufen. Sie erklärt, wo Verzerrung entsteht, wie Adverse Impact gemessen wird und wie Sie ein Audit durchführen, das Sie verteidigen können. Zum allgemeinen Konzept siehe Verzerrung (Bias) in KI. Speziell zum Screening siehe KI-Lebenslauf-Screening. Dies sind allgemeine Informationen, keine Rechtsberatung.
Wichtige Fakten
- Amazons experimentelle Recruiting-Engine bewertete Bewerber mit eins bis fünf Sternen, lernte aus Lebensläufen, die über 10 Jahre eingereicht wurden (die meisten von Männern), und wertete Lebensläufe mit dem Wort „women's“ ab; das Team wurde aufgelöst (Reuters, Oktober 2018).
- Nach den bundesweiten Uniform Guidelines gilt eine Auswahlquote unter vier Fünfteln (80 %) der Quote der höchsten Gruppe im Allgemeinen als Hinweis auf nachteilige Auswirkung (Adverse Impact), wobei auch kleinere Unterschiede zählen können (29 CFR 1607.4).
- iTutorGroup erklärte sich bereit, 365.000 $ zu zahlen, um eine Klage der EEOC beizulegen, die behauptete, die Bewerbungssoftware habe Frauen ab 55 und Männer ab 60 Jahren automatisch abgelehnt, betroffen waren mehr als 200 Bewerber (Duane Morris, August 2023).
- In einem Test der University of Washington mit drei Sprachmodellen wurden weiß assoziierte Namen in 85 % der Fälle bevorzugt, gegenüber 9 % bei schwarz assoziierten Namen, und schwarz-männlich assoziierte Namen wurden nie gegenüber weiß-männlich assoziierten Namen bevorzugt (University of Washington, Oktober 2024).
- Die Bias-Audit-Regel von New York City verlangt eine Impact Ratio für jede Kategorie nach Geschlecht, ethnischer Herkunft und deren Überschneidungen und untersagt den Einsatz eines Tools, wenn das letzte Audit mehr als ein Jahr zurückliegt (verabschiedete Regel des NYC DCWP).
Woher Verzerrungen in Recruiting-KI stammen
Verzerrung hat mehr als einen Eingang. Einen zu schließen, schließt die anderen nicht, und das ist die wichtigste Lehre aus den unten dokumentierten Fällen.
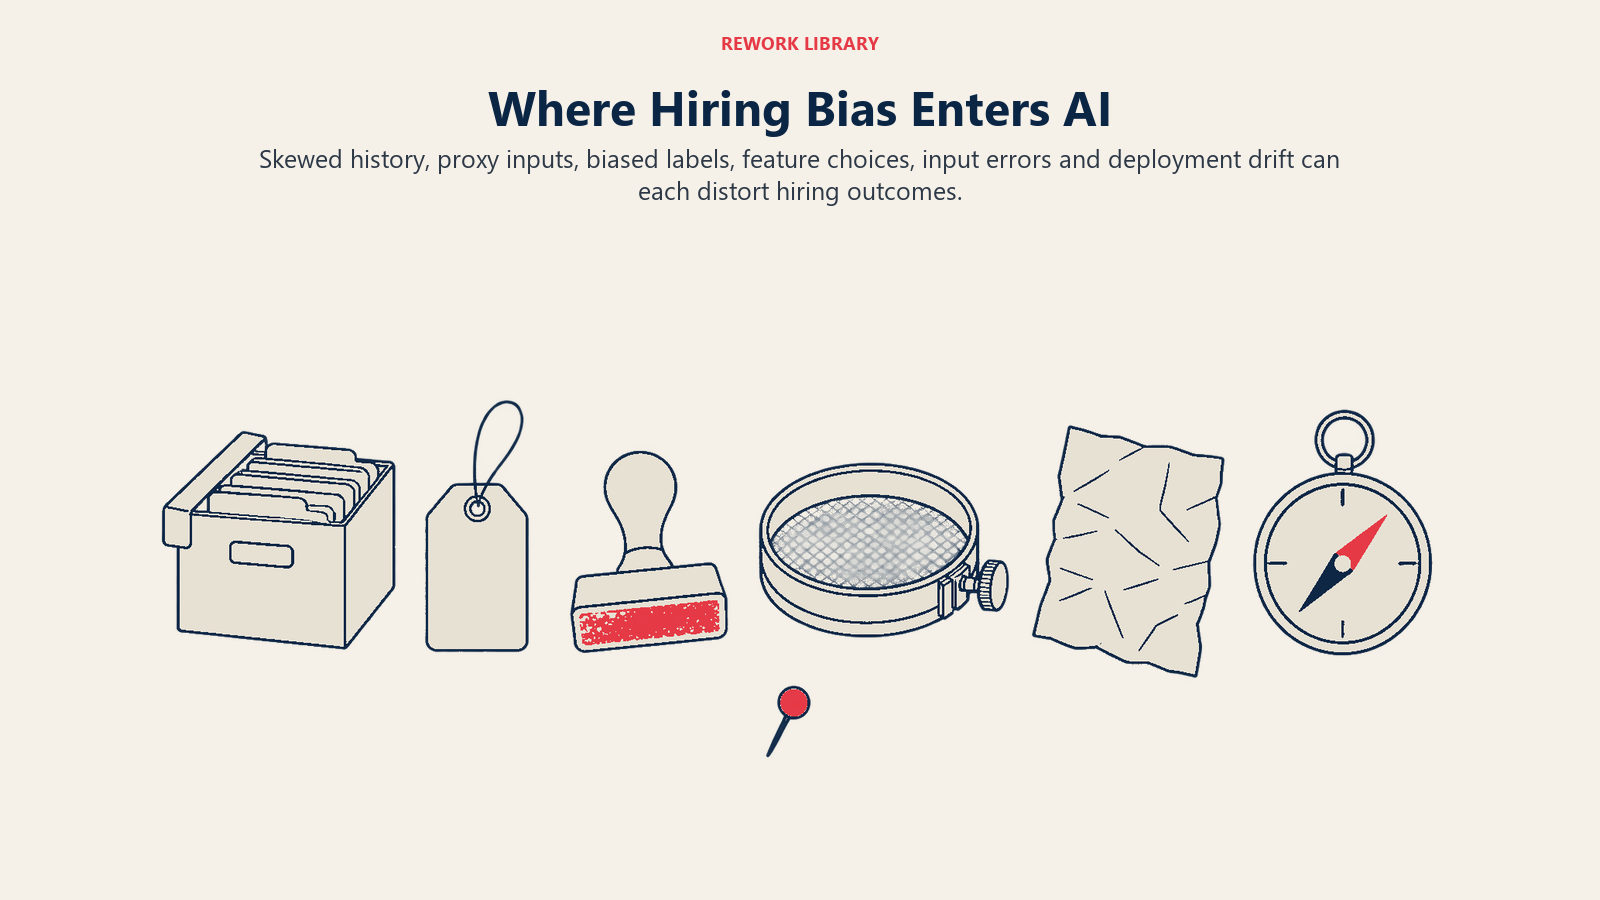
| Quelle | So wirkt sie | Beispiel aus dem Recruiting | Was Sie fragen oder prüfen sollten |
|---|---|---|---|
| Trainingsdaten | Das Modell lernt Muster aus früheren Einstellungen und Absagen, auch verzerrten | Ein Modell, das auf einem Jahrzehnt überwiegend männlicher Engineering-Einstellungen trainiert wurde, lernt, dass „sieht aus wie frühere Einstellungen“ männlich heißt | Auf welcher Historie wurde es trainiert, und wer war darin enthalten? |
| Proxy-Variablen | Ein neutral wirkender Input korreliert mit einem geschützten Merkmal | Postleitzahl, Abschlussjahr, Name, Vereinsmitgliedschaften, Lücken im Lebenslauf | Welche Inputs werden genutzt, und steht einer stellvertretend für Alter, ethnische Herkunft, Geschlecht oder Behinderung? |
| Label-Verzerrung | Der „Erfolg“, den das Modell vorhersagt, ist selbst ein verzerrtes Urteil | Die Vorhersage von „wurde eingestellt“ oder „bekam eine hohe Führungskraft-Bewertung“ übernimmt die Präferenzen früherer Entscheider | Welches Ergebnis sollte das Modell vorhersagen, und wer hat es definiert? |
| Merkmalsauswahl | Die von den Entwicklern gewählten Kriterien bevorzugen manche Gruppen | Einen Abschluss verlangen oder eine Karrierepause abwerten, obwohl die Rolle beides nicht braucht | Ist jedes Kriterium stellenbezogen und notwendig? |
| Messfehler | Inputs werden bei manchen Personen weniger genau erfasst | Parser, die unübliche Lebenslauf-Layouts oder nicht englische Namen durcheinanderbringen; Sprachtools, die Akzente falsch verstehen | Bleibt die Genauigkeit über Formate, Sprachen und Barrierefreiheitsbedarfe hinweg erhalten? |
| Einsatz-Drift | Das Tool wird nach dem Audit anders genutzt oder der Bewerberpool verschiebt sich | Ein auf eine Jobfamilie abgestimmter Filter wird für eine andere wiederverwendet; Kriterien werden ohne erneuten Test geändert | Wann wurde es zuletzt mit Ihren aktuellen Daten getestet? |
Zwei Punkte bringen viele Teams ins Straucheln. Erstens: Das Entfernen des geschützten Merkmals entfernt die Verzerrung nicht, denn das Modell kann es aus korrelierten Signalen rekonstruieren. Amazon passte seine Programme an, damit sie bestimmte geschlechtsbezogene Begriffe ignorieren, doch Beteiligte sagten Reuters, das gebe keine Garantie, dass das System nicht andere diskriminierende Wege fände, Bewerber zu sortieren (Reuters). Zweitens: Ein regelbasiertes Tool kann genauso verzerrt sein wie ein lernendes. Die Software von iTutorGroup war kein geheimnisvolles Modell; die EEOC warf dem Unternehmen vor, sie sei mit Altersgrenzen programmiert worden (Duane Morris).
Dokumentierte Fälle, die Sie kennen sollten
Amazons verworfenes Recruiting-Modell (2018)
Reuters berichtete, dass Amazons Team seit 2014 Programme zur Lebenslaufprüfung entwickelt hatte und 2015 feststellte, dass das System Bewerber für Softwareentwickler- und andere technische Rollen nicht geschlechtsneutral bewertete. Die Modelle wurden mit Lebensläufen trainiert, die über 10 Jahre eingereicht wurden, die meisten von Männern. Sie werteten Lebensläufe mit dem Wort „women's“ ab, und Amazon löste das Team später auf (Reuters). Recruiter sahen sich die Empfehlungen des Tools an, verließen sich laut dem Bericht aber nie allein auf dessen Rankings. Der Fall ist das Standardbeispiel für Label- und Trainingsdaten-Verzerrung.
EEOC und iTutorGroup (2023)
Die EEOC warf iTutorGroup vor, die Bewerbungssoftware für Tutoren so programmiert zu haben, dass sie Bewerberinnen über 55 und Bewerber über 60 ablehnte, und Anfang 2020 mehr als 200 qualifizierte Bewerber ab 55 Jahren nicht eingestellt zu haben. Das am 9. August 2023 eingereichte Consent Decree sah 365.000 $ für betroffene Bewerber vor, zu gleichen Teilen Schadenersatz und entgangenes Gehalt, und lief fünf Jahre mit Schulungen, Antidiskriminierungsrichtlinien und Überwachung durch die EEOC (Duane Morris). Hier handelte es sich um vorsätzliche unmittelbare Benachteiligung, die in Software codiert war, ein anderer Fehler als gelernte Verzerrung, und eine Erinnerung daran, dass Audits auch die Regeln lesen sollten.
Mobley v. Workday (anhängig)
Derek Mobley behauptet, er habe sich über Arbeitgeber, die die Plattform von Workday nutzen, auf mehr als 100 Stellen beworben und sei jedes Mal abgelehnt worden, und die KI-Tools von Workday benachteiligten ältere Bewerber. Am 16. Mai 2025 erteilte Richterin Rita Lin vom Northern District of California eine vorläufige Zertifizierung einer Sammelgruppe nach dem Age Discrimination in Employment Act, die Bewerber ab 40 Jahren umfasst, denen seit dem 24. September 2020 über die Plattform Beschäftigungsempfehlungen verweigert wurden; die gemeinsame Frage des Gerichts war, ob das Empfehlungssystem eine mittelbare Diskriminierung (Disparate Impact) gegenüber Bewerbern über vierzig bewirkt (Holland & Knight, Fisher Phillips). Workday sagt, die Klage sei unbegründet und die Zertifizierung nur vorläufig. Laut einem arbeitsrechtlichen Update von Mitte 2026 lief der Fall weiter, mit auf ethnische Herkunft und Behinderung ausgeweiteten Ansprüchen, wobei einige Ansprüche nach Landesrecht Ende Juni 2026 einen Abweisungsantrag überstanden und Workday eine Zwischenberufung gegen die Zertifizierungsentscheidung anstrebte (arbeitsrechtliches Update, Frühjahr 2026). In der Sache ist nichts entschieden, verstehen Sie den Fall also als Signal zur Rechtstheorie, nicht als Feststellung von Verzerrung. Die Theorie selbst ist für Käufer wichtig: Sie nimmt den Softwareanbieter ebenso in den Blick wie die Arbeitgeber, die ihn einsetzen.
Namens-Bias in Sprachmodellen (2024)
Forschende der University of Washington variierten ausschließlich die Vornamen (120 Namen, die mit weißen und schwarzen Männern und Frauen assoziiert werden) bei über 550 echten Lebensläufen, die gegen mehr als 500 Stellenanzeigen aus neun Berufsfeldern eingestuft wurden, mit drei Sprachmodellen und mehr als drei Millionen Vergleichen. Weiß assoziierte Namen wurden in 85 % der Fälle bevorzugt, schwarz assoziierte in 9 %; männlich assoziierte Namen in 52 % gegenüber 11 % bei weiblich assoziierten Namen; und schwarz-männlich assoziierte Namen wurden nie gegenüber weiß-männlich assoziierten Namen bevorzugt (University of Washington). Das war ein kontrollierter Forschungstest allgemeiner Modelle, kein Audit eines kommerziellen Recruiting-Produkts. Er zeigt, warum Sie Ihre eigene Konfiguration testen sollten, und warum der Hinweis der Forschenden, Verzerrung sei „nicht unbedingt sichtbar, wenn man ethnische Herkunft oder Geschlecht isoliert betrachtet“, für Prüfungen über Merkmalskombinationen hinweg spricht.
Nachteilige Auswirkung (Adverse Impact) und die Vier-Fünftel-Regel
Adverse Impact bedeutet, dass ein Auswahlverfahren eine Gruppe mit spürbar niedrigerer Quote weiterbringt als eine andere, ob das jemand beabsichtigt hat oder nicht. Die bundesweiten Uniform Guidelines werten eine Auswahlquote einer Gruppe, die unter vier Fünfteln (80 %) der Quote der Gruppe mit der höchsten Quote liegt, im Allgemeinen als Hinweis auf Adverse Impact und eine höhere Quote im Allgemeinen nicht. Sie sagen auch, dass kleinere Unterschiede weiterhin Adverse Impact sein können, wenn sie statistisch und praktisch bedeutsam sind, und dass größere Abstände, die auf kleinen Zahlen beruhen, möglicherweise nicht zählen. Von Arbeitgebern wird erwartet, Aufzeichnungen zu führen, die die Wirkung ihrer Verfahren nach Geschlecht und nach ethnischer Gruppe zeigen (29 CFR 1607.4).
Eine Beispielrechnung mit erfundenen Zahlen:
| Gruppe | Bewerber | Weitergekommen | Auswahlquote | Impact Ratio |
|---|---|---|---|---|
| Gruppe A (höchste) | 200 | 100 | 50 % | 1,00 |
| Gruppe B | 150 | 60 | 40 % | 0,80 |
| Gruppe C | 100 | 35 | 35 % | 0,70 |
Die Quote von 0,70 bei Gruppe C liegt unter 0,80, das ist Ihr Anlass zur Untersuchung. Gruppe B liegt genau auf der Linie, was zeigt, warum die Schwelle ein Screening-Signal und kein Urteil ist. Bei kleinen Gruppen verschieben schon wenige Einstellungen die Quote erheblich, kombinieren Sie sie daher mit einem Signifikanztest und betrachten Sie Daten über mehrere Monate.
So prüfen Sie ein Recruiting-Tool per Audit
Die Regel von New York City bietet die klarste veröffentlichte Vorlage und ist auch nützlich, wenn sie für Sie nicht gilt. Sie verlangt, dass das Audit für jede Kategorie die Auswahlquote und die Impact Ratio (das Verhältnis der Auswahlquoten) berechnet, definiert als Auswahlquote einer Kategorie geteilt durch die der am häufigsten ausgewählten Kategorie. Bei Tools, die Scores erzeugen, nutzt sie auf dieselbe Weise eine Scoring-Quote (den Anteil mit einem Score über dem Median der Stichprobe). Die Berechnungen müssen getrennt für Geschlechterkategorien, Kategorien nach ethnischer Herkunft und überschneidende Kategorien aus Geschlecht, Ethnie und Herkunft durchgeführt werden, und das Audit muss berichten, wie viele Personen in eine unbekannte Kategorie fielen. Ein unabhängiger Prüfer darf eine Kategorie unter 2 % der Daten auslassen, wenn die Zusammenfassung erklärt, warum, und die Zahlen dieser Kategorie nennt (verabschiedete Regel des NYC DCWP).
Eine Routine, Schritt für Schritt
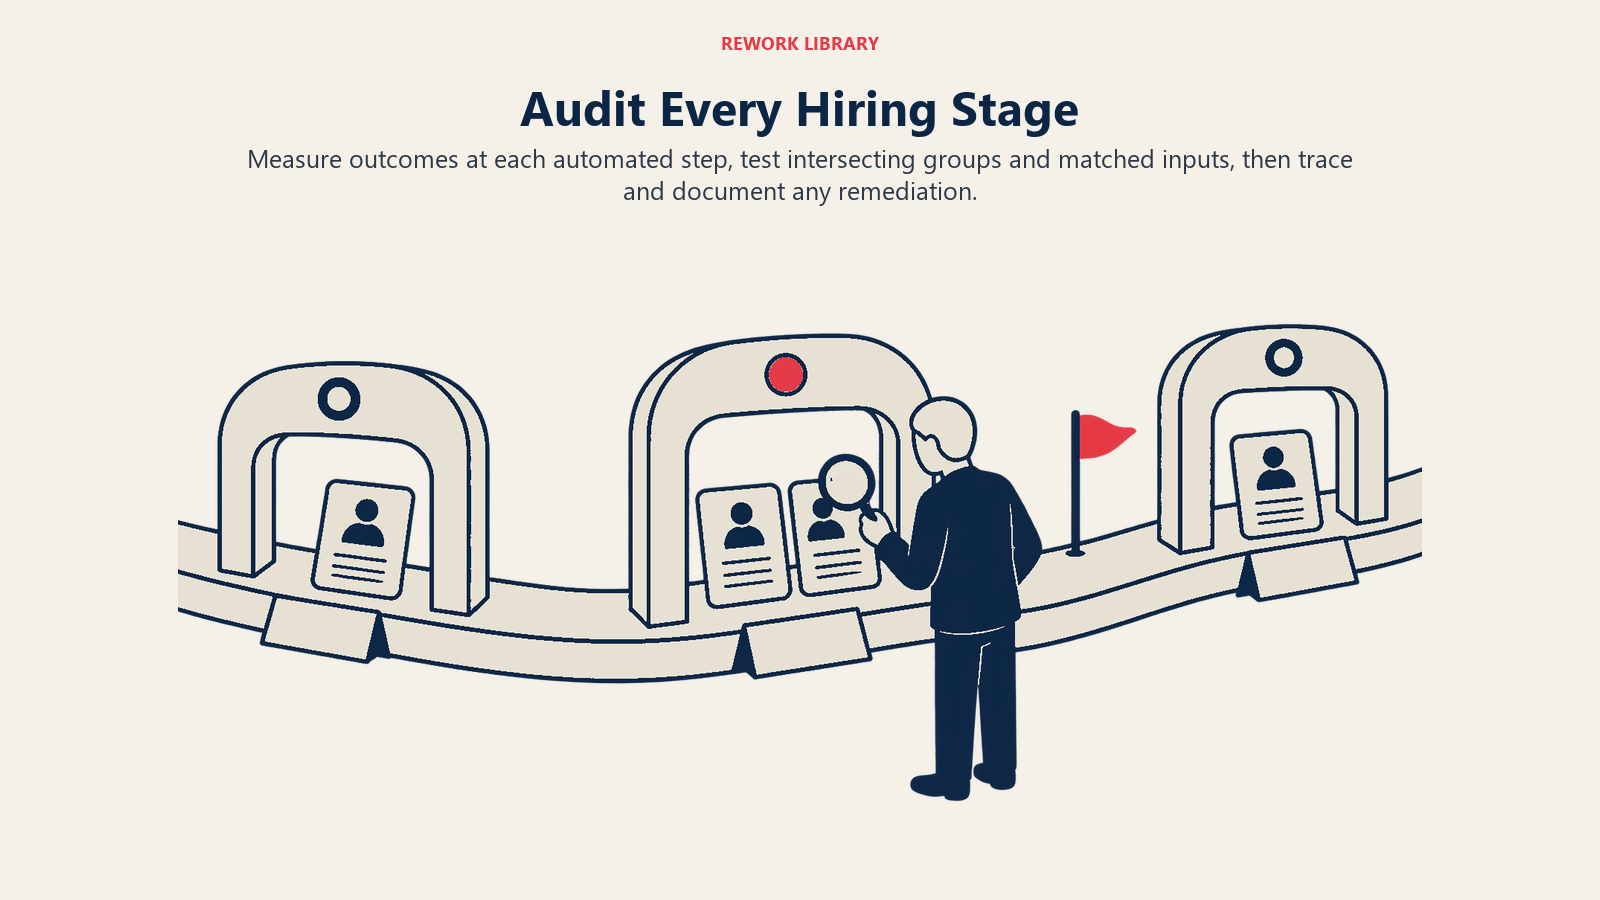
- Listen Sie jeden automatisierten Schritt auf. Parsing, Ranking, Ausschlussfragen, Assessments, Chat-Screener, Interview-Scoring. Verzerrung kann in jedem davon sitzen. Zu den Stufen jenseits von Lebensläufen siehe KI-gestützte Eignungsdiagnostik vor der Einstellung und KI in Vorstellungsgesprächen.
- Definieren Sie die Entscheidung in jedem Schritt. „Weiterkommen“, „ablehnen“, „Score über dem Median“. Sie können nur messen, was Sie definiert haben.
- Erheben Sie Ergebnisdaten nach Gruppen. Sie brauchen Bewerberzahlen und Zahlen der Weitergekommenen nach Geschlecht, ethnischer Herkunft und Altersband, mit einer Kategorie „unbekannt“. Saubere Inputs sind hier wichtig, beginnen Sie daher mit den HR-Datengrundlagen für KI.
- Berechnen Sie Impact Ratios in jeder Stufe, nicht nur bei der Einstellung. Eine faire Angebotsquote am Ende kann einen verzerrten Filter früh im Funnel verbergen.
- Testen Sie Überschneidungen. Männer gegenüber Frauen und schwarze gegenüber weißen Bewerbern können beide akzeptabel aussehen, während schwarze Frauen oder ältere Frauen es nicht tun.
- Testen Sie mit abgeglichenen Inputs. Reichen Sie identische Lebensläufe ein, die sich nur in Name, Pronomen, Abschlussjahr oder Adresse unterscheiden, und prüfen Sie, ob sich das Ergebnis ändert. So erfassen Sie Proxy-Effekte, die aggregierte Zahlen übersehen können.
- Prüfen Sie jeden Input auf Relevanz. Dokumentieren Sie für jedes Merkmal, warum es stellenbezogen und notwendig ist, und streichen Sie die, die in Wahrheit Proxys sind.
- Prüfen Sie Absagen, nicht nur Auswahlen. Ziehen Sie jede Woche eine Stichprobe aus dem Stapel der niedrig Eingestuften, mit einer Person, die das Tool übersteuern kann (Human-in-the-Loop).
- Legen Sie fest, wer das Ergebnis verantwortet. HR rechnet, Recht interpretiert, und eine benannte Führungskraft zeichnet jede Abhilfe ab.
- Wiederholen Sie es nach Plan und nach jeder Änderung. Neue Kriterien, neue Jobfamilien oder ein Modell-Update des Anbieters setzen die Uhr zurück.
Was zu tun ist, wenn eine Quote durchfällt
Kalibrieren Sie die Ausgabe nicht einfach so nach, dass 80 % erreicht werden. Finden Sie zuerst die Ursache. Führen Sie die Lücke auf einen bestimmten Input, ein Label oder einen Schritt zurück und erwägen Sie dann weniger diskriminierende Alternativen, die denselben geschäftlichen Bedarf erfüllen, etwa ein Proxy-Merkmal zu streichen, eine Abschlussanforderung durch einen Skills-Test zu ersetzen oder aus einem Ausschluss eine menschliche Prüfung zu machen. Dokumentieren Sie, was Sie gefunden und geändert haben. Zur übergeordneten Routine siehe menschliche Aufsicht bei KI im HR-Bereich.
Der rechtliche Rahmen in Kürze
Die Regeln unterscheiden sich je nach Ort und ändern sich, bestätigen Sie die aktuellen Anforderungen daher mit Ihrer Rechtsberatung. Einen ausführlicheren Überblick bieten die Gesetze zu KI bei der Personalauswahl.
- New York City. Local Law 144 untersagt den Einsatz eines automatisierten Einstellungsentscheidungs-Tools ohne ein Bias-Audit innerhalb des vorangegangenen Jahres und ohne öffentliche Zusammenfassung, und das Department of Consumer and Worker Protection begann am 5. Juli 2023 mit der Durchsetzung (NYC DCWP). Die Regel setzt keine Bestanden/Durchgefallen-Schwelle; sie verlangt, dass die Quoten berechnet und veröffentlicht werden.
- Illinois. HB 3773, am 9. August 2024 unterzeichnet und seit 1. Januar 2026 in Kraft, ändert den Illinois Human Rights Act so, dass es rechtswidrig ist, KI einzusetzen, die geschützte Gruppen diskriminierend betrifft, oder Postleitzahlen als Proxy für sie zu nutzen, und verlangt eine Mitteilung, wenn KI für Beschäftigungsentscheidungen eingesetzt wird. Das Illinois Department of Human Rights soll die Regeln zur Mitteilung festlegen (DLA Piper).
- Haltung der Bundesbehörden bei der Durchsetzung. Executive Order 14281, am 23. April 2025 unterzeichnet, formuliert als Politik, die Haftung für mittelbare Diskriminierung (Disparate Impact) „im größtmöglichen Maße“ zu beseitigen, und weist Behörden an, die Durchsetzung damit verbundener Gesetze und Vorschriften nachrangig zu behandeln (Compilation of Presidential Documents, GovInfo). Eine Anordnung ändert weder die Gesetze noch die Rechtsprechung, und private Kläger und Landesrecht bleiben verfügbar, genau der Weg, den Mobley geht.
Häufige Fallstricke
- Nur die Endeinstellung prüfen. Die Schieflage sitzt oft im ersten Filter.
- Die Vier-Fünftel-Quote als sicheren Hafen behandeln. 0,80 bei kleinen Zahlen zu erreichen, beweist wenig; sie zu verfehlen, ist ein Grund hinzuschauen, kein Beweis für Rechtswidrigkeit.
- Sich allein auf das Audit des Anbieters verlassen. Es deckt die Daten des Anbieters ab, nicht Ihre Jobfamilien oder Ihren Bewerberpool.
- Einen Proxy entfernen und es für behoben erklären. Korrelierte Signale füllen die Lücke.
- Keine demografischen Daten erheben. Ohne sie können Sie nichts messen, und die Uniform Guidelines erwarten Aufzeichnungen nach Gruppen. Gehen Sie sorgfältig damit um und trennen Sie sie von der Einstellungsentscheidung.
- Rankings zu Entscheidungen werden lassen. Prüfer lesen den Listenanfang und hören auf.
- Erneute Tests auslassen. Ein Tool, das beim Start bestanden hat, kann driften, wenn sich Kriterien und Bewerberpools ändern.

Senior Customer Retention Strategist
On this page
- Wichtige Fakten
- Woher Verzerrungen in Recruiting-KI stammen
- Dokumentierte Fälle, die Sie kennen sollten
- Amazons verworfenes Recruiting-Modell (2018)
- EEOC und iTutorGroup (2023)
- Mobley v. Workday (anhängig)
- Namens-Bias in Sprachmodellen (2024)
- Nachteilige Auswirkung (Adverse Impact) und die Vier-Fünftel-Regel
- So prüfen Sie ein Recruiting-Tool per Audit
- Eine Routine, Schritt für Schritt
- Was zu tun ist, wenn eine Quote durchfällt
- Der rechtliche Rahmen in Kürze
- Häufige Fallstricke