Como a IA Está Mudando o Trabalho: O Que a Evidência Realmente Mostra
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
A IA está mudando de forma mensurável tarefas específicas dentro de funções específicas, e não funções inteiras de uma só vez. Estudos controlados mostram ganhos reais de produtividade em contextos restritos (suporte ao cliente, programação, redação), que variam conforme o nível de habilidade e às vezes se contradizem. A adoção nas empresas é alta; o impacto financeiro medido não é. Afirmações de mais longo prazo sobre perda de empregos ou automação de tarefas são previsões de pesquisadores identificados que usam métodos declarados, e não fatos observados, e devem ser lidas assim.
A maior parte do que se escreve sobre IA e trabalho cai em um de dois erros: tratar a demonstração de um fornecedor como prova de uma mudança no mercado de trabalho, ou tratar a previsão de uma consultoria como se já tivesse acontecido. Este artigo separa o que foi de fato medido, em estudos controlados com métodos publicados, do que as pessoas estão prevendo, e diz quem faz a previsão e como.
Fatos principais
- Um estudo liderado por Stanford com 5.179 agentes de suporte ao cliente constatou que a assistência de IA generativa elevou a produtividade em 14% em média, com ganho de 34% para agentes novatos e efeito quase nulo para os experientes. NBER working paper 31161
- Um ensaio controlado randomizado constatou que usuários do GitHub Copilot concluíram uma tarefa de programação 55,8% mais rápido do que um grupo de controle. arXiv 2302.06590
- Um ensaio randomizado da METR, de 2025, com desenvolvedores experientes de código aberto constatou que as ferramentas de programação com IA os deixaram 19% mais lentos em tarefas reais, embora os desenvolvedores acreditassem estar 20% mais rápidos. METR, julho de 2025
- Um estudo da Science com 453 profissionais constatou que o ChatGPT reduziu em 40% o tempo das tarefas de redação e elevou a qualidade em 18%, com os maiores ganhos para quem escrevia pior. Science, DOI 10.1126/science.adh2586
- A pesquisa State of AI 2025 da McKinsey constatou que 88% das organizações usam IA em pelo menos uma função, mas apenas cerca de 6% relatam usá-la de maneiras que geram valor significativo para toda a empresa. McKinsey, State of AI
- O Project NANDA do MIT constatou que 95% dos pilotos de IA generativa nas empresas estudadas não mostraram impacto mensurável no resultado financeiro, apesar de dezenas de bilhões em gastos corporativos. Fortune, agosto de 2025
- O Future of Jobs Report 2025 do Fórum Econômico Mundial prevê 170 milhões de empregos criados e 92 milhões deslocados até 2030, um ganho líquido de 78 milhões, com base em pesquisas com empregadores. WEF, janeiro de 2025
- A Gartner prevê que mais de 40% dos projetos de IA agêntica serão cancelados até o fim de 2027 por causa de custo, valor pouco claro e controles de risco fracos. Gartner via RCR Wireless
O Que "a IA Mudando o Trabalho" Realmente Significa
Tire a embalagem e a afirmação por baixo da maioria dos conteúdos sobre IA e trabalho é simples: a IA generativa, capaz de redigir, resumir, programar e responder perguntas, ficou barata e boa o bastante para que as pessoas a usem dentro de funções reais, e não só em demonstrações. Isso tem três camadas separadas e testáveis, e misturá-las é onde começa a maior parte das análises ruins.
A primeira camada é o efeito no nível da tarefa: uma tarefa específica, feita com ajuda de IA, fica mais rápida, melhor ou mais barata? Essa camada tem a evidência mais rigorosa, porque é pequena o bastante para rodar um ensaio randomizado. A segunda camada é o efeito no nível da função: uma função inteira muda de formato, encolhe ou desaparece? Isso é mais difícil de medir diretamente e costuma ser inferido a partir de dados de contratação e anúncios de vagas. A terceira camada é o efeito no nível da economia: emprego agregado, salários, produtividade. É a camada em que as previsões operam e a que tem menos evidência direta, porque a mudança ainda é recente e os dados chegam com anos de atraso.
Manter essas camadas separadas importa porque uma afirmação verdadeira em uma delas (a IA tornou esta tarefa de programação 55% mais rápida num ensaio) é esticada até virar uma afirmação de aparência falsa em outra (a IA está substituindo engenheiros de software) sem que ninguém mostre como um ganho no nível da tarefa se soma a um no nível da função. Os modelos de trabalho baseados em tarefas do economista David Autor são o guia mais claro aqui: funções são pacotes de tarefas, e automatizar algumas delas costuma mudar a função em vez de eliminá-la, pelo menos no curto prazo.
A Evidência Medida: O Que os Estudos Controlados Encontraram
Suporte ao Cliente: O Estudo do Call Center de Stanford
O estudo empírico mais citado sobre IA generativa e trabalho de linha de frente vem de Erik Brynjolfsson, Danielle Li e Lindsey Raymond, publicado como working paper do NBER e associado ao Digital Economy Lab de Stanford. Os pesquisadores acompanharam a implantação escalonada de um assistente de IA generativa para 5.179 agentes de suporte ao cliente em uma empresa de software, oferecendo-lhes sugestões de resposta em tempo real durante chats ao vivo.
O número principal é um aumento médio de 14% nos problemas resolvidos por hora depois que os agentes passaram a ter acesso à ferramenta. Mas a média esconde a descoberta mais interessante: agentes novatos e de menor habilidade tiveram um ganho de produtividade de 34%, enquanto os agentes mais experientes quase não tiveram benefício mensurável. Os agentes seguiram as sugestões da ferramenta em apenas cerca de 38% das vezes, em média, um padrão de human-in-the-loop em que a ferramenta funcionou menos como piloto automático e mais como um coach sempre disponível, em quem o agente podia confiar ou que podia ignorar. O estudo também encontrou melhora no sentimento dos clientes e maior retenção de agentes, e os autores argumentam que o mecanismo é que o modelo de IA destilou os padrões de conversa dos melhores agentes da empresa e os disponibilizou em tempo real para todos os demais, uma versão da calibração de confiança que todo workflow de humanos com IA acaba tendo de resolver.
Vale parar nesse ponto. Este não foi um estudo da IA substituindo agentes. Foi um estudo da IA comprimindo a distância entre os melhores e os piores profissionais de uma empresa, transferindo um conhecimento tácito que antes exigia anos no cargo ou um bom mentor.
Programação: Dois Ensaios, Dois Anos Diferentes, Duas Respostas Diferentes
A evidência sobre programação é onde "a IA mudando o trabalho" se torna realmente disputada: dois ensaios randomizados confiáveis apontam em direções opostas, e a diferença é informativa, e não uma contradição a ser descartada.
Sida Peng e coautores conduziram um ensaio randomizado em que desenvolvedores deviam construir um servidor HTTP em JavaScript o mais rápido possível. O grupo de tratamento, usando o GitHub Copilot, terminou 55,8% mais rápido do que o grupo de controle, com intervalo de confiança de 95% entre 21% e 89%. Desenvolvedores menos experientes e os que programavam mais horas por dia se beneficiaram mais, o mesmo viés em favor dos trabalhadores menos experientes visto no estudo de suporte ao cliente.
Depois, em meados de 2025, o grupo de pesquisa sem fins lucrativos METR conduziu um tipo diferente de ensaio randomizado: não uma tarefa nova criada para isolar uma variável, mas o trabalho real de desenvolvedores experientes de código aberto em suas próprias bases de código, usando as ferramentas baseadas em modelos de linguagem de grande escala que eles mesmos escolheram. O resultado: os desenvolvedores ficaram 19% mais lentos com a assistência da IA, e não mais rápidos, apesar de terem previsto antes que a IA os aceleraria em 24% e de acreditarem depois que os havia acelerado em 20%. A distância entre a crença e a realidade medida foi a descoberta mais marcante do estudo.
Não são o mesmo experimento, e é esse o ponto. O ensaio de Peng mediu uma tarefa delimitada e desconhecida, em que a IA compensa a falta de conhecimento prévio. O ensaio da METR mediu desenvolvedores experientes em um trabalho familiar e de alto contexto, em que revisar e corrigir as sugestões da IA pode custar mais tempo do que escrever o código diretamente. Lidos em conjunto, os estudos sugerem que a ajuda da IA em programação funciona melhor quando substitui um conhecimento que o desenvolvedor não tem, e pode atrasar especialistas quando substitui um conhecimento que eles já possuem. É uma afirmação mais útil e falseável do que "a IA torna os desenvolvedores mais rápidos" ou "a IA torna os desenvolvedores mais lentos".
Redação e Trabalho do Conhecimento: O Experimento de Noy e Zhang
Shakked Noy e Whitney Zhang conduziram um experimento randomizado com 453 profissionais com formação universitária fazendo tarefas de redação específicas de suas ocupações, metade deles com acesso ao ChatGPT, publicado na Science em 2023. O tempo gasto nas tarefas caiu cerca de 40%, e as notas de avaliadores independentes para a qualidade do resultado subiram cerca de 18%. Os ganhos de produtividade foram fortemente concentrados nos trabalhadores que tiveram a menor pontuação na tarefa sem ajuda da IA, ou seja, a ferramenta reduziu a distância de desempenho entre bons e maus redatores em vez de ampliá-la.
O estudo também documentou algo que as previsões raramente mencionam: o que o ChatGPT de fato substituiu foi o esforço do trabalhador na redação do rascunho, e não o julgamento do trabalhador. O tempo da tarefa migrou para a geração de ideias, a estruturação e a edição, e saiu do primeiro rascunho em página em branco. Os trabalhadores também relataram maior satisfação no trabalho junto com mais preocupação com a automação, um lembrete útil de que ganhos de produtividade e ansiedade dos trabalhadores não são reações mutuamente excludentes à mesma ferramenta.
Resultados Medidos em Resumo
| Estudo | Contexto | Resultado medido | O que prova | O que NÃO prova |
|---|---|---|---|---|
| Brynjolfsson, Li, Raymond (NBER/Stanford) | 5.179 agentes de suporte ao cliente, implantação real | +14% de problemas resolvidos por hora em média; +34% para novatos; ~0% para especialistas | A assistência de IA pode transferir o know-how de especialistas para trabalhadores novatos em uma tarefa específica e acompanhada | Que o efeito se mantém fora do suporte por chat, ou escala do mesmo modo em outras funções de serviço |
| Peng et al., ensaio randomizado do GitHub Copilot | Tarefa de programação delimitada, favorável a novatos | Conclusão 55,8% mais rápida com o Copilot | A ajuda da IA em programação pode acelerar muito uma tarefa delimitada e desconhecida | Que desenvolvedores experientes em bases de código complexas e familiares obtêm o mesmo ganho |
| METR, ensaio randomizado com desenvolvedores, 2025 | Desenvolvedores experientes de código aberto, repositórios reais | 19% mais lentos com ferramentas de IA; os desenvolvedores acreditavam estar 20% mais rápidos | Velocidade percebida e velocidade medida podem apontar em direções opostas no trabalho de especialistas | Que as ferramentas de programação com IA são negativas para todos os desenvolvedores ou para todos os tipos de tarefa |
| Noy & Zhang, Science 2023 | 453 profissionais, tarefas de redação | -40% de tempo, +18% de qualidade; maiores ganhos para redatores mais fracos | A IA generativa pode reduzir diferenças de desempenho e realocar esforço do rascunho para a edição | Que os ganhos persistem para redatores especialistas, ou se sustentam em escala numa semana de trabalho inteira |
A Adoção É Alta. O Impacto Medido É Irregular. Essa Distância Tem um Nome.
Se os estudos no nível da tarefa mostram algo real, porém estreito, as pesquisas com empresas mostram algo amplo, porém nebuloso, e os dois ainda não se encaixam com clareza.
McKinsey: Adoção Sem Transformação
A pesquisa State of AI 2025 da McKinsey constatou que 88% das organizações agora usam IA regularmente em pelo menos uma função de negócio, ante 78% no ano anterior. Mas o mesmo relatório constatou que apenas cerca de um terço das empresas passou de pilotos dispersos para o uso em escala, e que aproximadamente 6% se qualificam como verdadeiras de alto desempenho, capturando valor significativo da IA para toda a empresa. Separadamente, 47% das organizações relataram pelo menos uma consequência negativa do uso de IA generativa, seja uma falha de precisão, um problema de compliance ou uma quebra de workflow, o tipo de lacuna que os programas de governança de IA existem para fechar. A adoção, em outras palavras, ultrapassou tanto a supervisão quanto o retorno mensurável na maioria das empresas, mesmo se tornando quase universal no nível do "usamos isso em algum lugar".
MIT NANDA e a Divisão da GenAI
A versão mais crua dessa lacuna vem do Project NANDA do MIT, cujo relatório de julho de 2025 analisou mais de 300 implantações públicas de IA, 52 entrevistas estruturadas e 153 pesquisas com líderes. A conclusão principal: apesar de uma estimativa de $30 a $40 bilhões em gastos corporativos com IA generativa, 95% dos pilotos não produziram impacto mensurável no resultado financeiro. A descoberta mais útil está por baixo da manchete. Comprar ferramentas de IA de fornecedores especializados teve sucesso cerca do dobro de vezes em relação a construir IA sob medida internamente, e os maiores retornos realizados apareceram na automação discreta de back-office, e não nos casos de uso de vendas e marketing que receberam a maior parte do orçamento. Os pesquisadores descrevem o obstáculo central como uma "lacuna de aprendizado": ferramentas que não se adaptam ao contexto de um workflow específico raramente pegam, seja qual for a capacidade do modelo subjacente.
Lidos em conjunto, McKinsey e MIT NANDA descrevem o mesmo fenômeno por ângulos diferentes: uma adoção ampla e rasa que ainda não se tornou uma transformação profunda e medida. Isso não é evidência de que a IA não funciona; os estudos no nível da tarefa acima mostram com clareza que pode funcionar. É evidência de que a maioria das empresas não fez o trabalho de integração para converter uma ferramenta capaz em um resultado medido, o atalho que o débito cultural de IA descreve, e acompanha a forma como o trabalho sobre cultura AI-native enquadra ser dono de uma ferramenta versus operá-la bem.
O Que as Previsões Afirmam, Quem as Faz e Como
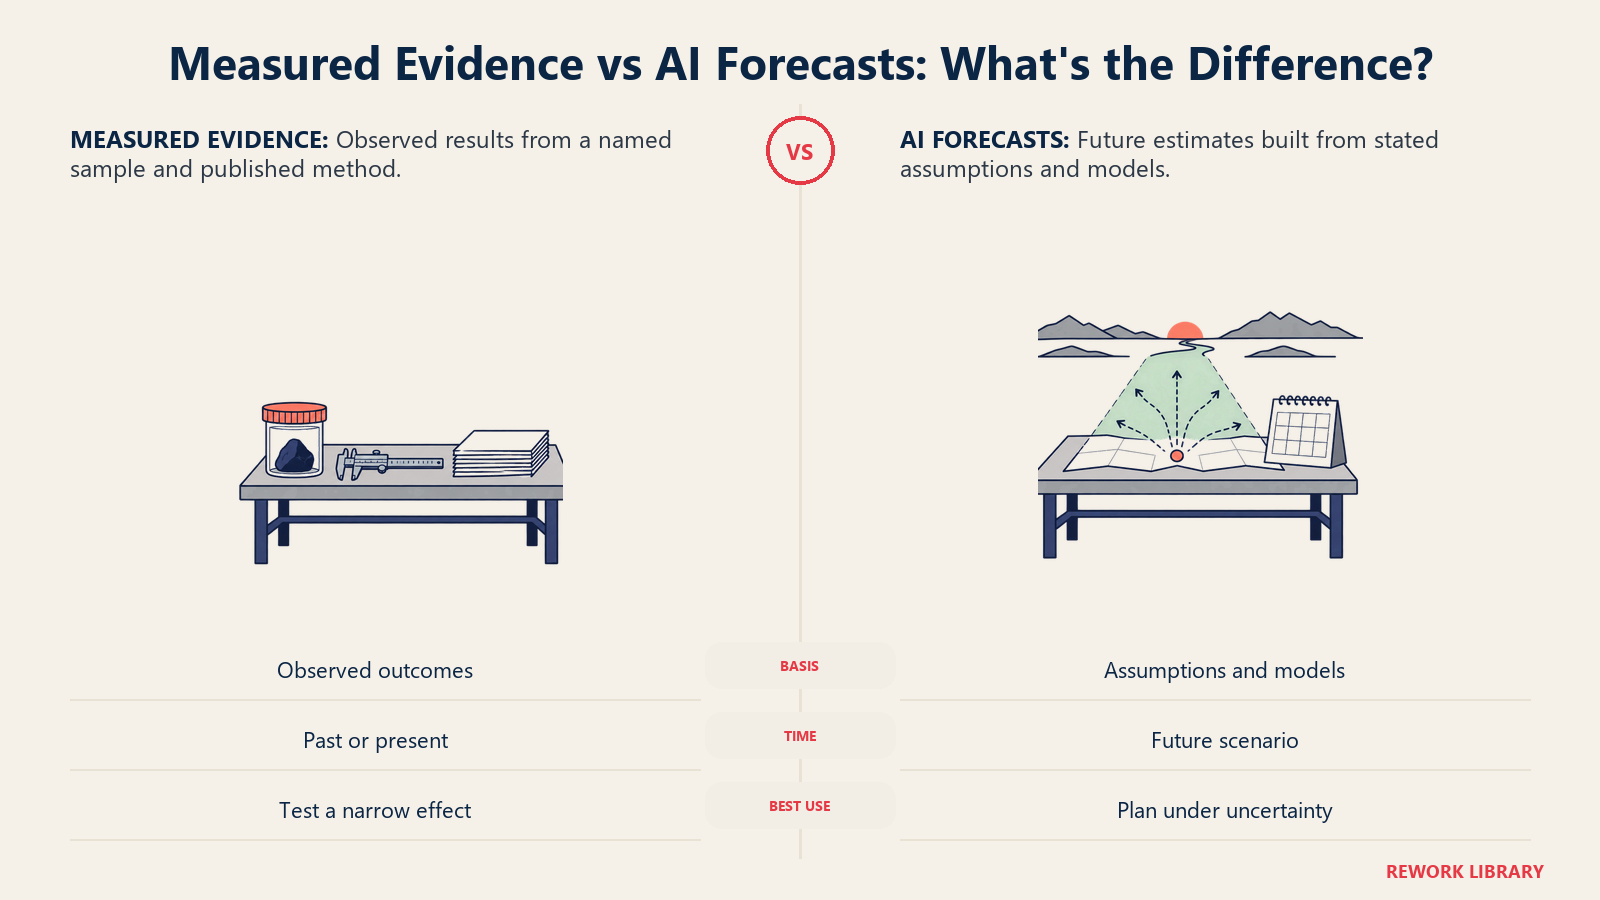
Tudo acima é medição: algo aconteceu, os pesquisadores registraram e o método é publicado e verificável. As previsões são uma categoria totalmente diferente, e as duas mais citadas nos textos sobre o futuro do trabalho merecem ser tratadas como afirmações com autores e métodos, e não repetidas como fato consolidado.
WEF Future of Jobs: Uma Pesquisa sobre as Expectativas dos Empregadores
O Future of Jobs Report 2025 do Fórum Econômico Mundial projeta 170 milhões de novos empregos e 92 milhões de funções deslocadas até 2030, um ganho líquido de 78 milhões, com a "disrupção" de empregos (criação e deslocamento somados) alcançando cerca de 22% dos empregos atuais. Isso é construído a partir de uma grande pesquisa com empregadores, e não de dados observados de emprego, porque 2030 ainda não aconteceu. É um sinal realmente útil do que os empregadores esperam e já estão planejando. Não é uma medição do que a IA fez com o emprego, e tratar uma pesquisa voltada ao futuro como um resultado histórico é o erro mais comum na cobertura sobre o futuro do trabalho.
Gartner: Ceticismo sobre a IA Agêntica em Escala
Os próprios analistas da Gartner, por sua vez, são a fonte de uma das previsões mais céticas e amplamente citadas: a de que mais de 40% dos projetos de IA agêntica serão cancelados antes do fim de 2027, por causa de custos crescentes, valor de negócio pouco claro e controles de risco fracos. Anushree Verma, da Gartner, apontou o "agent washing", em que chatbots e ferramentas de automação existentes são rebatizados como agentes autônomos sem nenhuma capacidade nova por trás do rótulo, como um fator de expectativas infladas que depois desabam ao contato com os requisitos de produção. Uma previsão de fracasso merece o mesmo escrutínio que uma de sucesso: é uma estimativa informada de analistas que acompanham de perto as promessas dos fornecedores, e não um resultado que alguém tenha observado.
O Que a Evidência Ainda Não Mostra
Ser preciso sobre o que não sabemos importa tanto quanto citar o que sabemos. A pesquisa acima não estabelece:
- Se os ganhos de produtividade no nível da tarefa se traduzem em perdas líquidas de empregos, ganhos líquidos ou, em grande parte, um rearranjo do que os trabalhadores atuais fazem com seu tempo. Os números do WEF são projeções baseadas em pesquisas, e não resultados observados.
- Se os ganhos de produtividade em estudos controlados restritos se sustentam ao longo de uma semana de trabalho inteira, de um ano inteiro, ou em trabalhos menos roteirizados do que chats de suporte ao cliente ou tarefas de programação cronometradas.
- Por que a IA ajuda mais os novatos do que os especialistas em alguns contextos (suporte, redação), mas parece desacelerar os especialistas em outros (o estudo de programação da METR), além da teoria plausível, porém não comprovada, de que o custo de revisão pesa mais quando a pessoa já tem a expertise que a IA tenta fornecer.
- Se a distância atual entre a alta adoção de IA e o baixo valor empresarial medido é um atraso temporário de integração, como sugere o enquadramento do MIT NANDA, ou um teto mais duradouro para o que essas ferramentas conseguem acrescentar sem um redesenho mais profundo dos processos.
Nada dessa incerteza é motivo para esperar e ver. É motivo para tratar isso como qualquer questão empírica em aberto: acompanhe os estudos, não as apresentações dos fornecedores, e atualize seu plano à medida que chegam evidências melhores, em vez de se fixar no número de destaque deste mês.
Pondo a Evidência para Trabalhar
A conclusão prática para quem planeja quadro de pessoal, ferramentas ou requalificação em torno da IA é separar toda afirmação que ouvir em um de dois grupos antes de agir. Grupo um: um resultado medido, com um estudo nomeado, uma amostra declarada e um método que você poderia ir ler. Grupo dois: uma previsão, com um previsor nomeado e um método declarado para como ele chegou lá. Confundir os dois é onde os planos dão errado, seja investindo demais com base em uma pesquisa de intenções, seja investindo de menos com base em um estudo de programação contestado. As organizações que vão bem agora, segundo McKinsey e MIT NANDA, tratam a adoção de IA como um problema contínuo de medição, e não como uma implantação única, a mesma disciplina por trás de construir uma cultura pronta para a IA e de equipes humano-agente que funcionam no dia a dia, e não apenas ficam bem num slide.

Co-Founder, Rework.com
On this page
- Fatos principais
- O Que "a IA Mudando o Trabalho" Realmente Significa
- A Evidência Medida: O Que os Estudos Controlados Encontraram
- Suporte ao Cliente: O Estudo do Call Center de Stanford
- Programação: Dois Ensaios, Dois Anos Diferentes, Duas Respostas Diferentes
- Redação e Trabalho do Conhecimento: O Experimento de Noy e Zhang
- Resultados Medidos em Resumo
- A Adoção É Alta. O Impacto Medido É Irregular. Essa Distância Tem um Nome.
- McKinsey: Adoção Sem Transformação
- MIT NANDA e a Divisão da GenAI
- O Que as Previsões Afirmam, Quem as Faz e Como
- WEF Future of Jobs: Uma Pesquisa sobre as Expectativas dos Empregadores
- Gartner: Ceticismo sobre a IA Agêntica em Escala
- O Que a Evidência Ainda Não Mostra
- Pondo a Evidência para Trabalhar