Wie KI die Arbeit verändert: Was die Evidenz tatsächlich zeigt
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
KI verändert messbar einzelne Aufgaben innerhalb bestimmter Berufe, nicht ganze Berufe im Ganzen. Kontrollierte Studien zeigen echte Produktivitätsgewinne in eng umrissenen Settings (Kundensupport, Programmierung, Schreiben), die je nach Kompetenzniveau variieren und sich teils widersprechen. Die Adoption in Unternehmen ist hoch; die gemessene finanzielle Wirkung ist es nicht. Längerfristige Aussagen über Stellenverluste oder Aufgabenautomatisierung sind Prognosen benannter Forschender mit angegebenen Methoden, keine beobachteten Tatsachen, und sollten auch so gelesen werden.
Die meisten Texte über KI und Arbeit verfallen einer von zwei Fehlformen: Sie behandeln eine Anbieter-Demo als Beleg für einen Wandel am Arbeitsmarkt oder die Prognose einer Beratungsfirma, als wäre sie bereits eingetreten. Dieser Artikel trennt, was tatsächlich gemessen wurde, in kontrollierten Studien mit veröffentlichten Methoden, von dem, was Menschen vorhersagen, und benennt, wer die Vorhersage trifft und wie.
Wichtige Fakten
- Eine von Stanford geleitete Studie mit 5.179 Kundensupport-Mitarbeitenden ergab, dass die Unterstützung durch generative KI die Produktivität im Schnitt um 14 % steigerte, mit einem Plus von 34 % für unerfahrene Mitarbeitende und fast keiner Wirkung bei erfahrenen. NBER working paper 31161
- Eine randomisierte kontrollierte Studie ergab, dass Nutzer von GitHub Copilot eine Programmieraufgabe 55,8 % schneller erledigten als eine Kontrollgruppe. arXiv 2302.06590
- Eine randomisierte Studie von METR aus dem Jahr 2025 mit erfahrenen Open-Source-Entwicklern ergab, dass KI-Coding-Tools sie bei realen Aufgaben um 19 % langsamer machten, obwohl die Entwickler glaubten, 20 % schneller zu sein. METR, July 2025
- Eine Studie in Science mit 453 Fachkräften ergab, dass ChatGPT die Zeit für Schreibaufgaben um 40 % senkte und die Qualität um 18 % hob, mit den größten Gewinnen bei leistungsschwächeren Schreibenden. Science, DOI 10.1126/science.adh2586
- McKinseys State-of-AI-Umfrage 2025 ergab, dass 88 % der Organisationen KI in mindestens einer Funktion nutzen, aber nur etwa 6 % angeben, sie so einzusetzen, dass sie erheblichen unternehmensweiten Wert erzeugt. McKinsey, State of AI
- MITs Project NANDA stellte fest, dass 95 % der generativen KI-Pilotprojekte in den untersuchten Unternehmen keine messbare Wirkung auf die Gewinn- und Verlustrechnung zeigten, trotz Unternehmensausgaben in zweistelliger Milliardenhöhe. Fortune, August 2025
- Der Future of Jobs Report 2025 des Weltwirtschaftsforums prognostiziert bis 2030 die Schaffung von 170 Millionen Arbeitsplätzen und den Wegfall von 92 Millionen, ein Nettoplus von 78 Millionen, auf Basis von Arbeitgeberumfragen. WEF, January 2025
- Gartner prognostiziert, dass mehr als 40 % der Projekte mit agentenbasierter KI bis Ende 2027 wegen Kosten, unklarem Nutzen und schwacher Risikokontrollen eingestellt werden. Gartner via RCR Wireless
Was „KI verändert die Arbeit“ tatsächlich bedeutet
Streicht man das Branding weg, ist die Behauptung hinter den meisten Beiträgen zu KI und Arbeit einfach: Generative KI, die Texte entwerfen, zusammenfassen, Code schreiben und Fragen beantworten kann, ist inzwischen günstig und gut genug, dass Menschen sie in echten Jobs einsetzen, nicht nur in Demos. Das hat drei getrennte, prüfbare Ebenen, und sie zu vermengen ist der Ursprung der meisten schlechten Analysen.
Die erste Ebene ist der Effekt auf Aufgabenebene: Wird eine bestimmte Aufgabe mit KI-Hilfe schneller, besser oder günstiger? Diese Ebene hat die belastbarste Evidenz, weil sie klein genug ist, um eine randomisierte Studie durchzuführen. Die zweite Ebene ist der Effekt auf Stellenebene: Verändert sich eine ganze Rolle, schrumpft sie oder verschwindet sie? Das lässt sich schwerer direkt messen und wird meist aus Einstellungsdaten und Stellenanzeigen abgeleitet. Die dritte Ebene ist der Effekt auf Ebene der Volkswirtschaft: Gesamtbeschäftigung, Löhne, Produktivität. Auf dieser Ebene arbeiten Prognosen, und sie hat die geringste direkte Evidenz, weil der Wandel noch jung ist und die Daten Jahre hinterherhinken.
Diese Ebenen getrennt zu halten ist wichtig, weil eine wahre Aussage auf der einen (KI machte diese Programmieraufgabe in einer Studie 55 % schneller) auf der anderen zu einer falsch klingenden Behauptung gedehnt wird (KI ersetzt Softwareentwickler), ohne dass jemand zeigt, wie ein Gewinn auf Aufgabenebene zu einem auf Stellenebene wird. Die aufgabenbasierten Arbeitsmarktmodelle des Ökonomen David Autor sind hier der klarste Wegweiser: Berufe sind Bündel von Aufgaben, und die Automatisierung einiger Aufgaben verändert einen Beruf meist, statt ihn zu beseitigen, zumindest kurzfristig.
Die gemessene Evidenz: Was kontrollierte Studien ergaben
Kundensupport: Die Stanford-Call-Center-Studie
Die meistzitierte empirische Studie zu generativer KI und Arbeit an der Kundenfront stammt von Erik Brynjolfsson, Danielle Li und Lindsey Raymond, veröffentlicht als NBER-Arbeitspapier und verbunden mit Stanfords Digital Economy Lab. Die Forschenden verfolgten die gestaffelte Einführung eines generativen KI-Assistenten bei 5.179 Kundensupport-Mitarbeitenden eines Softwareunternehmens, die in Live-Chats Antwortvorschläge in Echtzeit erhielten.
Die Schlagzeile ist ein durchschnittlicher Anstieg der pro Stunde gelösten Anliegen um 14 %, nachdem die Mitarbeitenden Zugang zum Tool hatten. Doch der Durchschnitt verbirgt den interessanteren Befund: Unerfahrene und weniger qualifizierte Mitarbeitende erzielten einen Produktivitätsgewinn von 34 %, während die erfahrensten kaum einen messbaren Nutzen hatten. Die Mitarbeitenden folgten den Vorschlägen des Tools im Schnitt nur in etwa 38 % der Fälle, ein Human-in-the-Loop-Muster, bei dem das Tool weniger wie ein Autopilot und mehr wie ein jederzeit verfügbarer Coach wirkte, dem man vertrauen oder widersprechen konnte. Die Studie fand zudem eine bessere Kundenstimmung und höhere Mitarbeiterbindung, und die Autoren argumentieren, der Mechanismus sei, dass das KI-Modell die Gesprächsmuster der besten Mitarbeitenden des Unternehmens destillierte und allen anderen in Echtzeit zur Verfügung stellte, eine Version der Vertrauenskalibrierung, die jeder Workflow aus Mensch und KI irgendwann lösen muss.
Dieser Punkt verdient Aufmerksamkeit. Das war keine Studie über KI, die Mitarbeitende ersetzt. Es war eine Studie darüber, wie KI den Abstand zwischen den besten und schwächsten Leistungsträgern eines Unternehmens verkleinert, indem sie implizites Wissen weitergibt, für das man früher Jahre im Job oder einen guten Mentor brauchte.
Programmierung: Zwei Studien, zwei verschiedene Jahre, zwei verschiedene Antworten
Bei der Programmierung ist „KI verändert die Arbeit“ wirklich umstritten: Zwei glaubwürdige RCTs weisen in entgegengesetzte Richtungen, und der Unterschied ist aufschlussreich, kein Widerspruch, den man wegwischen sollte.
Sida Peng und Koautoren führten einen RCT durch, in dem Entwickler so schnell wie möglich einen HTTP-Server in JavaScript bauen sollten. Die Behandlungsgruppe, die GitHub Copilot nutzte, war 55,8 % schneller fertig als die Kontrollgruppe, bei einem 95-%-Konfidenzintervall zwischen 21 % und 89 %. Weniger erfahrene Entwickler und solche, die mehr Stunden pro Tag programmierten, profitierten am meisten, dieselbe Schieflage zugunsten weniger erfahrener Beschäftigter wie in der Kundensupport-Studie.
Mitte 2025 führte dann die gemeinnützige Forschungsgruppe METR einen anderen Typ RCT durch: keine frische Aufgabe, die eine einzelne Variable isoliert, sondern reale Arbeit erfahrener Open-Source-Entwickler an ihren eigenen Codebasen, mit den Tools auf Basis eines Large Language Models, die sie selbst wählten. Das Ergebnis: Die Entwickler waren mit KI-Unterstützung um 19 % langsamer, nicht schneller, obwohl sie vorab eine Beschleunigung von 24 % vorhergesagt hatten und hinterher glaubten, 20 % schneller gewesen zu sein. Die Kluft zwischen Wahrnehmung und gemessener Realität war der auffälligste Befund der Studie.
Das sind nicht dieselben Experimente, und genau das ist der Punkt. Pengs Studie maß eine abgegrenzte, unbekannte Aufgabe, bei der KI fehlendes Hintergrundwissen ausgleicht. METRs Studie maß erfahrene Entwickler bei vertrauter, kontextreicher Arbeit, bei der das Prüfen und Korrigieren von KI-Vorschlägen mehr Zeit kosten kann als das direkte Schreiben des Codes. Zusammen gelesen legen die Studien nahe: KI-Codinghilfe wirkt am besten, wenn sie Wissen ersetzt, das dem Entwickler fehlt, und kann Experten bremsen, wenn sie Wissen ersetzt, das sie bereits haben. Das ist eine nützlichere, falsifizierbare Aussage als „KI macht Entwickler schneller“ oder „KI macht Entwickler langsamer“.
Schreiben und Wissensarbeit: Das Experiment von Noy und Zhang
Shakked Noy und Whitney Zhang führten ein randomisiertes Experiment mit 453 Akademikern bei berufsspezifischen Schreibaufgaben durch, bei dem die Hälfte Zugang zu ChatGPT hatte, veröffentlicht 2023 in Science. Die Zeit für die Aufgaben sank um etwa 40 %, und die Bewertungen der Ergebnisqualität durch unabhängige Prüfer stiegen um rund 18 %. Die Produktivitätsgewinne waren stark zugunsten der Beschäftigten verzerrt, die ohne KI-Hilfe bei der Aufgabe am schwächsten abschnitten, das Tool verringerte also den Leistungsabstand zwischen starken und schwachen Schreibenden, statt ihn zu vergrößern.
Die Studie dokumentierte auch etwas, das Prognosen selten erwähnen: Was ChatGPT tatsächlich ersetzte, war der Aufwand der Beschäftigten beim groben Entwerfen, nicht ihr Urteilsvermögen. Die Aufgabenzeit verlagerte sich hin zu Ideenfindung, Strukturierung und Überarbeitung und weg vom ersten Entwurf auf dem leeren Blatt. Die Beschäftigten berichteten zudem von höherer Arbeitszufriedenheit bei gleichzeitig größerer Sorge vor Automatisierung, eine nützliche Erinnerung daran, dass Produktivitätsgewinne und Sorgen der Beschäftigten keine einander ausschließenden Reaktionen auf dasselbe Tool sind.
Gemessene Befunde auf einen Blick
| Studie | Setting | Gemessener Befund | Was sie belegt | Was sie NICHT belegt |
|---|---|---|---|---|
| Brynjolfsson, Li, Raymond (NBER/Stanford) | 5.179 Kundensupport-Mitarbeitende, Live-Einführung | +14 % gelöste Anliegen pro Stunde im Schnitt; +34 % bei Unerfahrenen; ~0 % bei Experten | KI-Unterstützung kann Expertenwissen bei einer konkreten, begleiteten Aufgabe an unerfahrene Beschäftigte weitergeben | Dass der Effekt außerhalb chatbasierten Supports gilt oder sich in anderen Servicejobs genauso skaliert |
| Peng et al., GitHub-Copilot-RCT | Abgegrenzte Programmieraufgabe, einsteigerfreundlich | 55,8 % schnellere Erledigung mit Copilot | KI-Codinghilfe kann eine abgegrenzte, unbekannte Aufgabe stark beschleunigen | Dass erfahrene Entwickler bei komplexen, vertrauten Codebasen denselben Gewinn sehen |
| METR, Entwickler-RCT 2025 | Erfahrene Open-Source-Entwickler, reale Repos | 19 % langsamer mit KI-Tools; Entwickler glaubten, 20 % schneller zu sein | Wahrgenommene und gemessene Geschwindigkeit können bei Expertenarbeit in entgegengesetzte Richtungen zeigen | Dass KI-Coding-Tools für alle Entwickler oder alle Aufgabentypen netto negativ sind |
| Noy & Zhang, Science 2023 | 453 Fachkräfte, Schreibaufgaben | -40 % Zeit, +18 % Qualität; größte Gewinne bei schwächeren Schreibenden | Generative KI kann Leistungsunterschiede verringern und Aufwand vom Entwerfen aufs Überarbeiten verlagern | Dass die Gewinne bei erfahrenen Schreibenden bestehen oder über eine volle Arbeitswoche im großen Maßstab gelten |
Die Adoption ist hoch. Die gemessene Wirkung ist ungleichmäßig. Diese Lücke hat einen Namen.
Wenn Studien auf Aufgabenebene etwas Reales, aber Enges zeigen, zeigen Unternehmensumfragen etwas Breites, aber Unklares, und beides passt noch nicht sauber zusammen.
McKinsey: Adoption ohne Transformation
McKinseys State-of-AI-Studie 2025 ergab, dass 88 % der Organisationen KI inzwischen regelmäßig in mindestens einer Geschäftsfunktion nutzen, nach 78 % im Jahr davor. Derselbe Bericht stellte aber fest, dass nur etwa ein Drittel der Unternehmen über verstreute Pilotprojekte hinaus zur skalierten Nutzung gelangt ist und rund 6 % als echte Spitzenreiter gelten, die erheblichen Unternehmenswert aus KI schöpfen. Zudem berichteten 47 % der Organisationen von mindestens einer negativen Folge des Einsatzes generativer KI, sei es ein Genauigkeitsfehler, ein Compliance-Problem oder ein Workflow-Ausfall, genau die Art Lücke, die KI-Governance-Programme schließen sollen. Die Adoption hat bei den meisten Unternehmen also sowohl die Kontrolle als auch den messbaren Ertrag überholt, obwohl sie auf der Ebene „wir nutzen das irgendwo“ nahezu allgemein ist.
MIT NANDA und die GenAI-Kluft
Die schärfste Version dieser Lücke stammt aus MITs Project NANDA, dessen Bericht vom Juli 2025 mehr als 300 öffentliche KI-Einsätze, 52 strukturierte Interviews und 153 Befragungen von Führungskräften auswertete. Der Kernbefund: Trotz geschätzter 30 bis 40 Milliarden $ an Unternehmensausgaben für generative KI brachten 95 % der Pilotprojekte keine messbare Wirkung auf die Gewinn- und Verlustrechnung. Der nützlichere Befund liegt unter dieser Schlagzeile. KI-Tools von spezialisierten Anbietern zu kaufen gelang etwa doppelt so oft, wie KI intern selbst zu entwickeln, und die größten realisierten Erträge zeigten sich bei unscheinbarer Back-Office-Automatisierung, nicht bei den Vertriebs- und Marketing-Anwendungsfällen, die den Großteil des Budgets bekamen. Die Forschenden sehen das Kernhindernis in einer „Lernlücke“: Tools, die sich nicht an den Kontext eines konkreten Workflows anpassen, setzen sich selten durch, unabhängig von der Leistungsfähigkeit des zugrunde liegenden Modells.
Zusammen gelesen beschreiben McKinsey und MIT NANDA dasselbe Phänomen aus verschiedenen Blickwinkeln: breite, flache Adoption, die noch nicht zu tiefer, gemessener Transformation geworden ist. Das ist kein Beleg dafür, dass KI nicht funktioniert; die Studien auf Aufgabenebene oben zeigen klar, dass sie es kann. Es ist ein Beleg dafür, dass die meisten Unternehmen die Integrationsarbeit nicht geleistet haben, um aus einem leistungsfähigen Tool ein gemessenes Ergebnis zu machen, genau das Abkürzungsdenken, das kulturelle KI-Schulden beschreiben, und es deckt sich damit, wie KI-native Kultur den Unterschied zwischen dem Besitzen eines Tools und dem guten Betreiben beschreibt.
Was Prognosen behaupten, wer sie aufstellt und wie
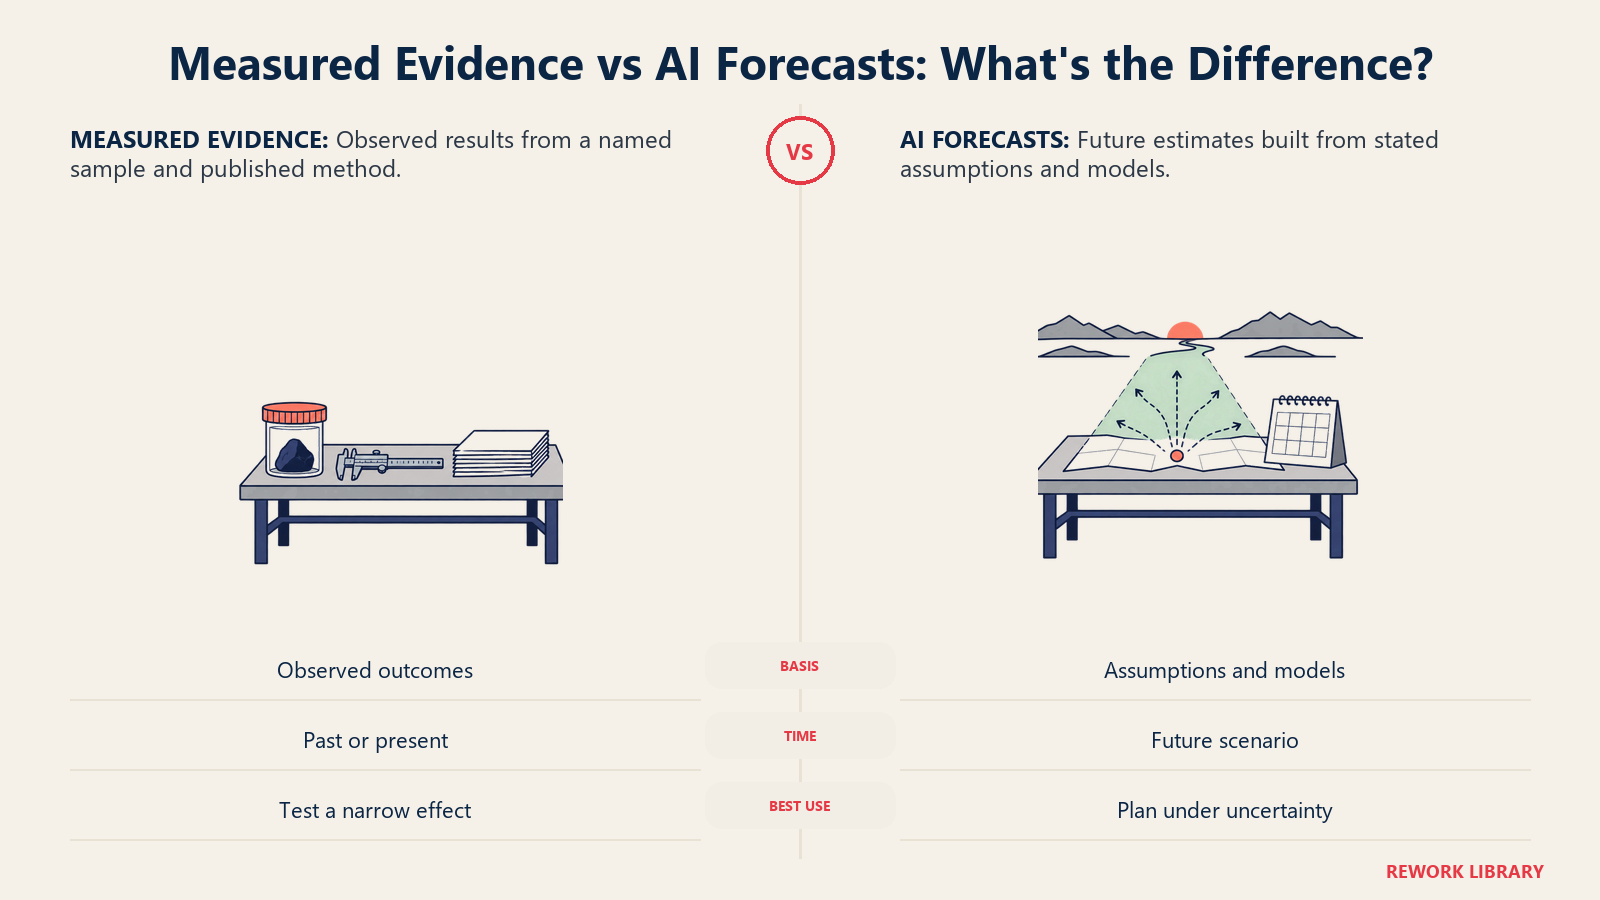
Alles oben ist Messung: Etwas ist geschehen, Forschende haben es erfasst, und die Methode ist veröffentlicht und überprüfbar. Prognosen sind eine völlig andere Kategorie, und die zwei meistzitierten in der Literatur zur Zukunft der Arbeit sollten als Behauptungen mit Urhebern und Methoden benannt statt als gesicherte Tatsache wiederholt werden.
WEF Future of Jobs: Eine Umfrage zu Arbeitgebererwartungen
Der Future of Jobs Report 2025 des Weltwirtschaftsforums prognostiziert bis 2030 170 Millionen neue Arbeitsplätze und 92 Millionen wegfallende Rollen, ein Nettoplus von 78 Millionen, wobei die „Disruption“ von Jobs (Schaffung und Wegfall zusammen) etwa 22 % der heutigen Arbeitsplätze berührt. Das beruht auf einer großen Arbeitgeberumfrage, nicht auf beobachteten Beschäftigungsdaten, weil 2030 noch nicht eingetreten ist. Es ist ein wirklich nützliches Signal dafür, was Arbeitgeber erwarten und bereits einplanen. Es ist keine Messung dessen, was KI mit der Beschäftigung getan hat, und eine vorausschauende Umfrage als historisches Ergebnis zu behandeln ist der häufigste Einzelfehler in der Berichterstattung zur Zukunft der Arbeit.
Gartner: Skepsis gegenüber agentenbasierter KI im großen Maßstab
Gartners eigene Analysten wiederum sind die Quelle einer der skeptischeren, viel zitierten Prognosen: dass mehr als 40 % der agentenbasierten KI-Projekte vor Ende 2027 eingestellt werden, getrieben von steigenden Kosten, unklarem Geschäftsnutzen und schwachen Risikokontrollen. Gartners Anushree Verma verweist auf „Agent Washing“, bei dem bestehende Chatbots und Automatisierungstools ohne neue Fähigkeiten als autonome Agents umetikettiert werden, als Treiber überzogener Erwartungen, die später an den Anforderungen des Produktivbetriebs zerbrechen. Eine Prognose, die ein Scheitern vorhersagt, verdient dieselbe Prüfung wie eine, die einen Erfolg vorhersagt: Es ist eine fundierte Schätzung von Analysten, die Anbieterversprechen genau verfolgen, kein Ergebnis, das bisher jemand beobachtet hätte.
Was die Evidenz noch nicht zeigt
Genau zu sein bei dem, was wir nicht wissen, ist ebenso wichtig, wie das zu zitieren, was wir wissen. Die obige Forschung belegt nicht:
- Ob sich Produktivitätsgewinne auf Aufgabenebene in Netto-Stellenverluste, Netto-Stellengewinne oder überwiegend eine Umverteilung der Arbeitszeit bestehender Beschäftigter übersetzen. Die WEF-Zahlen sind umfragebasierte Projektionen, keine beobachteten Ergebnisse.
- Ob die Produktivitätsgewinne in eng gefassten kontrollierten Studien über eine volle Arbeitswoche, ein volles Jahr oder bei weniger skriptbasierter Arbeit als Support-Chats oder zeitlich begrenzten Programmieraufgaben Bestand haben.
- Warum KI Unerfahrenen in manchen Settings (Support, Schreiben) mehr hilft als Experten, aber Experten in anderen (die METR-Coding-Studie) offenbar bremst, jenseits der plausiblen, aber unbewiesenen Theorie, dass der Prüfaufwand stärker ins Gewicht fällt, wenn jemand die Expertise, die die KI liefern will, bereits hat.
- Ob die aktuelle Lücke zwischen hoher KI-Adoption und geringem gemessenem Unternehmenswert eine vorübergehende Integrationsverzögerung ist, wie MIT NANDAs Deutung nahelegt, oder eine dauerhaftere Obergrenze dessen, was diese Tools ohne tiefere Prozessneugestaltung leisten können.
Nichts von dieser Unsicherheit ist ein Grund, abzuwarten. Sie ist ein Grund, das wie jede ungeklärte empirische Frage zu behandeln: Beobachten Sie die Studien, nicht die Anbieterpräsentationen, und passen Sie Ihren Plan an, wenn bessere Evidenz vorliegt, statt sich auf die Schlagzeilenzahl dieses Monats festzulegen.
Die Evidenz in die Praxis umsetzen
Die praktische Konsequenz für alle, die Personalstärke, Tools oder Reskilling rund um KI planen: Ordnen Sie jede Behauptung, die Sie hören, einer von zwei Schubladen zu, bevor Sie danach handeln. Schublade eins: ein gemessenes Ergebnis mit benannter Studie, angegebener Stichprobe und einer Methode, die Sie nachlesen können. Schublade zwei: eine Prognose mit benanntem Prognostiker und angegebener Methode, wie er dazu kam. Beides zu verwechseln ist der Punkt, an dem Pläne schiefgehen, ob durch Überinvestition aufgrund einer Umfrage zu Absichten oder Unterinvestition aufgrund einer umstrittenen Coding-Studie. Die Organisationen, die derzeit gut dastehen, behandeln laut McKinsey und MIT NANDA die KI-Adoption als fortlaufendes Messproblem statt als einmaligen Rollout, dieselbe Disziplin, die hinter dem Aufbau einer KI-bereiten Kultur und Mensch-Agent-Teams steht, die im Alltag funktionieren, statt nur auf einer Folie gut auszusehen.
Häufig gestellte Fragen zu den Veränderungen der Arbeit durch KI
Gibt es einen soliden Beleg dafür, dass KI die Produktivität am Arbeitsplatz steigert?
Ja, in konkreten gemessenen Settings. Die von Stanford geleitete Kundensupport-Studie ergab einen durchschnittlichen Produktivitätsgewinn von 14 % bei 5.179 Mitarbeitenden, und eine Studie in Science mit professionell Schreibenden ergab eine Verringerung der Aufgabenzeit um 40 % bei 18 % höherer Qualität. Beides sind kontrollierte Studien mit veröffentlichten Methoden.
Macht KI erfahrene Beschäftigte produktiver oder nur Anfänger?
Das ist gemischt und hängt vom Kompetenzniveau ab. In den Studien zu Kundensupport und Schreiben profitierten Unerfahrene und Leistungsschwächere am meisten, während Experten wenig gewannen. In der METR-Coding-Studie von 2025 wurden erfahrene Entwickler mit KI-Tools bei vertrauten, realen Codebasen um 19 % langsamer, das umgekehrte Muster.
Wie können zwei KI-Coding-Studien zu entgegengesetzten Ergebnissen kommen?
Sie haben Verschiedenes gemessen. Peng et al. nutzten eine abgegrenzte, unbekannte Aufgabe, bei der KI eine Wissenslücke füllt, und fanden eine Beschleunigung um 55,8 %. METR nutzte erfahrene Entwickler an Codebasen, die sie bereits tief verstanden, wo das Prüfen von KI-Output mehr Zeit kosten kann, als es spart.
Wenn die KI-Adoption bei 88 % liegt, warum zeigen die meisten Unternehmen keinen messbaren ROI?
McKinsey fand, dass 88 % der Organisationen KI irgendwo nutzen, aber nur etwa 6 % erheblichen Unternehmenswert daraus ziehen. MITs Project NANDA stellte fest, dass 95 % der Pilotprojekte keine Wirkung auf die Gewinn- und Verlustrechnung hatten, und führte die Lücke auf schwache Workflow-Integration statt auf schwache Modelle zurück.
Sind Vorhersagen wie „170 Millionen neue Arbeitsplätze bis 2030“ Tatsachen oder Schätzungen?
Es sind Schätzungen, genauer eine umfragebasierte Prognose von Arbeitgebern aus dem Future of Jobs Report 2025 des Weltwirtschaftsforums. Sie spiegelt wider, was Arbeitgeber derzeit erwarten und einplanen, was nützlich ist, aber keine Messung dessen, was bereits geschehen ist.
Warum erwartet Gartner, dass 40 % der Projekte mit agentenbasierter KI bis 2027 scheitern?
Gartner verweist auf steigende Einführungskosten, unklaren Geschäftsnutzen und schwache Risikokontrollen sowie auf „Agent Washing“, bei dem bestehende Automatisierungstools ohne entsprechende Fähigkeiten als autonome Agents umetikettiert werden. Es ist eine Analystenprognose auf Basis der Beobachtung von Anbietern und Kunden, noch kein beobachtetes Ergebnis.
Ersetzt KI ganze Berufe oder nur einzelne Aufgaben?
Die bisherige Evidenz bezieht sich fast ausschließlich auf die Aufgabenebene: eine Support-Anfrage schneller gelöst, eine Programmieraufgabe schneller erledigt, ein Entwurf früher geschrieben. Ob das zu weniger Stellen insgesamt, denselben Stellen mit anderen Aufgaben oder neuen Berufskategorien führt, ist durch direkte Messung noch nicht entschieden.
Was sollte eine Führungskraft mit so gemischter Evidenz konkret tun?
Jede Behauptung vor dem Handeln als „gemessen“ oder „Prognose“ einordnen, KI bei den Aufgabentypen pilotieren, für die kontrollierte Studien echte Gewinne zeigen, und die eigenen Ergebnisse so messen, wie MIT NANDA und McKinsey den Markt gemessen haben: Adoption ist nicht dasselbe wie Wert, und nur das Verfolgen des Werts zeigt, ob es funktioniert.

Co-Founder, Rework.com
On this page
- Wichtige Fakten
- Was „KI verändert die Arbeit“ tatsächlich bedeutet
- Die gemessene Evidenz: Was kontrollierte Studien ergaben
- Kundensupport: Die Stanford-Call-Center-Studie
- Programmierung: Zwei Studien, zwei verschiedene Jahre, zwei verschiedene Antworten
- Schreiben und Wissensarbeit: Das Experiment von Noy und Zhang
- Gemessene Befunde auf einen Blick
- Die Adoption ist hoch. Die gemessene Wirkung ist ungleichmäßig. Diese Lücke hat einen Namen.
- McKinsey: Adoption ohne Transformation
- MIT NANDA und die GenAI-Kluft
- Was Prognosen behaupten, wer sie aufstellt und wie
- WEF Future of Jobs: Eine Umfrage zu Arbeitgebererwartungen
- Gartner: Skepsis gegenüber agentenbasierter KI im großen Maßstab
- Was die Evidenz noch nicht zeigt
- Die Evidenz in die Praxis umsetzen