Cara AI Mengubah Kerja: Apa yang Sebenarnya Ditunjukkan oleh Bukti
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI secara terukur mengubah tugas tertentu dalam pekerjaan tertentu, bukan keseluruhan pekerjaan secara borong. Kajian terkawal menunjukkan peningkatan produktiviti yang nyata dalam keadaan sempit (sokongan pelanggan, pengekodan, penulisan) yang berbeza mengikut tahap kemahiran dan kadangkala bercanggah antara satu sama lain. Penerimaan di peringkat perusahaan tinggi; kesan kewangan yang diukur tidak. Dakwaan jangka lebih panjang tentang kehilangan pekerjaan atau automasi tugas ialah ramalan daripada penyelidik yang dinamakan menggunakan kaedah yang dinyatakan, bukan fakta yang diperhatikan, dan patut dibaca sedemikian.
Kebanyakan tulisan tentang AI dan kerja jatuh ke dalam satu daripada dua mod kegagalan: menganggap demo vendor sebagai bukti peralihan pasaran buruh, atau menganggap ramalan firma perundingan seolah-olah ia sudah berlaku. Artikel ini mengasingkan apa yang benar-benar telah diukur, dalam kajian terkawal dengan kaedah yang diterbitkan, daripada apa yang diramalkan orang, dan menamakan siapa yang meramal serta bagaimana.
Fakta Utama
- Kajian diketuai Stanford terhadap 5,179 ejen sokongan pelanggan mendapati bantuan AI generatif meningkatkan produktiviti sebanyak 14% secara purata, dengan peningkatan 34% bagi ejen baharu dan hampir tiada kesan bagi yang berpengalaman. NBER working paper 31161
- Ujian terkawal rawak mendapati pengguna GitHub Copilot menyiapkan tugas pengekodan 55.8% lebih pantas daripada kumpulan kawalan. arXiv 2302.06590
- Ujian rawak METR pada 2025 terhadap pembangun sumber terbuka yang berpengalaman mendapati alat pengekodan AI menjadikan mereka 19% lebih perlahan pada tugas sebenar, walaupun pembangun percaya mereka 20% lebih pantas. METR, July 2025
- Kajian Science terhadap 453 profesional mendapati ChatGPT memotong masa tugas penulisan sebanyak 40% dan meningkatkan kualiti sebanyak 18%, dengan peningkatan terbesar bagi penulis berprestasi lebih rendah. Science, DOI 10.1126/science.adh2586
- Tinjauan State of AI McKinsey 2025 mendapati 88% organisasi menggunakan AI dalam sekurang-kurangnya satu fungsi, tetapi hanya kira-kira 6% melaporkan menggunakannya dengan cara yang menjana nilai besar di seluruh perusahaan. McKinsey, State of AI
- Project NANDA milik MIT mendapati 95% projek perintis AI generatif di syarikat yang dikajinya tidak menunjukkan kesan untung rugi yang boleh diukur, walaupun perbelanjaan perusahaan mencecah berpuluh bilion. Fortune, August 2025
- Future of Jobs Report 2025 daripada World Economic Forum meramalkan 170 juta pekerjaan diwujudkan dan 92 juta disingkirkan menjelang 2030, pertambahan bersih 78 juta, berdasarkan tinjauan majikan. WEF, January 2025
- Gartner meramalkan lebih 40% projek AI agentik akan dibatalkan menjelang akhir 2027 kerana kos, nilai yang tidak jelas, dan kawalan risiko yang lemah. Gartner via RCR Wireless
Apa Sebenarnya Maksud "AI Mengubah Kerja"
Singkirkan penjenamaan dan dakwaan di sebalik kebanyakan kandungan AI-dan-kerja adalah mudah: AI generatif yang boleh menyediakan draf, meringkaskan, mengekod dan menjawab soalan kini cukup murah dan cukup baik sehingga orang menggunakannya dalam pekerjaan sebenar, bukan sekadar dalam demo. Itu mempunyai tiga lapisan berasingan yang boleh diuji, dan mencampuradukkannya ialah punca kebanyakan analisis yang buruk.
Lapisan pertama ialah kesan peringkat tugas: adakah tugas tertentu, yang dilakukan dengan bantuan AI, menjadi lebih pantas, lebih baik atau lebih murah? Lapisan ini mempunyai bukti paling ketat, kerana ia cukup kecil untuk dijalankan ujian rawak. Lapisan kedua ialah kesan peringkat pekerjaan: adakah keseluruhan peranan berubah bentuk, mengecil atau hilang? Ini lebih sukar diukur secara langsung dan kebanyakannya disimpulkan daripada data pengambilan pekerja dan iklan jawatan. Lapisan ketiga ialah kesan peringkat ekonomi: pekerjaan agregat, gaji, produktiviti. Inilah lapisan tempat ramalan beroperasi, dan ia mempunyai bukti langsung yang paling sedikit, kerana peralihan ini masih awal dan data ketinggalan beberapa tahun.
Mengasingkan lapisan ini penting kerana kenyataan yang benar pada satu lapisan (AI menjadikan tugas pengekodan ini 55% lebih pantas dalam ujian) diregangkan menjadi dakwaan yang kedengaran palsu pada lapisan lain (AI menggantikan jurutera perisian) tanpa sesiapa menunjukkan bagaimana peningkatan peringkat tugas terkumpul menjadi peningkatan peringkat pekerjaan. Model buruh berasaskan tugas oleh ahli ekonomi David Autor ialah panduan paling jelas di sini: pekerjaan ialah himpunan tugas, dan mengautomasikan sesetengah tugas biasanya mengubah pekerjaan dan bukan menghapuskannya, sekurang-kurangnya dalam jangka pendek.
Bukti yang Diukur: Apa yang Ditemui Kajian Terkawal
Sokongan Pelanggan: Kajian Pusat Panggilan Stanford
Kajian empirikal paling kerap dirujuk tentang AI generatif dan kerja barisan hadapan datang daripada Erik Brynjolfsson, Danielle Li, dan Lindsey Raymond, diterbitkan sebagai kertas kerja NBER dan dikaitkan dengan Digital Economy Lab Stanford. Penyelidik menjejaki pelancaran berperingkat pembantu AI generatif kepada 5,179 ejen sokongan pelanggan di sebuah firma perisian, dengan memberi mereka cadangan jawapan masa nyata semasa sembang langsung.
Angka utamanya ialah peningkatan purata 14% dalam isu yang diselesaikan sejam selepas ejen mendapat akses kepada alat itu. Tetapi purata itu menyembunyikan penemuan yang lebih menarik: ejen baharu dan berkemahiran lebih rendah mencatat peningkatan produktiviti 34%, manakala ejen paling berpengalaman hampir tidak mendapat manfaat yang boleh diukur. Ejen mengikut cadangan alat itu hanya kira-kira 38% daripada masa secara purata, corak human-in-the-loop yang menjadikan alat itu berfungsi kurang sebagai juruterbang automatik dan lebih sebagai jurulatih yang sentiasa ada, yang boleh dipercayai atau ditolak oleh ejen. Kajian itu juga mendapati sentimen pelanggan bertambah baik dan pengekalan ejen lebih tinggi, dan penulisnya berhujah mekanismenya ialah model AI menyuling corak perbualan ejen terbaik syarikat dan menyediakannya kepada semua orang lain secara masa nyata, satu versi penentukuran kepercayaan yang akhirnya mesti diselesaikan oleh setiap aliran kerja manusia-ditambah-AI.
Perkara itu wajar direnungkan. Ini bukan kajian tentang AI menggantikan ejen. Ia kajian tentang AI merapatkan jurang antara pemain terbaik dan terlemah sesebuah syarikat dengan memindahkan pengetahuan tersirat yang dahulu memerlukan bertahun-tahun bekerja atau mentor yang baik.
Pengekodan: Dua Ujian, Dua Tahun Berbeza, Dua Jawapan Berbeza
Bukti pengekodan ialah tempat "AI mengubah kerja" benar-benar dipertikaikan: dua RCT yang boleh dipercayai menunjuk ke arah bertentangan, dan perbezaannya bersifat memberi maklumat dan bukan percanggahan yang boleh diketepikan.
Sida Peng dan penulis bersama menjalankan RCT dengan pembangun yang diminta membina pelayan HTTP dalam JavaScript secepat mungkin. Kumpulan rawatan, menggunakan GitHub Copilot, selesai 55.8% lebih pantas daripada kumpulan kawalan, dengan selang keyakinan 95% antara 21% dan 89%. Pembangun yang kurang berpengalaman dan mereka yang mengekod lebih banyak jam sehari mendapat manfaat paling banyak, condongan yang sama ke arah pekerja kurang berpengalaman yang dilihat dalam kajian sokongan pelanggan.
Kemudian pada pertengahan 2025, kumpulan penyelidikan bukan untung METR menjalankan RCT jenis berbeza: bukan tugas baharu yang dibina untuk mengasingkan satu pemboleh ubah, tetapi kerja sebenar oleh pembangun sumber terbuka berpengalaman pada pangkalan kod mereka sendiri, menggunakan alat berasaskan model bahasa besar yang mereka pilih sendiri. Hasilnya: pembangun 19% lebih perlahan dengan bantuan AI, bukan lebih pantas, walaupun sebelum itu meramalkan AI akan mempercepatkan mereka sebanyak 24% dan selepas itu percaya ia telah mempercepatkan mereka sebanyak 20%. Jurang antara kepercayaan dan realiti yang diukur ialah penemuan paling menonjol dalam kajian itu.
Ini bukan eksperimen yang sama, dan itulah intinya. Ujian Peng mengukur tugas terhad yang tidak dikenali di mana AI menampung kekurangan pengetahuan latar. Ujian METR mengukur pembangun berpengalaman yang melakukan kerja biasa berkonteks tinggi, di mana menyemak dan membetulkan cadangan AI boleh memakan lebih banyak masa daripada menulis kod terus. Dibaca bersama, kajian-kajian itu mencadangkan bantuan pengekodan AI paling berkesan apabila ia menggantikan pengetahuan yang tidak dimiliki pembangun, dan boleh memperlahankan pakar apabila ia menggantikan pengetahuan yang sudah mereka miliki. Itu dakwaan yang lebih berguna dan boleh dipalsukan berbanding "AI menjadikan pembangun lebih pantas" atau "AI menjadikan pembangun lebih perlahan."
Penulisan dan Kerja Pengetahuan: Eksperimen Noy dan Zhang
Shakked Noy dan Whitney Zhang menjalankan eksperimen rawak dengan 453 profesional berpendidikan kolej yang melakukan tugas penulisan khusus pekerjaan, separuh daripadanya mempunyai akses kepada ChatGPT, diterbitkan dalam Science pada 2023. Masa yang dihabiskan untuk tugas menurun kira-kira 40%, dan penilaian kualiti output oleh penggred bebas meningkat kira-kira 18%. Peningkatan produktiviti condong dengan ketara kepada pekerja yang mendapat skor terendah tanpa bantuan AI, bermakna alat itu merapatkan jurang prestasi antara penulis kuat dan lemah dan bukan melebarkannya.
Kajian itu juga mendokumenkan sesuatu yang jarang disebut ramalan: apa yang sebenarnya digantikan ChatGPT ialah usaha pekerja pada penulisan draf kasar, bukan pertimbangan pekerja. Masa tugas beralih kepada penjanaan idea, penstrukturan dan penyuntingan, dan menjauhi draf pertama dari halaman kosong. Pekerja juga melaporkan kepuasan kerja yang lebih tinggi bersama kebimbangan yang lebih besar tentang automasi, peringatan berguna bahawa peningkatan produktiviti dan kebimbangan pekerja bukan tindak balas yang saling menolak terhadap alat yang sama.
Dapatan yang Diukur Sepintas Lalu
| Kajian | Tetapan | Dapatan yang diukur | Apa yang dibuktikan | Apa yang TIDAK dibuktikan |
|---|---|---|---|---|
| Brynjolfsson, Li, Raymond (NBER/Stanford) | 5,179 ejen sokongan pelanggan, pelancaran langsung | +14% isu diselesaikan sejam secara purata; +34% bagi ejen baharu; ~0% bagi pakar | Bantuan AI boleh memindahkan kepakaran pakar kepada pekerja baharu dalam tugas khusus yang dibimbing | Bahawa kesannya kekal di luar sokongan berasaskan sembang, atau berskala sama dalam kerja perkhidmatan lain |
| Peng et al., RCT GitHub Copilot | Tugas pengekodan terhad, mesra pemula | Penyiapan 55.8% lebih pantas dengan Copilot | Bantuan pengekodan AI boleh mempercepatkan tugas terhad yang tidak dikenali dengan ketara | Bahawa pembangun berpengalaman pada pangkalan kod kompleks yang biasa mendapat peningkatan sama |
| METR, RCT pembangun 2025 | Pembangun sumber terbuka berpengalaman, repositori sebenar | 19% lebih perlahan dengan alat AI; pembangun percaya mereka 20% lebih pantas | Kelajuan yang dirasakan dan kelajuan yang diukur boleh menunjuk ke arah bertentangan bagi kerja pakar | Bahawa alat pengekodan AI merugikan bagi semua pembangun atau semua jenis tugas |
| Noy & Zhang, Science 2023 | 453 profesional, tugas penulisan | -40% masa, +18% kualiti; peningkatan terbesar bagi penulis lemah | AI generatif boleh merapatkan jurang prestasi dan mengalihkan usaha daripada penyediaan draf kepada penyuntingan | Bahawa peningkatan kekal bagi penulis pakar, atau berlaku pada skala besar sepanjang minggu bekerja penuh |
Penerimaan Tinggi. Kesan yang Diukur Tidak Sekata. Jurang Itu Ada Namanya.
Jika kajian peringkat tugas menunjukkan sesuatu yang nyata tetapi sempit, tinjauan perusahaan menunjukkan sesuatu yang luas tetapi kabur, dan kedua-duanya belum sepadan dengan jelas.
McKinsey: Penerimaan Tanpa Transformasi
Penyelidikan State of AI McKinsey 2025 mendapati 88% organisasi kini menggunakan AI secara tetap dalam sekurang-kurangnya satu fungsi perniagaan, meningkat daripada 78% tahun sebelumnya. Tetapi laporan yang sama mendapati hanya kira-kira satu pertiga syarikat telah melangkaui projek perintis bertaburan kepada penggunaan berskala, dan kira-kira 6% layak sebagai pemain berprestasi tinggi sebenar yang meraih nilai perusahaan yang ketara daripada AI. Secara berasingan, 47% organisasi melaporkan sekurang-kurangnya satu akibat negatif daripada penggunaan AI generatif, sama ada kegagalan ketepatan, isu pematuhan, atau kerosakan aliran kerja, jenis jurang yang wujud program tadbir urus AI untuk menutupnya. Dengan kata lain, penerimaan telah mendahului pengawasan dan pulangan yang boleh diukur bagi kebanyakan syarikat, walaupun ia hampir menyeluruh pada tahap "kami menggunakannya di suatu tempat."
MIT NANDA dan Jurang GenAI
Versi paling ketara jurang ini datang daripada Project NANDA milik MIT, yang laporannya pada Julai 2025 mengkaji lebih 300 pelaksanaan AI awam, 52 temu bual berstruktur, dan 153 tinjauan pemimpin. Penemuan utamanya: walaupun anggaran perbelanjaan AI generatif perusahaan sebanyak $30 hingga $40 bilion, 95% projek perintis tidak menghasilkan kesan untung rugi yang boleh diukur. Penemuan yang lebih berguna terletak di bawah tajuk utama itu. Membeli alat AI daripada vendor khusus berjaya kira-kira dua kali lebih kerap daripada membina AI tersuai secara dalaman, dan pulangan terbesar yang direalisasikan muncul dalam automasi pejabat belakang yang tidak glamor, bukan kes penggunaan jualan dan pemasaran yang mendapat kebanyakan bajet. Penyelidik membingkaikan halangan utama sebagai "jurang pembelajaran": alat yang tidak menyesuaikan diri dengan konteks aliran kerja tertentu jarang bertahan, tanpa mengira keupayaan model di bawahnya.
Dibaca bersama, McKinsey dan MIT NANDA menerangkan fenomena yang sama dari sudut berbeza: penerimaan luas dan cetek yang belum menjadi transformasi mendalam yang diukur. Itu bukan bukti AI tidak berfungsi; kajian peringkat tugas di atas jelas menunjukkan ia boleh. Ia bukti kebanyakan syarikat belum melakukan kerja integrasi untuk menukar alat yang berkebolehan kepada hasil yang diukur, jalan pintas yang diterangkan oleh hutang budaya AI, dan ia selari dengan cara kerja budaya natif AI membingkaikan memiliki alat berbanding menjalankannya dengan baik.
Apa Dakwaan Ramalan, Siapa yang Membuatnya, dan Bagaimana
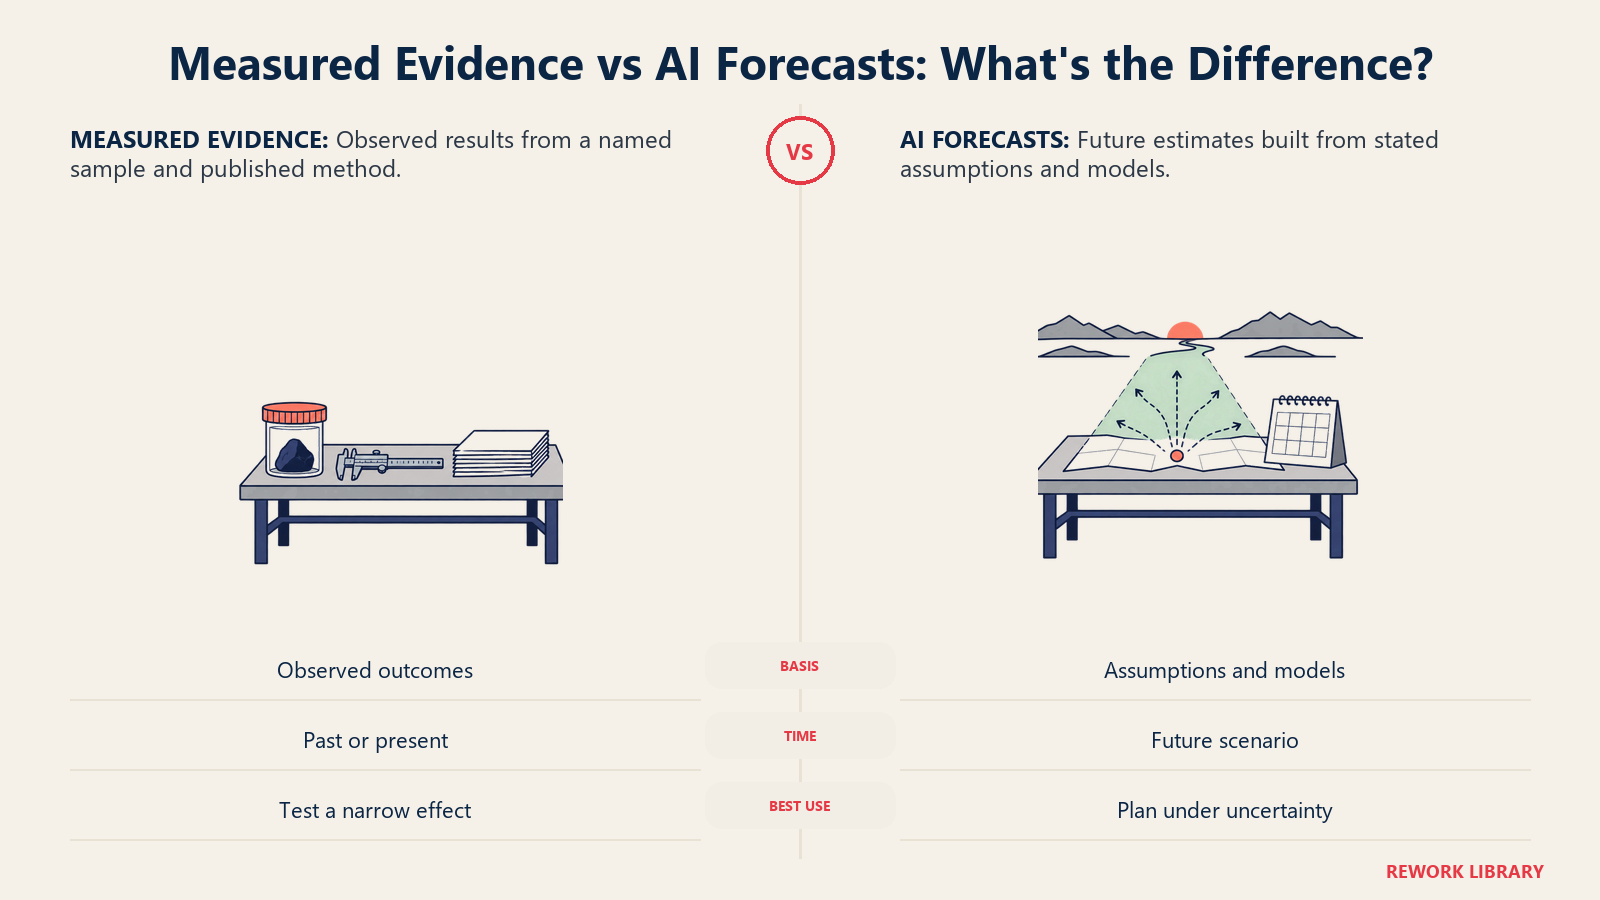
Segala-galanya di atas ialah pengukuran: sesuatu berlaku, penyelidik merekodkannya, dan kaedahnya diterbitkan serta boleh disemak. Ramalan ialah kategori yang sama sekali berbeza, dan dua yang paling kerap dirujuk dalam tulisan tentang masa depan kerja wajar dinamakan sebagai dakwaan dengan penulis dan kaedah dan bukan diulang sebagai fakta mantap.
WEF Future of Jobs: Tinjauan Jangkaan Majikan
Future of Jobs Report 2025 World Economic Forum menjangkakan 170 juta pekerjaan baharu dan 92 juta peranan disingkirkan menjelang 2030, pertambahan bersih 78 juta, dengan "gangguan" pekerjaan (penciptaan ditambah penyingkiran digabungkan) menyentuh kira-kira 22% pekerjaan hari ini. Ini dibina daripada tinjauan majikan yang besar, bukan data pekerjaan yang diperhatikan, kerana 2030 belum berlaku. Ia isyarat yang benar-benar berguna tentang apa yang dijangka majikan dan sudah dirancang. Ia bukan ukuran apa yang telah dilakukan AI kepada pekerjaan, dan menganggap tinjauan berpandangan ke hadapan sebagai keputusan sejarah ialah kesilapan paling biasa dalam liputan masa depan kerja.
Gartner: Keraguan tentang AI Agentik pada Skala Besar
Sementara itu, penganalisis Gartner sendiri ialah sumber salah satu ramalan paling sinis yang meluas dirujuk: bahawa lebih 40% projek AI agentik akan dibatalkan sebelum akhir 2027, didorong oleh kos yang meningkat, nilai perniagaan yang tidak jelas, dan kawalan risiko yang lemah. Anushree Verma dari Gartner telah menunjuk kepada "agent washing," iaitu apabila chatbot dan alat automasi sedia ada dilabel semula sebagai ejen autonomi tanpa keupayaan baharu di sebalik label itu, sebagai pemacu jangkaan yang dibesar-besarkan yang kemudian runtuh apabila bertembung dengan keperluan pengeluaran. Ramalan yang meramalkan kegagalan wajar diteliti sama seperti yang meramalkan kejayaan: ia anggaran berpengetahuan daripada penganalisis yang menjejaki dakwaan vendor dengan rapi, bukan hasil yang pernah diperhatikan sesiapa.
Apa yang Belum Ditunjukkan oleh Bukti
Bersikap tepat tentang apa yang kita tidak tahu sama pentingnya dengan memetik apa yang kita tahu. Penyelidikan di atas tidak menetapkan:
- Sama ada peningkatan produktiviti peringkat tugas diterjemahkan kepada kehilangan pekerjaan bersih, pertambahan pekerjaan bersih, atau kebanyakannya penyusunan semula cara pekerja sedia ada menghabiskan masa mereka. Angka WEF ialah unjuran berasaskan tinjauan, bukan hasil yang diperhatikan.
- Sama ada peningkatan produktiviti dalam kajian terkawal yang sempit kekal sepanjang minggu bekerja penuh, setahun penuh, atau merentasi kerja yang kurang berskrip daripada sembang sokongan pelanggan atau tugas pengekodan bermasa.
- Mengapa AI membantu pemula lebih daripada pakar dalam sesetengah keadaan (sokongan, penulisan) tetapi nampaknya memperlahankan pakar dalam yang lain (kajian pengekodan METR), selain teori yang munasabah tetapi belum terbukti bahawa overhed semakan lebih penting apabila seseorang sudah mempunyai kepakaran yang cuba dibekalkan oleh AI.
- Sama ada jurang semasa antara penerimaan AI yang tinggi dan nilai perusahaan yang diukur rendah ialah kelewatan integrasi sementara, seperti yang dicadangkan bingkai MIT NANDA, atau siling yang lebih tahan lama pada apa yang boleh ditambah alat ini tanpa reka bentuk semula proses yang lebih mendalam.
Tiada satu pun ketidakpastian itu menjadi sebab untuk menunggu dan melihat. Ia sebab untuk menganggap ini seperti mana-mana persoalan empirikal yang belum selesai: perhatikan kajian, bukan dek vendor, dan kemas kini rancangan anda apabila bukti yang lebih baik tiba dan bukannya terkunci pada angka tajuk utama bulan ini.
Menggunakan Bukti dalam Praktik
Pengajaran praktikal bagi sesiapa yang merancang bilangan kakitangan, perkakasan atau kemahiran semula sekitar AI ialah mengasingkan setiap dakwaan yang anda dengar ke dalam satu daripada dua bakul sebelum bertindak. Bakul pertama: hasil yang diukur, dengan kajian yang dinamakan, sampel yang dinyatakan, dan kaedah yang boleh anda baca. Bakul kedua: ramalan, dengan peramal yang dinamakan dan kaedah yang dinyatakan tentang cara mereka sampai ke situ. Mencampuradukkan kedua-duanya ialah tempat rancangan menjadi salah, sama ada itu bermakna melabur berlebihan berdasarkan tinjauan niat atau melabur terlalu sedikit berdasarkan satu kajian pengekodan yang dipertikaikan. Organisasi yang berjaya sekarang, menurut McKinsey dan MIT NANDA, menganggap penerimaan AI sebagai masalah pengukuran berterusan dan bukan pelancaran sekali sahaja, disiplin yang sama di sebalik membina budaya sedia AI dan pasukan manusia-ejen yang berfungsi hari demi hari dan bukan sekadar kelihatan baik dalam slaid.

Co-Founder, Rework.com
On this page
- Fakta Utama
- Apa Sebenarnya Maksud "AI Mengubah Kerja"
- Bukti yang Diukur: Apa yang Ditemui Kajian Terkawal
- Sokongan Pelanggan: Kajian Pusat Panggilan Stanford
- Pengekodan: Dua Ujian, Dua Tahun Berbeza, Dua Jawapan Berbeza
- Penulisan dan Kerja Pengetahuan: Eksperimen Noy dan Zhang
- Dapatan yang Diukur Sepintas Lalu
- Penerimaan Tinggi. Kesan yang Diukur Tidak Sekata. Jurang Itu Ada Namanya.
- McKinsey: Penerimaan Tanpa Transformasi
- MIT NANDA dan Jurang GenAI
- Apa Dakwaan Ramalan, Siapa yang Membuatnya, dan Bagaimana
- WEF Future of Jobs: Tinjauan Jangkaan Majikan
- Gartner: Keraguan tentang AI Agentik pada Skala Besar
- Apa yang Belum Ditunjukkan oleh Bukti
- Menggunakan Bukti dalam Praktik