AIが仕事をするときのパフォーマンス管理:アウトプットの代わりに何を評価するか
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AIが仕事をするときのパフォーマンス管理とは、評価の対象を、人がどれだけ生み出したかから、その成果の背後にある判断へと移すことです。どの問題を解くことを選んだか、出荷する前に何を検証したか、あえて何を外したか、そして周囲の人をより良くしたかどうかが対象になります。エージェントがその大半を数秒で生成できるようになれば、アウトプットの量は信頼できる指標ではなくなり、量を基準にしたままの評価プロセスは、最も明晰に考える人ではなく、最も大声でプロンプトを打つ人に報いることになります。
重要なポイント
- AIを頻繁に使う人のうち、成果が思わしくなくてもAIによる仕事の再発明を組織が評価していると答えたのはわずか13%で、この数字は「フロンティア・プロフェッショナル」ではおよそ2倍になります(26%対11%)。出典:Microsoft, 2026 Work Trend Index, "Agents, Human Agency, and the Opportunity for Every Organization"
- マイクロソフト自身の2026年のデータは、AIユーザーを不均一な能力マップに分けています。スキルと組織の支援の両方を持つ「フロンティア・プロフェッショナル」が16%、「ブロックされた主体性」(スキルはあるが支援がない)が10%、「停滞」(スキルも支援も低い)が16%、そして50%が未発達の「新興ゾーン」にいます。出典:Microsoft, 2026 Work Trend Index
- マネージャーがAIの導入を積極的に支援している従業員のエンゲージメントは48%で、その支援がない従業員の30%を上回ります。また、最も高い生産性評価は、マネージャーの支援がある場合に3倍になります(33%対9%)。出典:Gallup, "Employee Engagement Remains Flat as AI Adoption Accelerates," 2026年7月
- 2023年から2026年にかけての6億2,300万件のコード変更の分析では、AI支援のコミットが一般的になって以来、コードの重複が81%増え、レガシーコードのリファクタリングが74%減ったことがわかりました。アウトプットの量が増えていても、スキルの向上を証明するのではなく、品質の低下を覆い隠している可能性があることを示す証拠です。出典:GitClear/GitKraken research, reported by LeadDev, 2026年7月
アウトプットの量がシグナルとして機能しなくなった理由
ナレッジワークの歴史の大半において、人がどれだけ生み出したかは、その人がどれだけ優れているかを測る使える代用品でした。クローズしたチケットが多い、出荷した行数が多い、仕上げたデッキが多い。これらはスキルや努力とゆるやかに相関していたため、数えるのは簡単で、判断するのは難しいという理由で、マネージャーはそれらに頼ってきました。
AIはこの相関を壊します。人を悪くするからではなく、代理指標を無意味にするからです。若手アナリストとプリンシパルアナリストが、同じツールを使って同じ午後に12ページの市場分析を生成できるなら、ページ数は両者を区別しなくなります。壊れたキャリアの最初の一段が採用段階でたどっているのと同じ浸食ですが、ここではキャリアの途中、評価の場に現れます。2人のアナリストの間のスキルの差は埋まったのではなく、語数では見えない場所、つまり分析が正しい問いを立てていたか、誰かがその分析に基づいて意思決定を賭けられるかどうかへ移ったのです。
これは、評価制度の内部に現れるグッドハートの法則です。指標が目標になると、良い指標ではなくなります。アウトプットの指標が許容できるスキルの代理指標だったのは、より良い仕事をしないと水増しが難しかったからです。AIは、判断力が向上しなくても簡単に水増しできるようにしてしまい、まさにそれが、指標が有用なものから静かに誤解を招くものへと変わる条件です。その転換のあとも量で人を採点し続けるチームは、最も気前のよいAIサブスクリプションを持ち、レビューされていない成果物を出荷することへのためらいが最も少ない人を測っていることになります。ワークスロップ:AIが生んだ雑務が労力と当事者意識をむしばむ仕組みが受け手の側から記録していること、つまり完成して見えるのにそうではない仕事と関連します。
量は、善意で見ても、人の間で比較できなくなります。同じAIアクセスを持つ2人の従業員でも、出荷前にそれぞれがどれだけ検証するかによって、生み出す量は大きく異なりえます。エージェントの仕事を2倍丁寧に確認する人は、当然ながら、初稿をそのまま出す人より生の量は少なくなります。量に報い続ける制度は、より丁寧な働き手を静かに不利にしており、パフォーマンス管理がすべきことのほぼ逆です。しかも、その追加の確認時間は無料ではありません。AI時代のペースとバーンアウトが検証税と呼ぶのと同じ負荷であり、評価プロセスはAIが解放したと想定していますが、実際には時間が移動しただけなのです。
代わりに評価すべきもの
量を外すなら、評価は、より偽装しにくく、より良いプロンプトでは水増ししにくいものへ移る必要があります。次の4つは、かなり有効です。
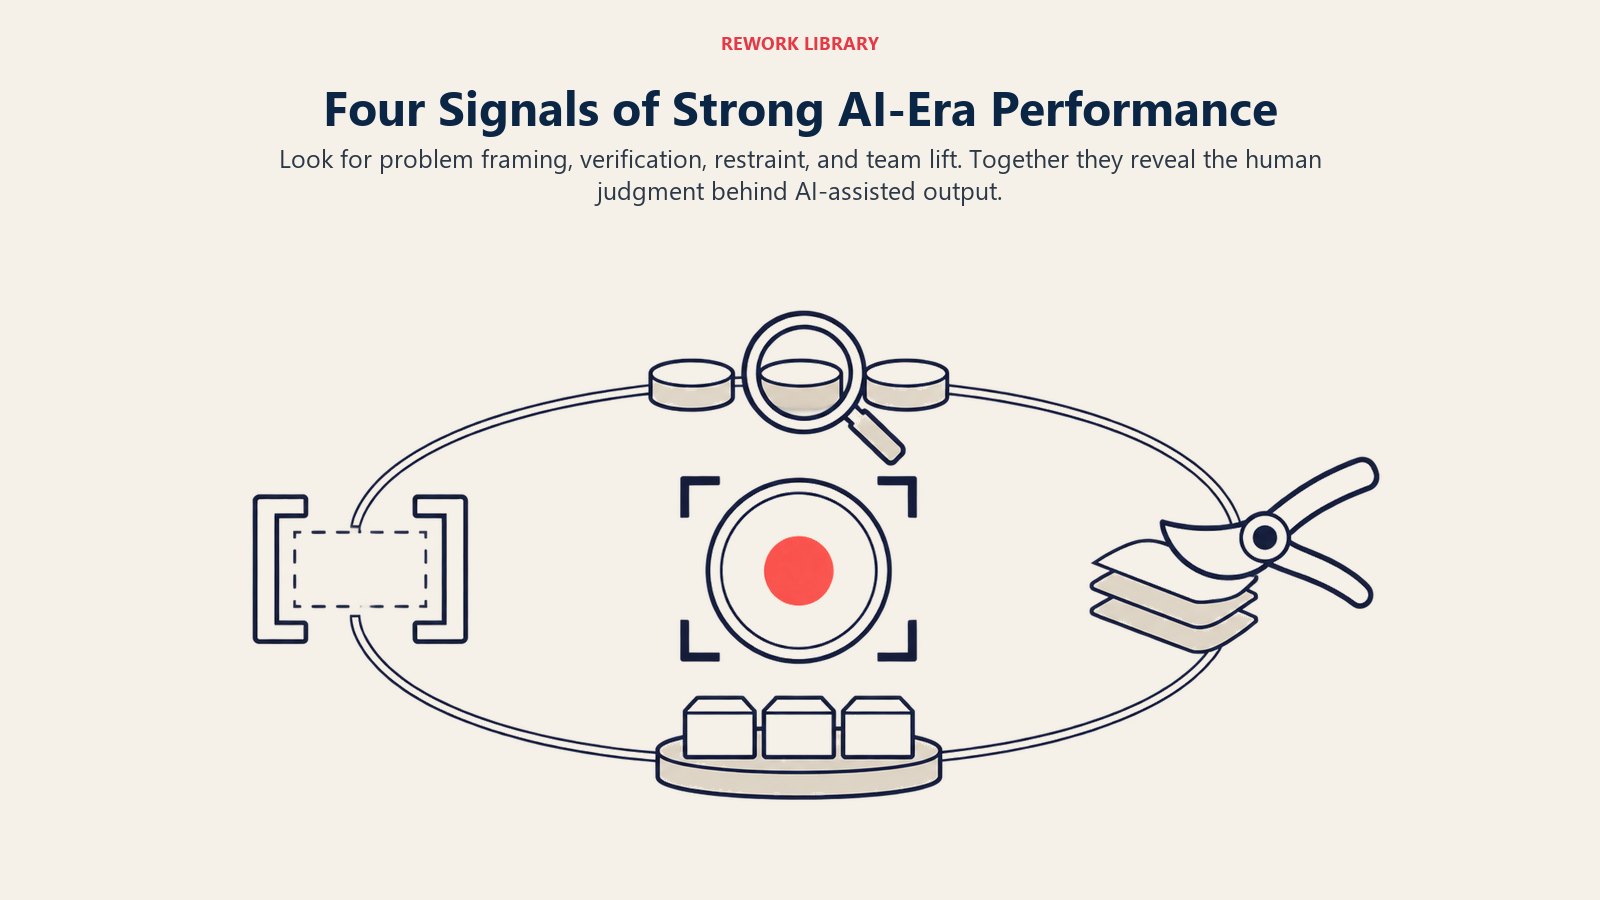
判断と問題の定義
誰かが何かを生成する前に、どの問題が解く価値があるか、どう定義するかを誰かが決めています。その決定は最終的なアウトプットには見えず、完全に人間のものです。その人が何に取り組むことを選び、どんな別の定義を退け、それはなぜかを尋ねてください。ここでの優れた答えは、磨き上げられた成果物に勝ります。間違った問いに答える磨き上げられた成果物は、役に立たないより悪いからです。費用がかかり、説得力があるからです。
検証の質
「AIがこれを作った」と「これは正しい」の間のギャップは、今、実際の仕事の大半が行われる場所であり、まさに人間の判断力を鋭く保つ:AI時代のスキル低下のパラドックスがスキルの側面から扱っているギャップです。AIで下書きしたかどうかではなく、主張、数字、提案を外に出す前に、どのように検証したかを評価してください。引用された統計の出典を確認したか。数字を別の方法で計算し直したか。提案を、明らかな反論に対してストレステストしたか。顧客が見る前に自分のエージェントのミスを見つける人は、仕事をしています。ミスを転送する人は、どちらがどれだけ速く働いたかにかかわらず、していません。
何を出荷しないと選んだか
過小評価されているシグナルが、自制です。AIはあらゆるものの5つのバージョンを安価に生成できるようにするため、もう一度見直す代わりに平凡な4番目の下書きを出荷することは、今や時間の制約ではなく選択です。まだ十分に良くないという理由で、何を削り、簡素化し、送らないと決めたかを尋ねてください。「時間切れでした」が以前よりずっと弱い言い訳になった世界で、基準の使える代理指標になります。
チームの能力をどう引き上げたか
AIが行き渡ったチームで最もレバレッジの高い仕事の一部は、どの個人のアウトプットにも見えません。誰かが作って共有したプロンプトのテンプレート、悪いエージェント出力を見つけたあとに書いた検証チェックリスト、ある提案がなぜ間違っていたかを若手の同僚に説明して理解させたことなどです。重要なカルチャー指標(と捨てるべき虚栄の指標)は、虚栄の数字の代わりにこうした行動を追跡するという、より広い主張をしています。評価面談は、個人のレベルで同じことをすべきです。個人のアウトプットは平均的に見えても、3人の同僚を測定可能なほど良くしたチームメンバーは、最も失いたくない人であることがよくあります。
古いシグナルと新しいシグナル
古いシグナルは、速さ、量、仕上がりを数えます。新しいシグナルは、問題の定義、検証、擁護できるか、そして結果が持ちこたえるかを調べます。
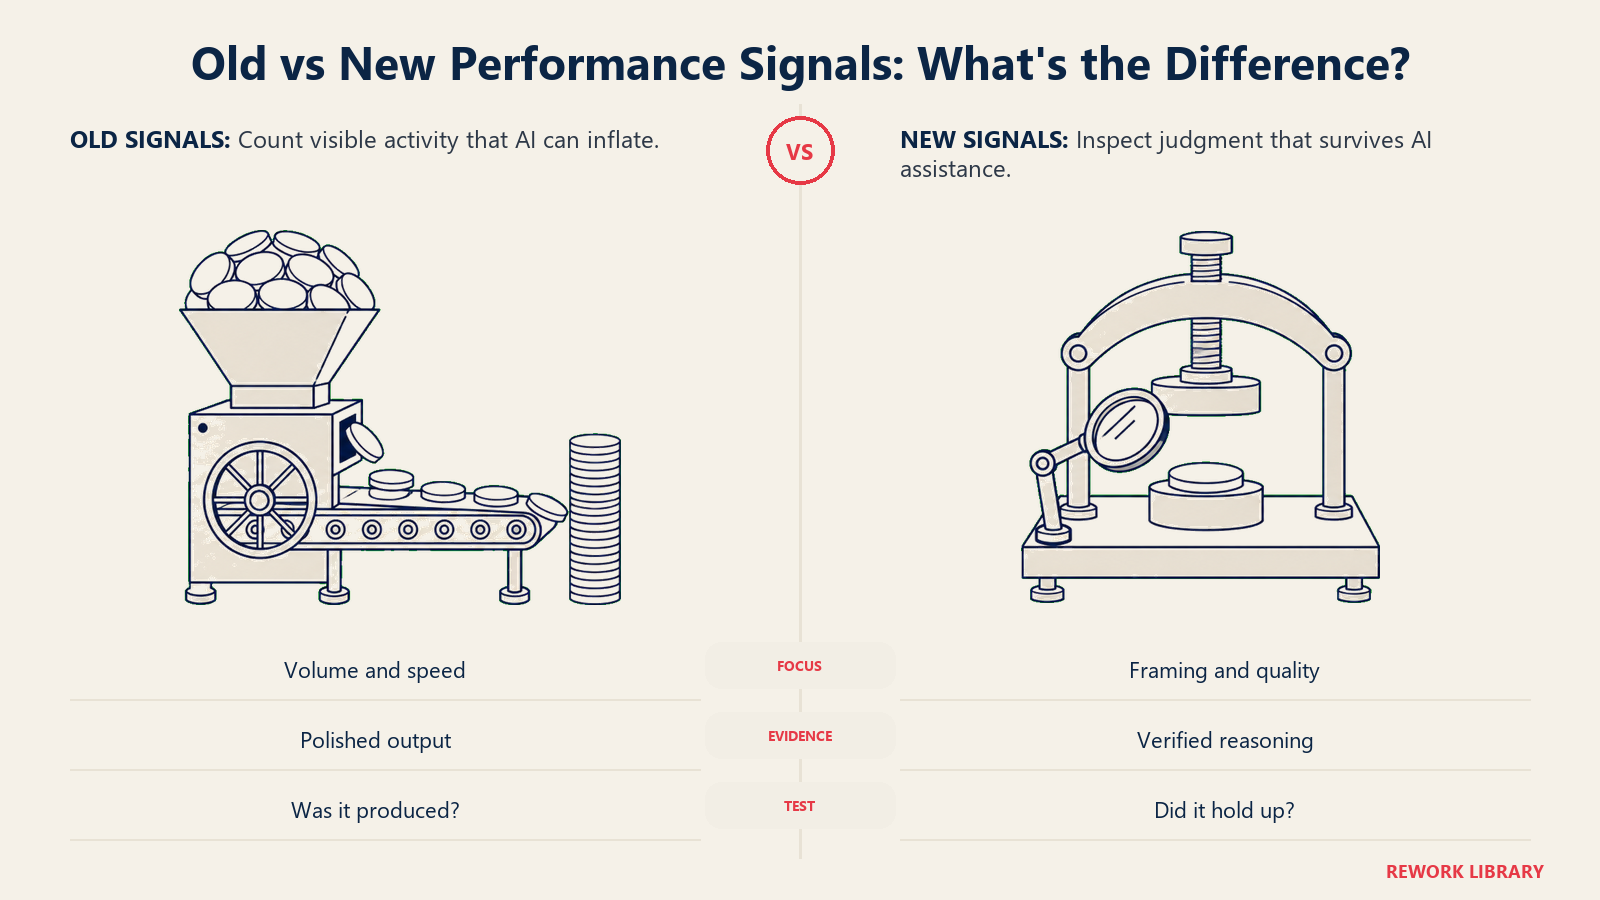
| 古いパフォーマンスシグナル | AIがそれを壊す理由 | 代わりに使うもの |
|---|---|---|
| アウトプットの量(クローズしたチケット数、書いた語数、作成したデッキ数) | AIはアクセスがある誰にとっても、スキルにかかわらず量を何倍にもするため、もはや優れたパフォーマーと弱いパフォーマーを分けられない | 仕事の背後にある判断:どの問題を選び、それはなぜか |
| 完了までの速さ | AIは初稿にかかる時間コストを劇的に縮めるため、速さは能力よりもツールへのアクセスを反映する | 初稿までの時間だけでなく、検証の工程を含めた正解に至るまでの時間 |
| 最終成果物の仕上がりや流暢さ | AI支援の下書きはデフォルトで仕上がっているため、流暢さは作成者が内容を理解していることを示さなくなる | 補助なしで、質問を受けても内容を擁護できるか |
| 使ったツールや機能の数 | 利用数は勝手に水増しされ、スキルではなく習慣で操作できる | 出荷前にAIのエラーを見つけた証拠 |
| 個人のタスク数 | チームメイトへの指導や共有チェックリストの作成のように、タスクチケットのない仕事を無視する | 本人のキューだけでなく、チームの能力への貢献 |
| 会議やチケットの「クローズ」ステータス | エージェントは、根本の問題が解決されなくてもチケットをクローズできる | 同じ問題が後で再発するか、その頻度はどのくらいか |
公平性の問題:AIへのアクセスとスキルは均等に分布していない
全員が同じAI能力を持つと暗黙のうちに想定する評価制度は、不均一な土俵で人を比較して、それを公平と呼んでいます。マイクロソフト自身の2026年のWork Trend Indexは、調査したAIユーザーをおおまかに4つの層に分けています。複雑な仕事でエージェントを使うスキルと組織の後ろ盾の両方を持つ「フロンティア・プロフェッショナル」が16%、スキルはあるのにライセンスや支援がなく使えない「ブロックされた主体性」が10%、どちらもない「停滞」が16%、そしておよそ半分が未発達の中間ゾーンにいます。同じ才能を持つ2人の従業員が、どのチームにいるか、マネージャーがどのツールを承認したかによって、まったく異なる層に振り分けられることがあります。
これは評価に直接の影響を及ぼします。ある人のマネージャーがフロンティア級のAIシートを用意し、その活用を積極的にコーチングし、別の人のマネージャーがそうしなかった場合、2人のアウトプットを直接比較して測っているのは、その人ではなく、マネージャーの手配の判断です。ギャラップの2026年7月のデータは、別の角度からこれを裏づけています。マネージャーがAI活用を積極的に支援している従業員のエンゲージメントは48%で、支援がない従業員の30%を上回り、最も高い自己申告の生産性向上は、マネージャーの後ろ盾があると4倍近くになります(33%対9%)。従業員だけでなくマネージャーも、その人がどれだけAI支援のアウトプットを現実的に生み出せるかに大きく関わる要因です。
アクセスとは別に、スキルの差という形の同じ問題もあります。具体的で検証可能なプロンプトを書き、結果を確認することを身につけた人もいれば、最初に返ってきたものをそのまま受け入れる人もいます。どちらも、努力の差としては現れません。判断の差として現れます。これは都合よく、アクセスの問題を迂回します。スループットではなく思考を採点すれば、不均等なアクセスの影響ははるかに小さくなります。同じ公平性の計算は、そのまま報酬にも及びます。AIを使いこなす一人のアウトプットが、紙の上では5人分に見えるときに何が崩れるかについては、AI時代の報酬と公平性をご覧ください。
AIで水増しされたスループットに耐える目標設定
ほとんどの目標設定のフレームワークは、人が生み出せる速さにおおよその上限があることを前提に作られました。AIは、一部のタスクではその上限を取り払い、他のタスクではそのままにするため、その転換より前に書かれた目標は、四半期のうちに、ばかばかしいほど簡単になるか、意図せず無意味になることがよくあります。AIの生産性パラドックスは、この問題の組織レベルの姿です。導入は進んでいるのに、測定されるビジネス上の効果は同じ割合では伴っておらず、「AIをより多く使った」が本質的に「より多くの価値を届けた」と等しいとみなす目標を疑う理由になります。
いくつかの調整が有効です。
- 従業員が水増しできる活動ではなく、ビジネスが検証できる成果に目標を結びつける。 「20本の記事を公開する」は、レビューされていない出力でも達成できるため、今では悪い目標です。「オーガニックコンテンツからの有望リード率をX%改善する」は、AIにはコンバージョンを偽造できないため、有効です。
- スループットの目標と並べて、検証の基準を明示的に設ける。 目標にAI支援のアウトプットが関わるなら、その種類の仕事で「レビュー済み」が何を意味するかを、曖昧な願望ではなく、誰かが責任を負えるチェックリストとして示します。
- 従来の年次や半期のサイクルよりも頻繁に目標を見直す。 先四半期のツールの能力を前提に設定した目標は、エージェントの能力の進化の速さを考えると、数か月で古くなりえます。1月には妥当だった目標が、本人の成長とは無関係な理由で、6月には負荷の低いものになりうるのです。
- 「より多くが出荷されたか」と「本人が成長したか」を切り分ける。 マネージャーは両方を追跡できますが、測っているものは異なり、コンピテンシーや昇進の面談に属するのは後者だけです。
- プロンプトをもっと頑張るだけでは達成できない目標を書く。 判断を加えることなく、より多くのAI出力を生成するだけで満たせる目標は、パフォーマンス管理が測るために存在するものを測っていません。
この世界での評価面談の進め方
面談の仕組みは中身ほどには変わりませんが、5年前よりも重要になる習慣がいくつかあります。
「教えて」ではなく「見せて」と尋ねる
何を達成したかを要約してもらう代わりに、一つの仕事を最初から最後までたどってもらいます。AIに何を求め、何が返ってきて、何を変え、それはなぜか。これは、結果の要約ではできない形で判断を浮かび上がらせます。また、AIが成果だけでなく仕事そのものへのアプローチをどう変えたかを尋ねる自然な機会にもなります。
仕事の評価と人の評価を切り分ける
成果物が優れているのは、ツールが優れているからかもしれません。直接尋ねてください。同じツールをスキルの低い人が使っていたら、これのどの部分が違っていただろうか。正直な答えが「あまり変わらない」なら、その成果物は、紙面でどれほど良く見えても、評価の根拠としては弱いものです。実際には、ここで説明責任が決まります。説明責任の文化をどう築くかは、オーナーシップはツールではなく人に結びつかなければならないと論じており、評価は、その原則が保たれるか、静かに崩れるかを分ける場です。
AI活用力への期待を、暗黙のままにせず明示する
マイクロソフトの2026年のデータでは、AIユーザーのうち、成果が思わしくなくてもAIでワークフローを再発明したことに報われていると感じているのは13%にとどまることがわかりました。同社はこのギャップを「変革のパラドックス」と呼んでいます。人々は働き方を変える準備ができているのに、インセンティブが追いついていないのです。このギャップを埋めることは、誰もがすでに知っていると想定するのではなく、その役割にとって優れたAI活用とはどういうものかを、評価の場ではっきり伝えることから始まります。
「ここでは使わないと選んだ」を許容する余地をつくる
AIをまったく使わないのが正しい判断のときもあります。顧客に関わるセンシティブな下書き、判断の重い交渉、特定の声が必要な文章などです。どこでもAIの利用を暗黙のうちに評価する評価制度は、それが間違った道具であるときにも、手を伸ばすように人を仕向けてしまいます。
正直なリスク:企業が単にノルマを引き上げる
経営陣が、AIで水増しされたアウトプットに対して、単にバーを上げ、新しい基準を「パフォーマンス」と呼ぶだけでは、どれも機能しません。それは何も考える必要がありません。チームが月に20本のレポートを出していて、AIが35本を可能にするなら、新しい目標を35本に設定し、仕事は変わっていないと宣言すればよいのです。それはAIに適応するパフォーマンス管理ではありません。同じ人員でより多くのアウトプットを引き出しながら、「期待に応えている」の基準を静かに引き上げているだけで、追加の15本のレポートが良いものかどうか、誰かがそれを検証する時間があったかどうかを問うていません。
ここで、公平性の問題と測定の問題が交わります。AI支援のスループットに合わせて引き上げられたノルマは、チーム全体でアクセスとスキルが均等だと想定していますが、本記事で見たとおり、実際にはそれは崩れています。また、追加のアウトプットが元のアウトプットと同じ価値を持つことも想定していますが、GitClearの研究は、それが安全ではないことを示唆しています。そこではAI支援のコミットが増える一方で、重複コードが81%跳ね上がり、古いコードのリファクタリングが74%減りました。アウトプットが増え、同時に品質が悪化したのです。営業、サポート、コンテンツのチームも、自分たちの数字を新しい下限として扱う前に、同じ問いを投げかけるべきです。
この移行の正直な形は、より遅く、経営陣のスライドにとってはあまり見栄えのしないものです。AIが取り戻してくれた時間のうち、一部は検証に、一部はチーム全体の能力の引き上げに、そして一部だけが純粋な追加のスループットに向けられるべきです。そのすべてをスループットとして受け取り、その結果を「パフォーマンス」と呼ぶ会社は、人をより厳しく働かせ、その会計をチャットボットに外注しています。これを正しく行う組織は、機械が初稿を作れるようになった今、従業員に何を違うやり方でするよう求めているのかを、具体的に言えるリーダーがいる組織でしょう。その答えの一部が、「生のアウトプットは減らすが、より多くのものに全面的に責任を持つ」であることも含めてです。このトレードオフについて、声に出して明確にすることこそ、AI職場における社会契約が、雇用主が今や従業員に負っていると論じていることです。「期待に応えている」の基準を静かに引き上げ、誰も理由を尋ねないことを願うのではなく。
この変化の組織設計の側面、つまり、マネージャーが、検証の負荷が重い仕事をする、より少ない人数を監督するときにスパン・オブ・コントロールがどう変わるかについては、実行者からオーケストレーターへ:AIが個人貢献者の仕事をどう書き換えているかとAIを補完するスキル:今、実際に採用し育成すべきものをご覧ください。

Co-Founder, Rework.com