Performance Management, wenn KI die Arbeit erledigt: Was statt des Outputs zu bewerten ist
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Performance Management, wenn KI die Arbeit erledigt, bedeutet, zu verschieben, was bewertet wird: von der Menge, die ein Mensch produziert hat, hin zum Urteilsvermögen hinter dem Produzierten, nämlich welches Problem er sich vorgenommen hat, was er vor der Auslieferung verifiziert hat, was er bewusst weggelassen hat und ob er die Menschen um sich herum besser gemacht hat. Die Output-Menge ist kein verlässliches Signal mehr, sobald ein Agent den Großteil davon in Sekunden erzeugen kann, und ein Beurteilungsprozess, der weiter an der Menge hängt, belohnt am Ende, wer am lautesten promptet, nicht, wer am klarsten denkt.
Wichtige Fakten
- Nur 13 % der häufigen KI-Nutzenden sagen, ihre Organisation belohne die Neuerfindung von Arbeit mit KI auch dann, wenn das Ergebnis hinter den Erwartungen zurückbleibt, und diese Zahl verdoppelt sich bei „Frontier Professionals" ungefähr (26 % gegenüber 11 %). Quelle: Microsoft, 2026 Work Trend Index, „Agents, Human Agency, and the Opportunity for Every Organization"
- Microsofts eigene Daten von 2026 teilen KI-Nutzende in eine ungleiche Fähigkeitslandkarte: 16 % sind „Frontier Professionals" mit Kompetenz und organisatorischer Unterstützung, 10 % sind „blockierte Handlungsfähigkeit" (kompetent, aber ohne Unterstützung), 16 % sind „ins Stocken geraten" (geringe Kompetenz, geringe Unterstützung), und 50 % liegen in einer unterentwickelten „Emergent Zone". Quelle: Microsoft, 2026 Work Trend Index
- Beschäftigte, deren Führungskräfte die KI-Einführung aktiv unterstützen, berichten 48 % Engagement gegenüber 30 % bei denen ohne diese Unterstützung, und die höchsten Produktivitätsbewertungen verdreifachen sich bei Unterstützung durch die Führungskraft (33 % gegenüber 9 %). Quelle: Gallup, „Employee Engagement Remains Flat as AI Adoption Accelerates", Juli 2026
- Die Analyse von 623 Millionen Code-Änderungen von 2023 bis 2026 ergab, dass die Code-Duplikation um 81 % gestiegen und das Refactoring von Legacy-Code um 74 % gesunken ist, seit KI-gestützte Commits üblich wurden, ein Beleg dafür, dass wachsender Output sinkende Qualität verdecken kann, statt wachsendes Können zu beweisen. Quelle: GitClear/GitKraken-Forschung, berichtet von LeadDev, Juli 2026
Warum die Output-Menge als Signal ausgedient hat
Über den größten Teil der Geschichte der Wissensarbeit war es ein brauchbarer Ersatz dafür, wie gut jemand ist, wie viel er produzierte. Mehr geschlossene Tickets, mehr ausgelieferte Zeilen, mehr fertiggestellte Präsentationen: Das korrelierte lose mit Können und Einsatz, und Führungskräfte stützten sich darauf, weil Zählen leicht und Urteilen schwer ist.
KI bricht diese Korrelation, nicht indem sie Menschen schlechter macht, sondern indem sie den Stellvertreter bedeutungslos macht. Wenn ein Junior-Analyst und ein Principal Analyst am selben Nachmittag mit demselben Tool eine zwölfseitige Marktanalyse erzeugen können, unterscheidet die Seitenzahl sie nicht mehr. Das ist dieselbe Erosion, die Die gebrochene unterste Sprosse bei der Einstellung nachzeichnet, nur zeigt sie sich hier mitten in der Laufbahn, in der Beurteilung: Die Kompetenzlücke zwischen den beiden Analysten hat sich nicht geschlossen, sie ist an eine Stelle gewandert, die ein Wortzähler nicht sehen kann, nämlich ob die Analyse die richtige Frage gestellt hat und ob jemand eine Entscheidung darauf wetten würde.
Das ist das Goodhart'sche Gesetz innerhalb von Performance-Systemen: Wird ein Maß zum Ziel, hört es auf, ein gutes Maß zu sein. Output-Metriken waren erträgliche Stellvertreter für Können, weil sie sich kaum aufblähen ließen, ohne auch bessere Arbeit zu leisten. KI macht sie mühelos aufblähbar, ohne entsprechenden Gewinn an Urteilsvermögen, und genau unter dieser Bedingung kippt eine Metrik still von nützlich zu irreführend. Ein Team, das nach diesem Umschwung weiter nach Menge bewertet, misst, wer das großzügigste KI-Abo und die geringste Scheu vor dem Ausliefern ungeprüften Outputs hat, verwandt mit dem, was Workslop: Wie KI-generierte Beschäftigungsarbeit Einsatz und Ownership untergräbt aus Sicht der Empfangenden dokumentiert: Arbeit, die fertig aussieht und es nicht ist.
Menge ist selbst bei bestem Willen auch nicht mehr zwischen Personen vergleichbar. Zwei Beschäftigte mit identischem KI-Zugang können sehr unterschiedliche Mengen produzieren, je nachdem, wie viel Verifikation jeder vor der Auslieferung leistet. Wer die Arbeit eines Agenten doppelt so sorgfältig prüft, produziert zu Recht weniger rohe Menge als jemand, der den ersten Entwurf ausliefert. Ein System, das weiter Menge belohnt, bestraft still den sorgfältigeren Beschäftigten, nahezu das Gegenteil dessen, was Performance Management leisten soll. Diese zusätzliche Prüfzeit ist auch nicht kostenlos. Es ist dieselbe Last, die Tempo und Burnout im KI-Zeitalter als Verifikationssteuer beschreibt, Stunden, von denen ein Beurteilungsprozess annimmt, KI habe sie freigesetzt, während sie sie tatsächlich nur verschoben hat.
Was stattdessen zu bewerten ist
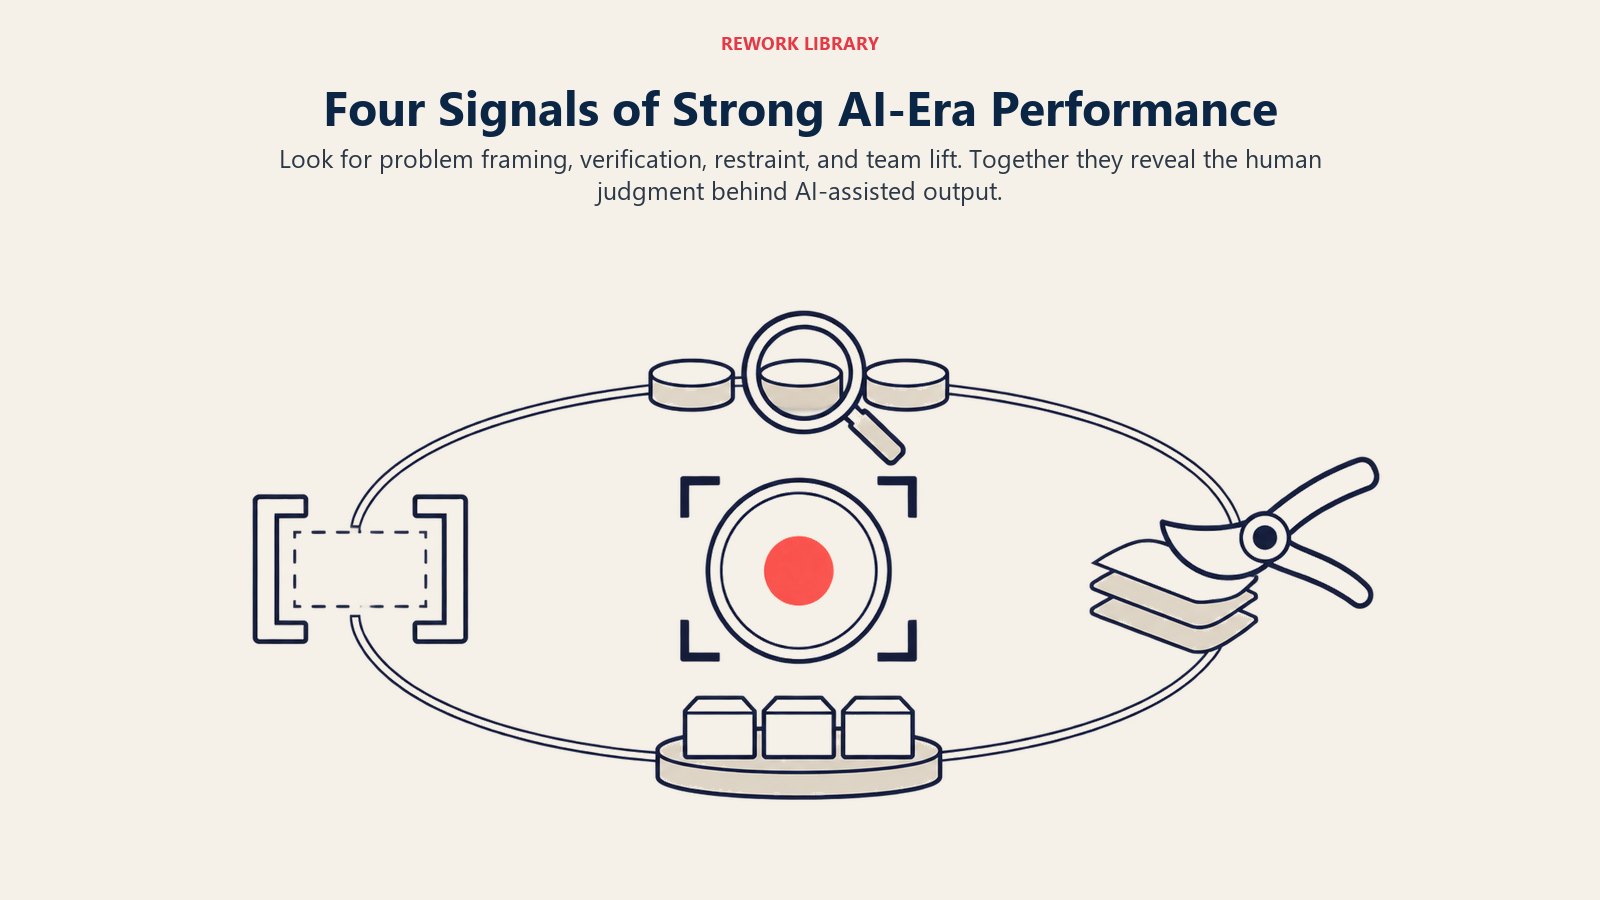
Fällt die Menge weg, muss die Beurteilung zu Dingen wandern, die schwerer zu fälschen und schwerer durch einen besseren Prompt aufzublähen sind. Vier halten sich einigermaßen gut.
Urteilsvermögen und Problemrahmung
Bevor irgendjemand etwas erzeugt, hat jemand entschieden, welches Problem es wert war, gelöst zu werden, und wie es zu rahmen ist. Diese Entscheidung ist im fertigen Output unsichtbar und vollständig menschlich. Fragen Sie, woran die Person gearbeitet hat und welche alternative Rahmung sie verworfen hat, und warum. Eine starke Antwort hier schlägt ein geschliffenes Ergebnis, denn ein geschliffenes Ergebnis, das die falsche Frage beantwortet, ist schlimmer als nutzlos: Es ist teuer und überzeugend.
Qualität der Verifikation
Die Lücke zwischen „KI hat das erzeugt" und „das ist richtig" ist der Ort, an dem heute der Großteil der eigentlichen Arbeit geschieht, und genau diese Lücke behandelt Das menschliche Urteilsvermögen scharf halten: Das Entqualifizierungsparadoxon der KI bei der Arbeit von der Kompetenzseite. Bewerten Sie, wie jemand eine Behauptung, eine Zahl oder eine Empfehlung verifiziert hat, bevor sie hinausging, nicht ob er KI zum Entwerfen genutzt hat. Hat er die Quelle hinter einer zitierten Statistik geprüft? Hat er die Zahlen auf zweitem Weg gerechnet? Hat er die Empfehlung gegen ein naheliegendes Gegenargument auf die Probe gestellt? Wer den Fehler seines eigenen Agenten abfängt, bevor ein Kunde ihn sieht, macht den Job. Wer den Fehler weiterleitet, nicht, egal wie schnell beide gearbeitet haben.
Was sie nicht ausgeliefert haben
Ein unterschätztes Signal: Zurückhaltung. KI macht es billig, fünf Versionen von irgendetwas zu erzeugen, sodass das Ausliefern des mittelmäßigen vierten Entwurfs statt eines weiteren Durchgangs nun eine Entscheidung ist und keine Zeitbeschränkung. Fragen Sie, was eine Person gestrichen, vereinfacht oder nicht abgeschickt hat, weil es noch nicht gut genug war. Das ist ein brauchbarer Stellvertreter für Maßstäbe in einer Welt, in der „mir ist die Zeit ausgegangen" eine viel schwächere Ausrede ist als früher.
Wie sie die Fähigkeit des Teams gestärkt haben
Ein Teil der wirkungsvollsten Arbeit in einem KI-gesättigten Team ist im Output keiner einzelnen Person sichtbar: die Prompt-Vorlage, die jemand gebaut und geteilt hat, die Verifikations-Checkliste, die er nach dem Abfangen eines schlechten Agenten-Outputs schrieb, der Junior-Kollege, dem er erklärt hat, warum eine Empfehlung falsch war. Kulturmetriken, die zählen (und die Eitelkeitskennzahlen, die wegfallen sollten) macht den breiteren Fall dafür, solche Verhaltensweisen statt Eitelkeitszahlen zu verfolgen; Leistungsbeurteilungen sollten dasselbe auf individueller Ebene tun. Ein Teammitglied, dessen persönlicher Output durchschnittlich aussieht, das aber drei Kollegen messbar besser gemacht hat, ist oft die Person, die Sie am wenigsten verlieren wollen.
Altes Signal versus neues Signal
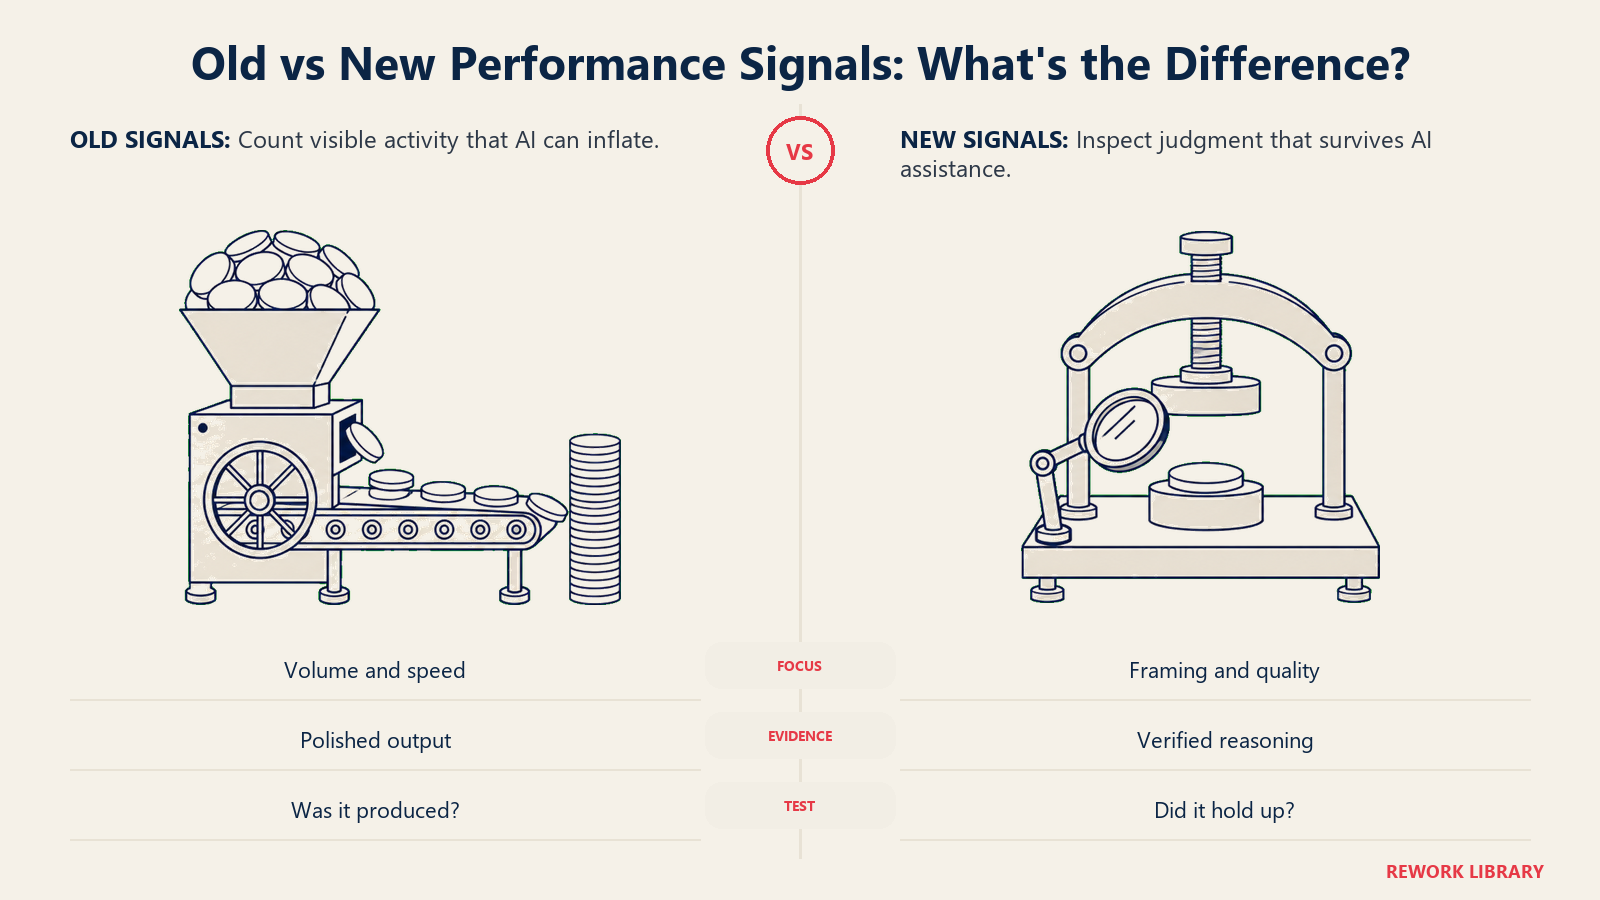
Alte Signale zählen Tempo, Menge und Politur. Neue Signale prüfen Rahmung, Verifikation, Vertretbarkeit und ob das Ergebnis Bestand hat.
| Altes Leistungssignal | Warum KI es bricht | Was stattdessen zu verwenden ist |
|---|---|---|
| Menge des Outputs (geschlossene Tickets, geschriebene Wörter, erstellte Präsentationen) | KI vervielfacht die Menge für jeden mit Zugang, unabhängig vom Können, sodass sie starke und schwache Leistungsträger nicht mehr trennt | Das Urteilsvermögen hinter der Arbeit: welches Problem gewählt wurde und warum |
| Geschwindigkeit bis zur Fertigstellung | KI lässt den Zeitaufwand für einen Erstentwurf zusammenbrechen, sodass Tempo nun eher Tool-Zugang als Fähigkeit widerspiegelt | Zeit bis zur korrekten Antwort, einschließlich des Verifikationsdurchgangs, nicht nur Zeit bis zum Erstentwurf |
| Politur oder Flüssigkeit des fertigen Ergebnisses | KI-gestützte Entwürfe sind standardmäßig geschliffen, sodass Flüssigkeit nicht mehr anzeigt, dass die Autorin den Inhalt verstanden hat | Ob die Person den Inhalt auf Nachfrage ohne Hilfsmittel verteidigen kann |
| Anzahl genutzter Tools oder Funktionen | Nutzungszahlen blähen sich von selbst auf und lassen sich durch Gewohnheit manipulieren, nicht durch Können | Belege dafür, dass ein KI-Fehler abgefangen wurde, bevor er ausgeliefert wurde |
| Anzahl individueller Aufgaben | Ignoriert Arbeit ohne Aufgabenticket, etwa einem Kollegen etwas beizubringen oder eine gemeinsame Checkliste zu bauen | Beitrag zur Fähigkeit des Teams, nicht nur zur eigenen Warteschlange der Person |
| Status „geschlossen" bei Meetings oder Tickets | Ein Agent kann ein Ticket schließen, ohne dass das zugrunde liegende Problem gelöst ist | Ob dasselbe Problem später wieder aufgeht und wie oft |
Das Fairnessproblem: KI-Zugang und Kompetenz sind nicht gleich verteilt
Ein Performance-System, das still davon ausgeht, alle hätten dieselbe KI-Fähigkeit, vergleicht Menschen auf ungleichem Feld und nennt es fair. Microsofts eigener Work Trend Index 2026 teilt die befragten KI-Nutzenden in eine grobe Vierfach-Landkarte: 16 % sind „Frontier Professionals" mit Kompetenz und organisatorischem Rückhalt, um Agenten bei komplexer Arbeit einzusetzen; 10 % sind „blockierte Handlungsfähigkeit", kompetent, aber ohne Lizenz oder Unterstützung zur Nutzung; 16 % sind „ins Stocken geraten" und haben keines von beidem; und etwa die Hälfte liegt in einer unterentwickelten Mittelzone. Zwei Beschäftigte mit identischem Talent können in sehr unterschiedlichen Gruppen landen, je nachdem, in welchem Team sie sind oder welche Tools ihre Führungskraft freigegeben hat.
Das hat direkte Folgen für Beurteilungen. Hat die Führungskraft der einen Person einen KI-Zugang auf Frontier-Niveau bereitgestellt und coacht dessen Nutzung aktiv, die der anderen aber nicht, misst der direkte Vergleich ihres Outputs die Bereitstellungsentscheidungen der Führungskraft, nicht die Person. Gallups Daten vom Juli 2026 stützen das aus anderer Richtung: Beschäftigte, deren Führungskräfte die KI-Nutzung aktiv unterstützen, berichten 48 % Engagement gegenüber 30 % bei denen ohne sie, und die höchsten selbstberichteten Produktivitätsgewinne vervierfachen sich mit Rückhalt der Führungskraft nahezu (33 % gegenüber 9 %). Die Führungskraft, nicht nur die Beschäftigte, ist ein wesentlicher Einflussfaktor dafür, wie viel KI-gestützten Output jemand plausibel erzeugen kann.
Es gibt auch eine Kompetenzvariante desselben Problems, getrennt vom Zugang. Manche haben gelernt, einen konkreten, überprüfbaren Prompt zu schreiben und das Ergebnis zu kontrollieren; andere übernehmen, was zuerst zurückkommt. Keines zeigt sich als Unterschied im Einsatz. Es zeigt sich als Unterschied im Urteilsvermögen, was das Zugangsproblem praktischerweise umgeht: Bewerten Sie das Denken, nicht den Durchsatz, und ungleicher Zugang spielt eine viel geringere Rolle. Dieselbe Fairness-Rechnung setzt sich direkt in der Vergütung fort: Was bricht, wenn der Output einer KI-gestützten Person auf dem Papier wie der von fünf Personen aussieht, behandelt Vergütung und Fairness im KI-Zeitalter.
Zielsetzung, die KI-aufgeblähten Durchsatz übersteht
Die meisten Zielrahmen wurden unter der Annahme einer ungefähren Obergrenze gebaut, wie schnell ein Mensch produzieren kann. KI beseitigt diese Obergrenze für manche Aufgaben und lässt sie bei anderen unberührt, sodass ein vor diesem Umschwung formuliertes Ziel binnen eines Quartals oft trivial leicht oder zufällig bedeutungslos wird. Das Produktivitätsparadoxon der KI ist die Unternehmensversion dieses Problems: Die Einführung ist hoch, und die gemessene Geschäftswirkung folgt nicht im selben Tempo, ein Grund, jedem Ziel zu misstrauen, das „mehr KI genutzt" als von Natur aus gleichwertig mit „mehr Wert geliefert" behandelt.
Ein paar Anpassungen halten:
- Koppeln Sie Ziele an Ergebnisse, die das Unternehmen verifizieren kann, nicht an Aktivität, die die Beschäftigte aufblähen kann. „20 Artikel veröffentlichen" ist heute ein schlechtes Ziel, weil es mit ungeprüftem Output erreichbar ist. „Die Rate qualifizierter Leads aus organischen Inhalten um X% verbessern" besteht, weil KI keine Conversion fälschen kann.
- Legen Sie neben einem Durchsatzziel ausdrücklich einen Verifikationsstandard fest. Umfasst das Ziel KI-gestützten Output, benennen Sie, was „geprüft" für diese konkrete Art von Arbeit bedeutet, nicht als vages Bestreben, sondern als Checkliste, an der jemand gemessen werden kann.
- Überprüfen Sie Ziele häufiger als im alten jährlichen oder halbjährlichen Zyklus. Ein Ziel, das auf der Tool-Fähigkeit des letzten Quartals beruht, kann angesichts des Tempos, in dem sich Agentenfähigkeiten entwickeln, binnen Monaten überholt sein; ein Ziel, das im Januar Sinn ergab, kann im Juni anspruchslos sein, aus Gründen, die nichts mit der Entwicklung der Person zu tun haben.
- Trennen Sie „wurde mehr ausgeliefert" von „ist die Person besser geworden". Eine Führungskraft kann beides verfolgen, doch sie messen Verschiedenes, und nur Letzteres gehört in ein Kompetenz- oder Beförderungsgespräch.
- Schreiben Sie Ziele, die eine Person nicht durch härteres Prompten erreichen könnte. Lässt sich ein Ziel allein durch mehr KI-Output ohne zusätzliches Urteilsvermögen erfüllen, misst es nicht das, was zu messen Performance Management da ist.
Das Beurteilungsgespräch in dieser Welt führen
Die Mechanik des Gesprächs ändert sich weniger als der Inhalt, doch ein paar Gewohnheiten zählen heute mehr als vor fünf Jahren.
Fragen Sie „zeig mir", nicht „erzähl mir"
Statt jemanden zu bitten, zusammenzufassen, was er geleistet hat, lassen Sie ihn ein Arbeitsstück von Anfang bis Ende durchgehen: was er von der KI erbeten hat, was zurückkam, was er geändert hat und warum. Das bringt Urteilsvermögen zum Vorschein, wie es eine Ergebniszusammenfassung nicht kann, und ist ein natürlicher Moment, auch zu fragen, wie KI seinen Ansatz zur Arbeit selbst verändert hat, nicht nur deren Ergebnis.
Trennen Sie die Beurteilung der Arbeit von der Beurteilung der Person
Ein Ergebnis kann hervorragend sein, weil ein Tool hervorragend ist. Fragen Sie direkt: Was daran wäre anders gewesen, wenn eine weniger qualifizierte Person dasselbe Tool genutzt hätte? Lautet die ehrliche Antwort „nicht viel", ist dieses Ergebnis ein schwacher Beleg für die Beurteilung, egal wie gut es auf der Seite aussieht. Hier wird in der Praxis auch Verantwortlichkeit entschieden: Wie Sie eine Kultur der Verantwortlichkeit aufbauen argumentiert, dass Ownership an einer Person hängen muss, nicht an einem Tool, und die Beurteilung ist der Ort, an dem dieses Prinzip entweder hält oder still verrutscht.
Benennen Sie die Erwartung an KI-Kompetenz, statt sie implizit zu lassen
Microsofts Daten von 2026 fanden, dass nur 13 % der KI-Nutzenden sich dafür belohnt fühlen, ihren Workflow mit KI neu zu erfinden, selbst wenn die Ergebnisse hinter den Erwartungen zurückbleiben, eine Lücke, die es „Transformation Paradox" nennt: Menschen sind bereit, ihre Arbeitsweise zu ändern, aber die Anreize haben nicht aufgeholt. Diese Lücke zu schließen beginnt damit, in der Beurteilung klar zu sagen, wie gute KI-Nutzung für diese Rolle aussieht, statt anzunehmen, dass es alle schon wissen.
Schaffen Sie Raum für „hier habe ich bewusst darauf verzichtet"
Manchmal ist es richtig, KI gar nicht zu nutzen: ein kundensensibler Entwurf, eine urteilsintensive Verhandlung, ein Text, der eine bestimmte Stimme braucht. Eine Beurteilung, die KI-Nutzung überall implizit belohnt, trainiert Menschen darauf, danach zu greifen, selbst wenn es das falsche Werkzeug ist.
Das ehrliche Risiko: Unternehmen erhöhen einfach die Quote
Nichts davon funktioniert, wenn die Führung auf KI-aufgeblähten Output reagiert, indem sie einfach die Messlatte hebt und die neue Basislinie „Leistung" nennt. Das erfordert kein Nachdenken: Lieferte ein Team 20 Berichte im Monat und macht KI 35 erreichbar, setzt man das neue Ziel auf 35 und erklärt den Job für unverändert. Das ist kein Performance Management, das sich an KI anpasst. Es holt mehr Output bei gleicher Stellenzahl heraus und verschiebt dabei still „erfüllt die Erwartungen" nach oben, ohne zu fragen, ob die zusätzlichen 15 Berichte etwas taugen oder ob jemand Zeit hatte, sie zu verifizieren.
Hier treffen sich das Fairnessproblem und das Messproblem. Eine Quote, die auf den KI-gestützten Durchsatz angehoben wird, setzt gleichen Zugang und gleiche Kompetenz im Team voraus, was in der Praxis, wie dieser Beitrag gezeigt hat, nicht hält. Sie setzt auch voraus, dass der zusätzliche Output denselben Wert hat wie der ursprüngliche, was die GitClear-Forschung als nicht sicher nahelegt: KI-gestützte Commits stiegen dort zusammen mit einem Sprung von 81 % bei dupliziertem Code und einem Rückgang von 74 % beim Refactoring alten Codes, mehr Output und schlechtere Qualität zugleich. Ein Vertriebs-, Support- oder Content-Team sollte dieselbe Frage an die eigenen Zahlen stellen, bevor es sie als neue Untergrenze behandelt.
Die ehrliche Version dieses Übergangs ist langsamer und weniger schmeichelhaft für die Folien einer Führungsmannschaft: Ein Teil der Zeit, die KI zurückkauft, sollte in Verifikation fließen, ein Teil in die Stärkung der kollektiven Fähigkeit des Teams, und nur ein Teil in zusätzlichen Rohdurchsatz. Ein Unternehmen, das alles als Durchsatz nimmt und das Ergebnis „Leistung" nennt, treibt seine Leute härter an und lagert die Buchhaltung an einen Chatbot aus. Die Organisationen, die das richtig machen, werden die sein, deren Führungskräfte konkret sagen können, was sie von Beschäftigten nun anders erwarten, da eine Maschine einen Erstentwurf erzeugen kann, einschließlich der Teilantwort „weniger Rohoutput erzeugen, aber mehr davon voll vertreten". Genau diesen Zielkonflikt offen auszusprechen, ist das, was der Gesellschaftsvertrag der KI bei der Arbeit als etwas beschreibt, das Arbeitgeber den Beschäftigten nun schulden, statt „erfüllt die Erwartungen" still nach oben zu verschieben und zu hoffen, dass niemand nach dem Grund fragt.
Zur Organisationsdesign-Seite dieses Wandels, einschließlich der Frage, wie sich die Führungsspanne verändert, wenn eine Führungskraft weniger Menschen mit verifikationsintensiverer Arbeit betreut, siehe Vom Ausführenden zum Orchestrator: Wie KI den Job des Individual Contributors neu schreibt und KI-komplementäre Kompetenzen: Wofür heute tatsächlich einzustellen und zu entwickeln ist.

Co-Founder, Rework.com
On this page
- Wichtige Fakten
- Warum die Output-Menge als Signal ausgedient hat
- Was stattdessen zu bewerten ist
- Urteilsvermögen und Problemrahmung
- Qualität der Verifikation
- Was sie nicht ausgeliefert haben
- Wie sie die Fähigkeit des Teams gestärkt haben
- Altes Signal versus neues Signal
- Das Fairnessproblem: KI-Zugang und Kompetenz sind nicht gleich verteilt
- Zielsetzung, die KI-aufgeblähten Durchsatz übersteht
- Das Beurteilungsgespräch in dieser Welt führen
- Fragen Sie „zeig mir", nicht „erzähl mir"
- Trennen Sie die Beurteilung der Arbeit von der Beurteilung der Person
- Benennen Sie die Erwartung an KI-Kompetenz, statt sie implizit zu lassen
- Schaffen Sie Raum für „hier habe ich bewusst darauf verzichtet"
- Das ehrliche Risiko: Unternehmen erhöhen einfach die Quote