AIイニシアチブのタグ付け:オペレーターのための実践的タクソノミー
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
ほとんどの組織は、AIポートフォリオを自ら選んでいるわけではありません。気づけば積み上がっているのです。
営業はアウトリーチツールをパイロット導入します。サポートはチャットボットを購入します。財務は経費分類ツールを使い始めます。マーケティングはコンテンツ生成のサブスクリプションを追加します。それぞれの判断は、単独で見れば筋が通っていました。しかし6ヶ月後、会社が実際に何を保有していて、何が重複し、何が未測定で、どれがレビューゲートなしで静かに稼働しているのかを、誰も明確に把握していません。
経営陣が「AI戦略」を求めたとき、正直な答えは、たいてい部門別に並べたベンダー名のリストです。それは戦略ではありません。調達の履歴です。取締役会での議論や、本格的なガバナンスの質問には耐えられません。
根本的な問題は、チームがAIツールを購入していることではありません。各ツールが何をするのかを、比較可能な言葉で説明する共通の語彙がないことです。その語彙がなければ、重複の検出も、ギャップの発見も、リスクの監査も、進捗の報告もできません。説明できないものは、管理できません。
タグ付けタクソノミーがこれを解決します。すべてのイニシアチブに共通のフィールドを与えます。どのCapabilityを使うか、どのデータを消費するか、どのパターンに従うか、人間はループのどこにいるか。この作業を一度実施すれば、ノイズのように見えていたポートフォリオが読み取れるようになります。そして、読み取れるポートフォリオは管理できます。
タクソノミーなしに追跡が崩れる理由
自然な本能は、ベンダー名(「Gong、Intercom、そしてあの経費ツール」)またはチーム(「営業は2つのツール、サポートは1つ」)でAIイニシアチブをカタログ化することです。3つのイニシアチブまではそれで機能します。8つになると崩れます。
共通のタクソノミーなしには、次のことになります:
- 2つのチームが誰も比較しなかったためにほぼ同一のGenerateツールを稼働させる
- 誰かがあると仮定していた人間のレビューのないExecuteワークフロー
- 「AI搭載分析」に年間4万ドル払っているのにゼロのPredict Capability
- 営業に5つのイニシアチブ、カスタマーサクセスにゼロ、誰もアンバランスに気づいていない
タグ付けはポートフォリオを読みやすくします。読みやすいポートフォリオは管理されます。管理されないポートフォリオは漂流し、重複し、劣化します。
7つのタグ付けフィールド
ACE Frameworkが語彙を提供します。これらの7つのフィールドがその語彙を実践的なカタログに変えます。
1. 使用するACE Capability。 このイニシアチブはどの5つのCore Capabilityを使うか?Ingestは生データを取り込む。Analyzeは分類し意味を抽出する。Predictはスコアリングと予測。Generateはテキスト、画像、またはコードのドラフト。Executeは送信し、コミットし、更新し、ルーティングする。AIのアウトリーチツールはIngest + Analyze + Generateです。不正検知システムはIngest + Analyze + Predict + Executeです。どのCapabilityがアクティブかを知ることで、イニシアチブがどのカテゴリーのガバナンスを必要とするかがわかります。
2. 消費するデータタイプ。 このイニシアチブはどのようなデータタイプで動作するか?テキスト / 構造化データ / 画像 / 音声 / 動画 / コード / 時系列。ほとんどのイニシアチブは1つか2つで動作します。このフィールドはデータの準備が実際に整っているかどうかを明らかにします。
3. 支配的なパターン。 これはACE Frameworkの第2レベルへの橋渡しです。約10のパターンがビジネスAIのユースケースの90%をカバーします。
- RAG Assistant(Ingest + Analyze + Generate):内部知識のQ&A
- Scoring + Routing(Ingest + Analyze + Predict + Execute):リードのトリアージ、チケットの優先順位付け
- Vision Extract(Ingest + Analyze + Execute):請求書・契約書のOCRからデータベースへ
- Meeting Intelligence(Ingest + Analyze + Generate + Execute):CRMへの書き戻しが伴う通話サマリー
- Anomaly Agent(Ingest + Analyze + Predict + Execute):不正検知、支出アラート
4. Human-in-loopの役割。 ワークフローの中で人間はどこに位置するか?レビューゲート(アクション前に承認)、モニタリング(各インスタンスを承認せずにアウトプットを確認)、または不在(チェックポイントなしにAIが行動)。ほとんどの組織は、タグ付け中に思っていたより多くの「不在」ループを持っていることを発見します。それがガバナンスの会話をトリガーする洞察です。
5. ビジネス機能。 営業 / サポート / マーケティング / 財務 / HR / オペレーション / IT / プロダクト / 法務。このフィールドはカバレッジのギャップを素早く明らかにします。10のイニシアチブのうち7つが営業にありカスタマーサクセスにゼロなら、それは意図的な選択であるべきで、偶然ではいけません。
6. ステージ。 アイデア / パイロット / ロールアウト / スケール / Sunset。ステージの可視性は最も一般的なポートフォリオの失敗を防ぎます:誰もスケールするかKillするかの決定を所有せずに18ヶ月間「パイロット」に止まっているイニシアチブ。
7. ROIステータス。 未測定 / 測定済みでポジティブ / 測定済みでネガティブ。ほとんどの組織はAIイニシアチブの大部分が未測定であることを発見します。それは失敗ではありません。情報です。そして見えないものは管理できません。
タグ付けテンプレート
スプレッドシートまたはNotionデータベースにそのまま使える実践的なフォーマットを示します。
initiative: "Auto-draft sales outreach"
ace_capabilities: [ingest, analyze, generate]
data_types: [text, structured]
pattern: ad-hoc
human_in_loop: review-gate
function: sales
stage: pilot
roi_status: measured-positive
owner: "Sarah Chen, Sales Ops"
notes: "担当者は送信前に各メールを承認。担当者あたり週約40分節約。"
すべてのイニシアチブについてこれを実行してください。不確かなものについても。部分的な情報は何もないよりも有用です。
なぜこれが機能するか
比較可能性。 すべてのイニシアチブが同じ語彙を使うと、並べ替え、フィルタリング、グループ化できます。「人間のレビューなしにExecuteを使っているものすべてを見せて」は30秒で答えられる質問です。タグなしでは、45分の会話です。
重複の検出。 Generate + Textイニシアチブを実行している2つのチームはしばしば異なるベンダーで同じことをしています。タグビューはそれを目に見える形にします。統合するかどうかはビジネス上の決定です。しかし、意識的にそれを行うべきです。
ギャップの特定。 Executeツールがゼロということは、すべてのAIの利益が草稿とサマリーから来ていることを意味します。すべての重要なアクションを誰かが手動で行っています。それがリスク許容度に合っているかもしれません。しかし、それを知ることに価値があります。
経営層への報告。 「私たちのAIポートフォリオ:6つのGenerateツール、2つのPredict、レビューゲートのある1つのExecute、3つが未測定」は意味のある1文の取締役会更新です。ベンダー名のリストと比べてみてください。
実践でのタグ付け:10イニシアチブの監査
実際のポートフォリオ監査がどのようなものかを示します。これは単一の企業のデータではなく、私たちが定期的に見るパターンを組み合わせたものです。
タグ付け前のポートフォリオ:
| # | イニシアチブ | 機能 | できると思っていること |
|---|---|---|---|
| 1 | Gong | 営業 | 通話を録音する |
| 2 | Intercom Fin | サポート | チケットに答える |
| 3 | ChatGPT(チームライセンス) | マーケティング | コンテンツのドラフト |
| 4 | Jasper | マーケティング | ブログコンテンツ |
| 5 | HubSpot AI | 営業 | リードスコアリング |
| 6 | Ramp AI | 財務 | 経費の分類 |
| 7 | Otter.ai | オペレーション | ミーティングメモ |
| 8 | DocuSign Lumi | 法務 | 契約書レビュー |
| 9 | 「請求書ボット」 | 財務 | 不明 |
| 10 | Notion AI | プロダクト | 執筆支援 |
タグ付け後:
| # | ACE Capability | パターン | Human-in-loop | ROI |
|---|---|---|---|---|
| 1 Gong | Ingest、Analyze、Generate、Execute | Meeting Intelligence | モニタリング | 測定済みポジティブ |
| 2 Intercom Fin | Ingest、Analyze、Generate | RAG Assistant | レビューゲート | 未測定 |
| 3 ChatGPT | Analyze、Generate | Ad hoc | 不在 | 未測定 |
| 4 Jasper | Analyze、Generate | Ad hoc | 不在 | 未測定 |
| 5 HubSpot AI | Ingest、Analyze、Predict | Scoring + Routing | モニタリング | 未測定 |
| 6 Ramp AI | Ingest、Analyze、Execute | Vision Extract | レビューゲート | 測定済みポジティブ |
| 7 Otter.ai | Ingest、Analyze、Generate | Meeting Intelligence | モニタリング | 未測定 |
| 8 DocuSign Lumi | Ingest、Analyze、Generate | RAG Assistant | レビューゲート | 未測定 |
| 9 請求書ボット | Ingest、Analyze、Execute | Vision Extract | 不在 | 未測定 |
| 10 Notion AI | Generate | Ad hoc | 不在 | 未測定 |
監査で明らかになったこと:
10のイニシアチブのうち7つがGenerateを使っています。企業は要約とコンテンツ作成に大きく投資しており、それ以外はほとんどありません。誰もその決定を意識的にしていませんでした。
イニシアチブ3と4(ChatGPT + Jasper)は、マーケティングコンテンツに対するAnalyze + Generateを両方行っています。2つのベンダー、同じパターン。統合の会話が必要です。
イニシアチブ9、「請求書ボット」は、Human-in-loopのないExecuteワークフローです。名前が無害に聞こえたため誰もフラグを立てませんでした。タグ付けの実践がそれを表面化しました。
カスタマーサクセスへのイニシアチブはゼロ。10のうち8つが未測定。測定されている2つ、GongとRamp AIの両方に、ローンチ前にベースラインを設定したオペレーションオーナーがいました。これは偶然ではありません。
驚くべき発見: この企業は多様なAIポートフォリオを持っていると思っていました。実際にはいくつかの分析アドオンを持つライティングツールのポートフォリオでした。
タグ付けセッションの実施方法
コンサルタントは必要ありません。正しい人たちと30分あれば十分です:オペレーション責任者、テクノロジースタックを担当する人、そしてアクティブなAIイニシアチブを持つ各主要機能の代表者1名。
共有スプレッドシートを開いてください。ライブで各イニシアチブを一緒に進めてください。非同期に送り出して回答を集めないでください。タグ付け中に起きる会話に価値があります。何かをどのように分類するかについての意見の不一致が最も有用な瞬間です。「パイロット」と「ロールアウト」のどちらかについて2人が合意できなければ、そのイニシアチブには明確な所有権がないサインです。メモを取ってください。その曖昧さはデータです。
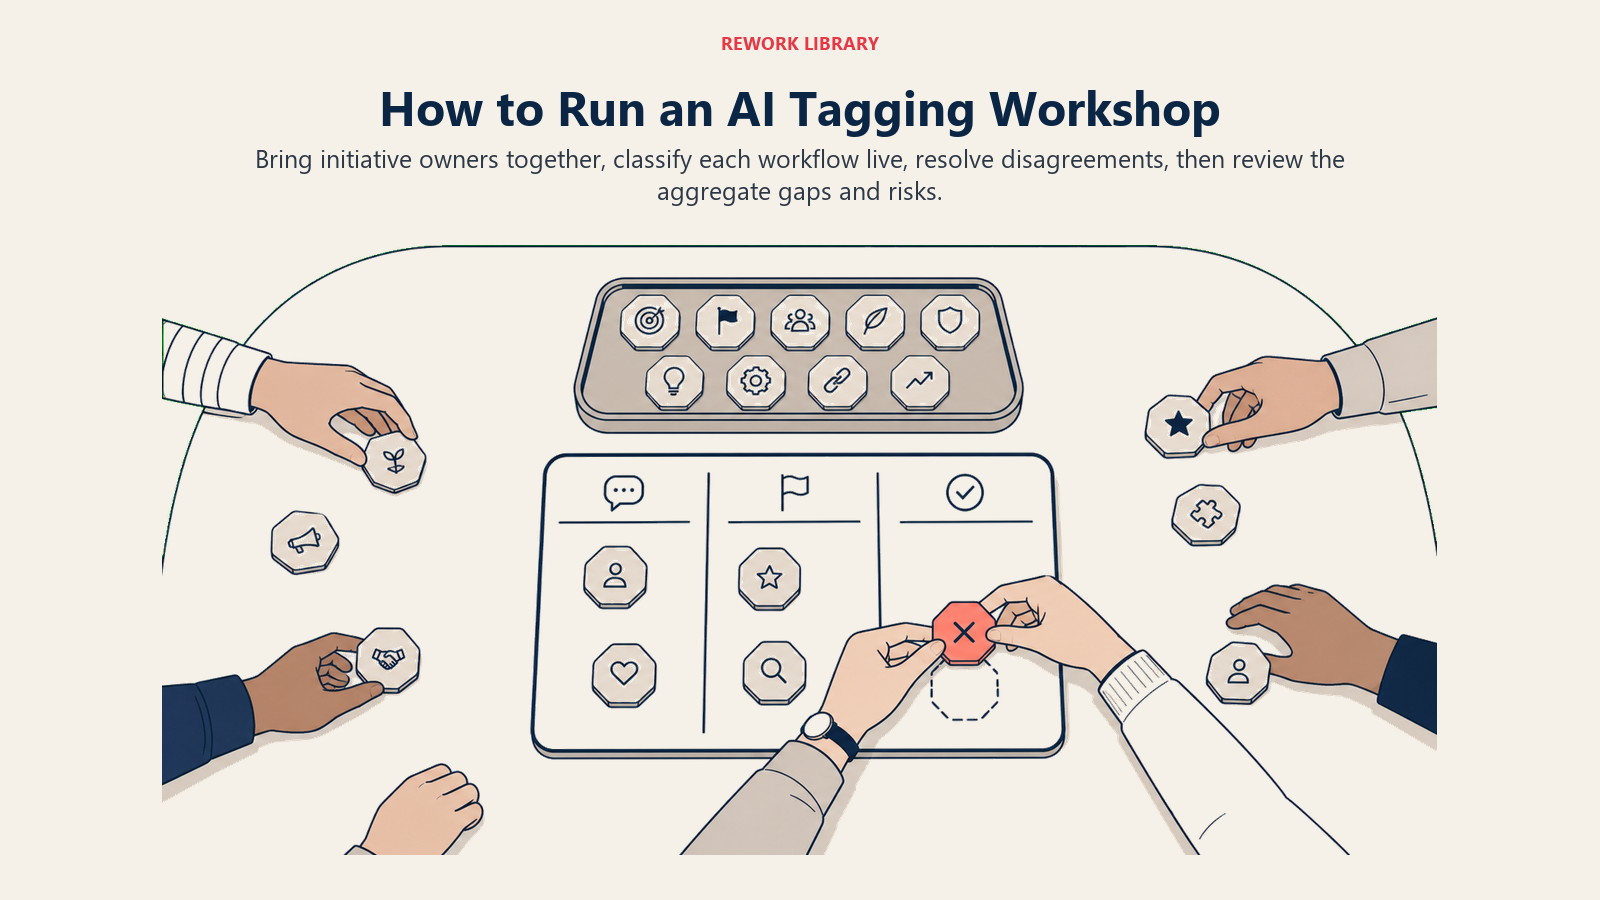
ファシリテーターがいれば30分で8〜12のイニシアチブをカバーできます。最初の数件は語彙をチームが学ぶ時間として最も時間がかかります。その後速くなります。
セッション後、集計ビューを生成してください。Capability別、機能別にいくつのイニシアチブがあるか?何が未測定か?驚きを探してください。それらが次のAI戦略会話のアジェンダアイテムです。
四半期ごとのサイクルと終わらせる時期
一度タグ付けを行ってください。その後、四半期ごとに再タグ付けしてください。パイロットはロールアウトになります。ロールアウトはより良いツールが来たときにSunsetされます。ステージとROIステータスは急速に古くなります。最初のセッションが十分であれば、四半期ごとの再タグ付けは15分かかります。差分を更新するだけです:新しいイニシアチブ、ステージの変更、新たに測定されたROI。
しかし、タグ付けにはオーバーヘッドがあります。1つか2つのAIツールしかないなら、省略してください。意思決定の会話が必要であり、タクソノミーではありません。そしてタグ付けが官僚的になってきたら(洞察ではなく完全性のために追加されたフィールド)、止めてください。実際に使うフィールドだけに切り戻してください。誰も開かないデータベースの12フィールドよりも、四半期ごとにレビューされる4フィールドのスプレッドシートの方が優れています。
タグ付けが機能しているという正しいシグナル:人々が他の会話でその語彙を使うことです。財務責任者が「それはExecuteワークフロー、レビューゲートが必要だ」と言うとき、タクソノミーはチームの思考方法の一部になっています。それが目標です。
メタ的な利点:教育としてのタグ付け
タグ付けセッションの実施はスプレッドシートを作る以上のことをします。リーダーシップチームに構造化された言葉でAIについて考えることを教えます。
イニシアチブを一貫してタグ付けするチームは、そうしないチームよりも早くAIリテラシーを構築します。ACE語彙を使って10のイニシアチブを分類するころには、オペレーション責任者は5冊のAI書籍を読んだほとんどの人よりGenerate vs. Executeの境界線をよく理解しています。財務責任者は請求書ボットがなぜレビューゲートを必要としたかを理解しています。営業責任者はクリーンなデータがDeploymentの一部でなかったためにリードスコアリングツールが成果を出せなかった理由を理解しています。
ポートフォリオビューを得ます。また、ベンダーにより良い質問をし、重複をより早く発見し、より精度高くAIワークフローをガバナンスするチームも得ます。それがタグ付けの狭い主張です。現実のものです。
次のステップ:第2レベルのパターン
このコレクションはACE Frameworkとその基盤を紹介しました。タグ付けはそこからの橋渡しです。
チームがACE語彙を使ってイニシアチブをタグ付けできるようになると、次の自然なステップはそれらのイニシアチブが従うパターンを理解することです。ACE Frameworkはこれらを第2レベルに整理します:業界や機能をまたいで現れる10の繰り返しCapabilityの組み合わせです。ポートフォリオ監査でMeeting IntelligenceまたはScoring + Routingを発見した場合、次のコレクションはすでに生きてきたものへの正式な名前のように感じられるでしょう。
このコレクションの関連記事:
- AIユースケースの読み方:ベンダーピッチと社内提案へのACEの適用
- Generate vs. Executeの境界線:タグ付けセッションが表面化するガバナンスの問題
- 7つのデータタイプ:ビジネスAIを動かすもの、あなたのイニシアチブを供給しているもの
- ほとんどのAIフレームワークが失敗する理由:なぜこのフレームワークが異なる方法で構築されているかの正直なコンテキスト
タグ付けは「AIを試している」から「AIポートフォリオを持っている」への移行です。それは小さなシフトではありません。ポートフォリオは管理し、測定し、改善できます。実験のコレクションは蓄積するだけです。
今四半期から始めてください。セッションは30分かかります。その明確さは長続きします。
Principal Solution Architect