Systèmes d'alerte précoce : détecter le risque de rétention avant qu'il ne soit trop tard
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Une équipe CS était à bout. Chaque mois, 3 à 5 clients déposaient une demande de résiliation sans le moindre signe avant-coureur. Quand le CS intervenait, les décisions étaient prises, les budgets réaffectés et les alternatives choisies.
Le VP a posé la question à l'équipe : « Pourquoi ne voyons-nous rien venir ? »
Un CSM a répondu : « Nous faisons un point de suivi chaque trimestre. Les clients nous disent qu'ils sont satisfaits, puis ils disparaissent. »
Une fois l'analyse faite, les problèmes sautaient aux yeux :
- Les points de contact trimestriels passaient à côté de tout ce qui se produisait entre deux appels
- Les clients évitaient les conversations délicates sur leur insatisfaction
- L'usage baissait depuis des mois sans que personne ne le remarque
- Il n'existait aucune méthode systématique pour repérer les signaux de risque
L'équipe a donc construit un système d'alerte précoce : alertes automatiques sur 15 indicateurs avancés, suivi quotidien du health score, détection des anomalies d'usage, suivi des changements chez les parties prenantes et analyse des schémas dans les tickets de support.
Trois mois plus tard, les résultats étaient nets. Les comptes à risque étaient identifiés 6 semaines plus tôt en moyenne. Le taux de réussite des interventions est passé de 25 % à 67 %. Huit départs ont été évités, soit 520 k$ d'ARR. Et les CSM passaient moins de temps à éteindre des incendies, davantage à travailler proactivement sur la réussite de leurs clients.
La leçon à en tirer : plus vous repérez le risque tôt, plus il est facile de sauver le client. Un système d'alerte précoce vous donne la fenêtre de temps nécessaire pour intervenir efficacement.
Le concept de système d'alerte précoce
Indicateurs avancés et indicateurs retardés
Les indicateurs retardés vous disent ce qui s'est déjà produit. Quand ils se déclenchent, il est souvent trop tard.
Réfléchissez-y : un client envoie son préavis de résiliation. Un renouvellement échoue. Le NPS tombe au niveau de détracteur. Le contrat arrive à échéance sans qu'aucune discussion de renouvellement n'ait eu lieu. Qu'ont-ils tous en commun ? Presque aucun temps pour agir. Les clients ont déjà décidé.
Les indicateurs avancés fonctionnent autrement. Ils signalent un problème potentiel avant qu'il ne produise ses effets, et vous laissent une fenêtre pour intervenir.
Vous constatez une baisse d'usage de 30 % sur 60 jours. Un sponsor exécutif cesse de se connecter. Les tickets de support explosent. Aucun contact depuis 45 jours. Un gel des budgets est annoncé. Chacun de ces signaux vous donne de l'air.
L'écart de temps est déterminant :
- Indicateurs retardés : 0 à 7 jours pour sauver le compte (quasi impossible)
- Indicateurs avancés : 30 à 90 jours de préavis (taux de sauvegarde de 60 à 80 %)
Voici ce que cela donne concrètement.
Avec un indicateur retardé : au mois 1, l'usage baisse mais personne ne s'en aperçoit. Au mois 2, il continue de baisser et personne ne le surveille de façon systématique. Au mois 3, le client envoie son préavis de résiliation. Vous le découvrez enfin. Il vous reste 30 jours, en raison du préavis contractuel. Votre taux de sauvegarde ? 15 %.
Avec un indicateur avancé : au mois 1, l'usage chute de 25 % et déclenche une alerte. Le CSM contacte le client dans les 48 heures. Il identifie la cause : les nouveaux membres de l'équipe n'avaient pas été intégrés. Le CSM propose un nouvel accompagnement d'onboarding. L'usage repart. Votre taux de sauvegarde ? 75 %.
Concentrez donc votre système d'alerte précoce sur les indicateurs avancés.
Gérer le signal et le bruit
Tous les signaux ne révèlent pas un vrai risque. Trop de fausses alertes provoquent une fatigue d'alerte, et votre équipe finit par tout ignorer.
Un signal est un changement de comportement qui prédit réellement le churn. Par exemple, le nombre d'utilisateurs actifs chute de 40 % en 30 jours, et votre historique montre une corrélation de 70 % avec le churn. Cela appelle une prise de contact immédiate du CSM.
Le bruit est un changement de comportement qui ne prédit pas le churn. Les utilisateurs actifs reculent de 10 % pendant les congés, mais il s'agit d'un schéma saisonnier et les utilisateurs reviennent toujours. Vous surveillez, sans déclencher d'alerte.
Pour trouver cet équilibre, quatre éléments sont nécessaires :
D'abord, l'analyse historique. Quels signaux ont réellement prédit un churn ? Lesquels ont déclenché une alerte alors que le client a renouvelé ? Calculez la précision de chaque type d'alerte.
Ensuite, le réglage des seuils. Fixez des seuils qui détectent le vrai risque sans noyer votre équipe sous les faux positifs. Il s'agit d'arbitrer entre sensibilité (détecter tous les risques) et spécificité (éviter les fausses alertes).
Troisièmement, les règles contextuelles. Tenez compte de la saisonnalité, comme les congés et la clôture de l'exercice. Appliquez des seuils propres à chaque segment : les clients enterprise ne se comportent pas comme les SMB. Prenez aussi en compte le stade du cycle de vie, car un nouveau client n'agit pas comme un client installé.
Enfin, la suppression d'alertes. Mettez les alertes en sourdine pendant les périodes d'usage faible connues. Regroupez les alertes liées pour envoyer une seule notification au lieu de cinq.
Votre objectif : que 70 à 80 % des alertes correspondent à un risque réel.
Les fenêtres de temps pour intervenir
Le temps dont vous disposez entre l'alerte et un éventuel churn est votre facteur de réussite décisif.
Les fenêtres courtes vous laissent 1 à 2 semaines. Un échec de paiement survient et vous avez moins de 14 jours pour réagir. Cela exige une action immédiate et urgente.
Les fenêtres moyennes vous laissent 30 à 60 jours. L'usage recule de 30 % depuis 2 mois et le renouvellement est dans 30 à 60 jours. C'est le moment d'une intervention proactive et d'une analyse des causes profondes.
Les fenêtres longues vous laissent plus de 90 jours. Le client a manqué un jalon d'onboarding, mais le moment habituel du churn est à plus de 90 jours. Vous pouvez corriger le tir et relancer l'onboarding.
Visez des fenêtres moyennes à longues. Ce sont les plus exploitables : vous avez le temps de comprendre la cause profonde, de mettre en place une solution, et vous obtiendrez les meilleurs taux de sauvegarde.
Le principe de conception des alertes : déclenchez-les assez tôt pour permettre une intervention réfléchie, pas seulement une réponse d'urgence.
Niveaux de gravité et escalade
Toutes les alertes ne se valent pas. Il vous faut un cadre de gravité qui dise à votre équipe comment réagir.
Critique (P0) : risque de churn immédiat sur un compte de forte valeur. Pensez à un échec de paiement, une demande de résiliation ou le départ du sponsor exécutif. Le délai de réponse est inférieur à 4 heures. Escalade vers le CSM + le Manager + les Sales.
Élevée (P1) : risque important nécessitant une intervention sous 24 heures. Le health score passe sous 40, l'usage baisse de plus de 40 % en 30 jours, ou plusieurs tickets de support P1 arrivent. Le CSM et le Manager s'en mêlent.
Moyenne (P2) : risque modéré. Une action est nécessaire dans la semaine. Le health score se situe entre 40 et 60, l'engagement recule ou les tickets de support augmentent. Le délai de réponse est de 2 à 3 jours. Le CSM s'en charge.
Faible (P3) : alerte précoce. À surveiller et à traiter de façon proactive. Formation manquée, légère baisse d'usage ou aucun contact depuis 30 jours. Le délai de réponse est de 1 à 2 semaines. Cela fait partie du workflow habituel du CSM.
Définissez clairement les déclencheurs d'escalade et les personnes impliquées à chaque niveau de gravité. Votre équipe ne doit pas avoir à deviner.
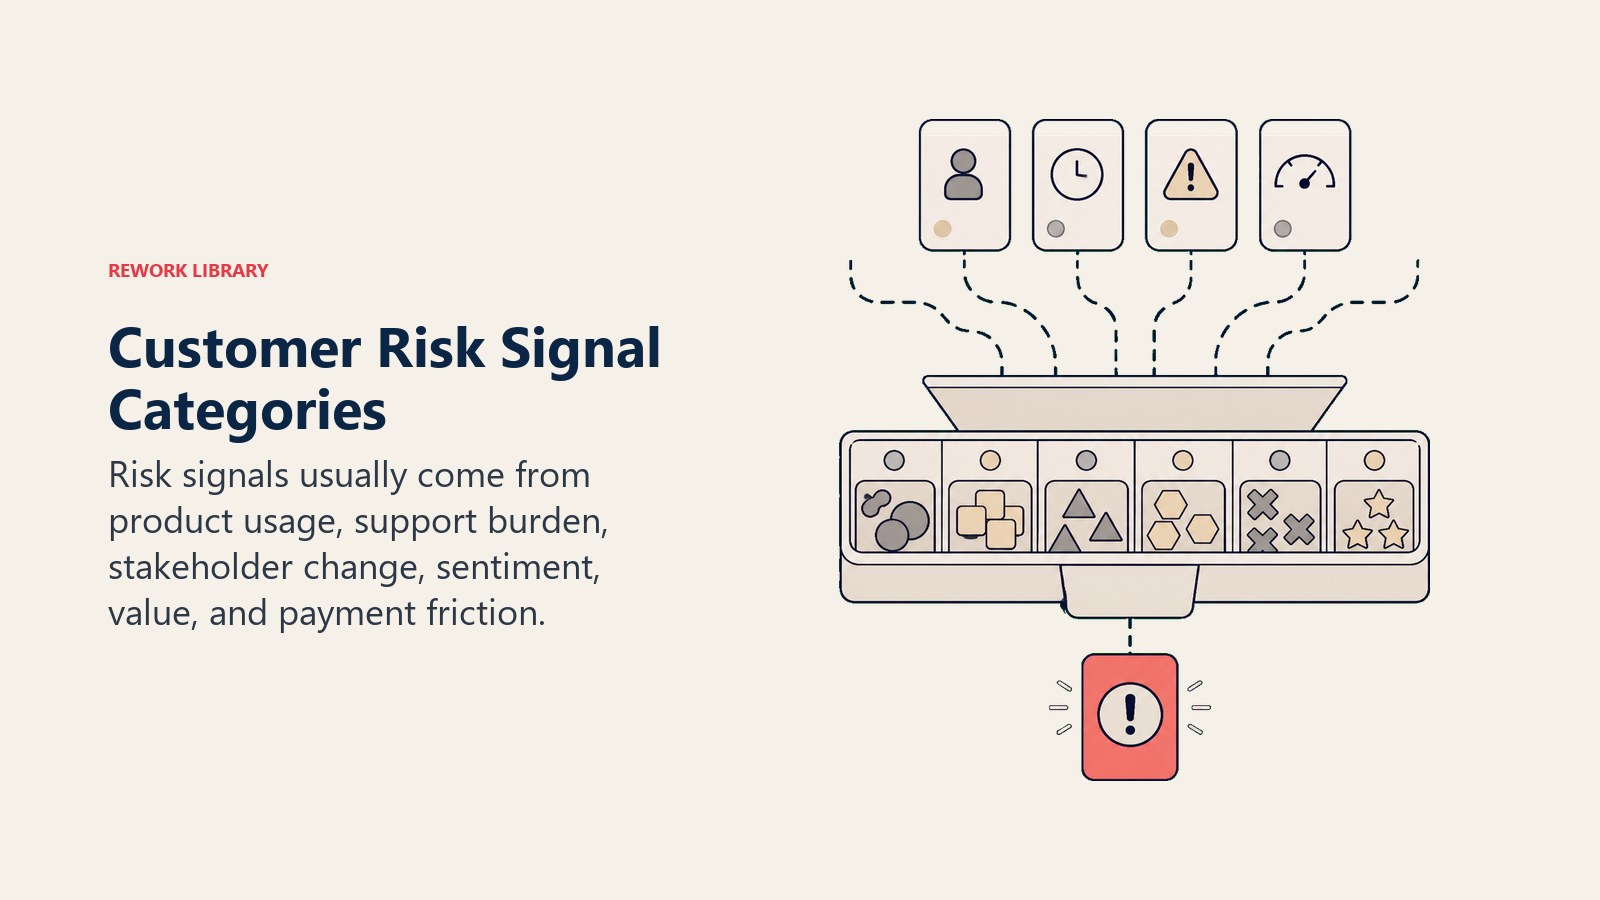
Les catégories de signaux de risque
Baisse d'usage et désengagement
L'usage est le meilleur prédicteur de rétention. Une baisse d'usage précède presque toujours le churn. Voici les signaux à surveiller :
Baisse du nombre d'utilisateurs actifs : le nombre absolu diminue, la part de licences utilisées recule et la tendance d'une semaine à l'autre est négative. Seuil d'alerte : baisse de plus de 25 % en 30 jours.
Baisse de la fréquence de connexion : les utilisateurs se connectent moins souvent. On passe du quotidien à l'hebdomadaire, ou de l'hebdomadaire au mensuel. Seuil d'alerte : réduction de 50 % de la fréquence de connexion des utilisateurs clés.
Baisse de l'usage des fonctionnalités : les fonctionnalités principales servent moins souvent. L'éventail de fonctionnalités se réduit à mesure que les utilisateurs abandonnent certaines fonctions. Seuil d'alerte : baisse de 30 % de l'usage des fonctionnalités principales sur 60 jours.
Réduction de la durée des sessions : les utilisateurs passent moins de temps dans votre produit, ce qui traduit généralement une valeur perçue en baisse ou plus de frictions. Seuil d'alerte : diminution durable de 40 % sur 45 jours.
Baisse des données créées ou stockées : moins de contenu créé signifie un investissement moindre dans votre plateforme. Seuil d'alerte : baisse de 35 % du rythme de création de données.
Dégradation de la relation
Les relations protègent les comptes dans les moments difficiles. Quand elles s'affaiblissent, les comptes deviennent vulnérables. Surveillez ces signaux :
Départ du sponsor exécutif : votre interlocuteur clé quitte l'entreprise, et son successeur ne connaît pas votre produit. C'est une alerte critique immédiate.
Désengagement du champion : votre défenseur interne cesse de s'impliquer et ne répond plus à vos sollicitations. Seuil d'alerte : aucun contact depuis 30 jours.
Changements chez les parties prenantes : réorganisations, changement de responsable budgétaire ou fermeture de départements. Alerte dès détection.
Annulations de réunions : les QBR sont annulées ou reportées, les points de suivi décalés à répétition. Seuil d'alerte : 2 annulations consécutives ou plus.
Baisse de réactivité : les réponses aux e-mails sont plus lentes, la présence aux réunions diminue. Seuil d'alerte : délai de réponse supérieur à 7 jours par rapport à leur référence historique.
Baisse du sentiment et de la satisfaction
Le sentiment prédit le comportement. Les clients mécontents partent, même quand l'usage semble encore sain.
Baisse du score NPS : le client passe de Promoteur (9-10) à Passif (7-8) ou à Détracteur (0-6), ou son score perd plusieurs points. Seuil d'alerte : le NPS perd 3 points ou plus, ou le client devient détracteur.
Baisse du CSAT : la satisfaction envers le support recule, les enquêtes post-interaction deviennent négatives. Seuil d'alerte : CSAT inférieur à 6/10 ou tendance à la baisse.
Retours négatifs : les commentaires d'enquête évoquent un changement de solution, de la frustration ou de la déception. Des mentions de concurrents apparaissent. Alerte dès qu'un concurrent est cité dans une évaluation.
Réseaux sociaux et sites d'avis : des avis négatifs sont publiés, des plaintes publiques apparaissent. Alerte dès qu'une mention publique est négative.
Évaluation du CSM : votre CSM signale le compte comme « à risque » d'après ses échanges. Parfois, c'est simplement une intuition que quelque chose cloche. Alerte quand le CSM le signale manuellement.
Schémas de problèmes et de support
Les problèmes créent de la friction. Les problèmes non résolus alimentent le churn. Une série de difficultés révèle un souci d'adéquation au besoin ou de qualité.
Pic du volume de tickets de support : hausse soudaine des tickets, supérieure à la référence historique du client. Seuil d'alerte : plus de 3 fois le volume habituel de tickets en 30 jours.
Problèmes critiques (tickets P1) : bugs de forte gravité ou pannes, fonctionnalité essentielle à l'activité en panne. Alerte dès l'ouverture d'un ticket P1.
Escalades : un ticket est remonté à l'ingénierie ou à la direction, le client demande l'intervention d'un dirigeant. Alerte pour toute escalade.
Problèmes non résolus : tickets ouverts depuis plus de 14 jours, plusieurs tickets rouverts. Seuil d'alerte : ticket ouvert depuis plus de 21 jours ou plus de 2 réouvertures.
Baisse de la satisfaction envers le support : CSAT post-ticket inférieur à 7, client qui exprime de la frustration dans le ticket. Seuil d'alerte : CSAT inférieur à 6 ou sentiment négatif.
Changements chez les parties prenantes
Les changements externes créent de l'instabilité. Les budgets, les priorités et les relations sont remis à plat. Un engagement proactif est indispensable pendant ces transitions.
Gel des budgets annoncé : le client annonce des coupes budgétaires, un gel des embauches ou des initiatives de réduction des coûts. Alerte immédiate, c'est un risque pour le renouvellement.
Licenciements ou restructuration : le client traverse des licenciements ou une réorganisation de département. Alerte de priorité élevée : les priorités bougent et les budgets sont menacés.
Activité de fusion-acquisition : le client a été racheté ou rachète une autre entreprise. Alerte de priorité élevée : de nouveaux décideurs arrivent et la consolidation de la stack technologique démarre.
Changements de direction : un nouveau CEO, CFO ou responsable de département annonce de nouvelles priorités. Alerte de priorité moyenne, vous devrez repartir de zéro sur la relation.
Virage stratégique : le client change de modèle économique ou d'orientation stratégique. Alerte de priorité moyenne : l'adéquation avec votre cas d'usage est menacée.
Activité concurrentielle
La pression concurrentielle est l'un des principaux moteurs de churn. Une détection précoce vous laisse le temps de vous différencier, de combler les écarts ou de prouver une valeur supérieure.
Concurrent mentionné : le client s'informe sur les fonctionnalités d'un concurrent ou évoque l'évaluation d'alternatives. Alerte immédiate, il compare activement les offres.
Demandes de fonctionnalités calquées sur l'offre d'un concurrent : demandes répétées pour des fonctionnalités que propose votre concurrent, et ces écarts deviennent des points de friction. Alerte de priorité moyenne, c'est une vulnérabilité concurrentielle.
Évolutions du secteur : lancement d'un nouveau concurrent ou annonce d'une fonctionnalité majeure chez l'un d'eux. Alerte pour passer en revue les comptes du segment concerné.
Dépendance réduite : le client réduit les données hébergées chez vous ou les migre ailleurs. Alerte de priorité élevée, il prépare son départ.
Demandes sur la durée du contrat : demandes de raccourcir la durée du contrat ou de passer à un abonnement mensuel. Alerte de priorité élevée, le client se garde toutes les options ouvertes.
Construire des systèmes d'alerte
Configuration des déclencheurs d'alerte
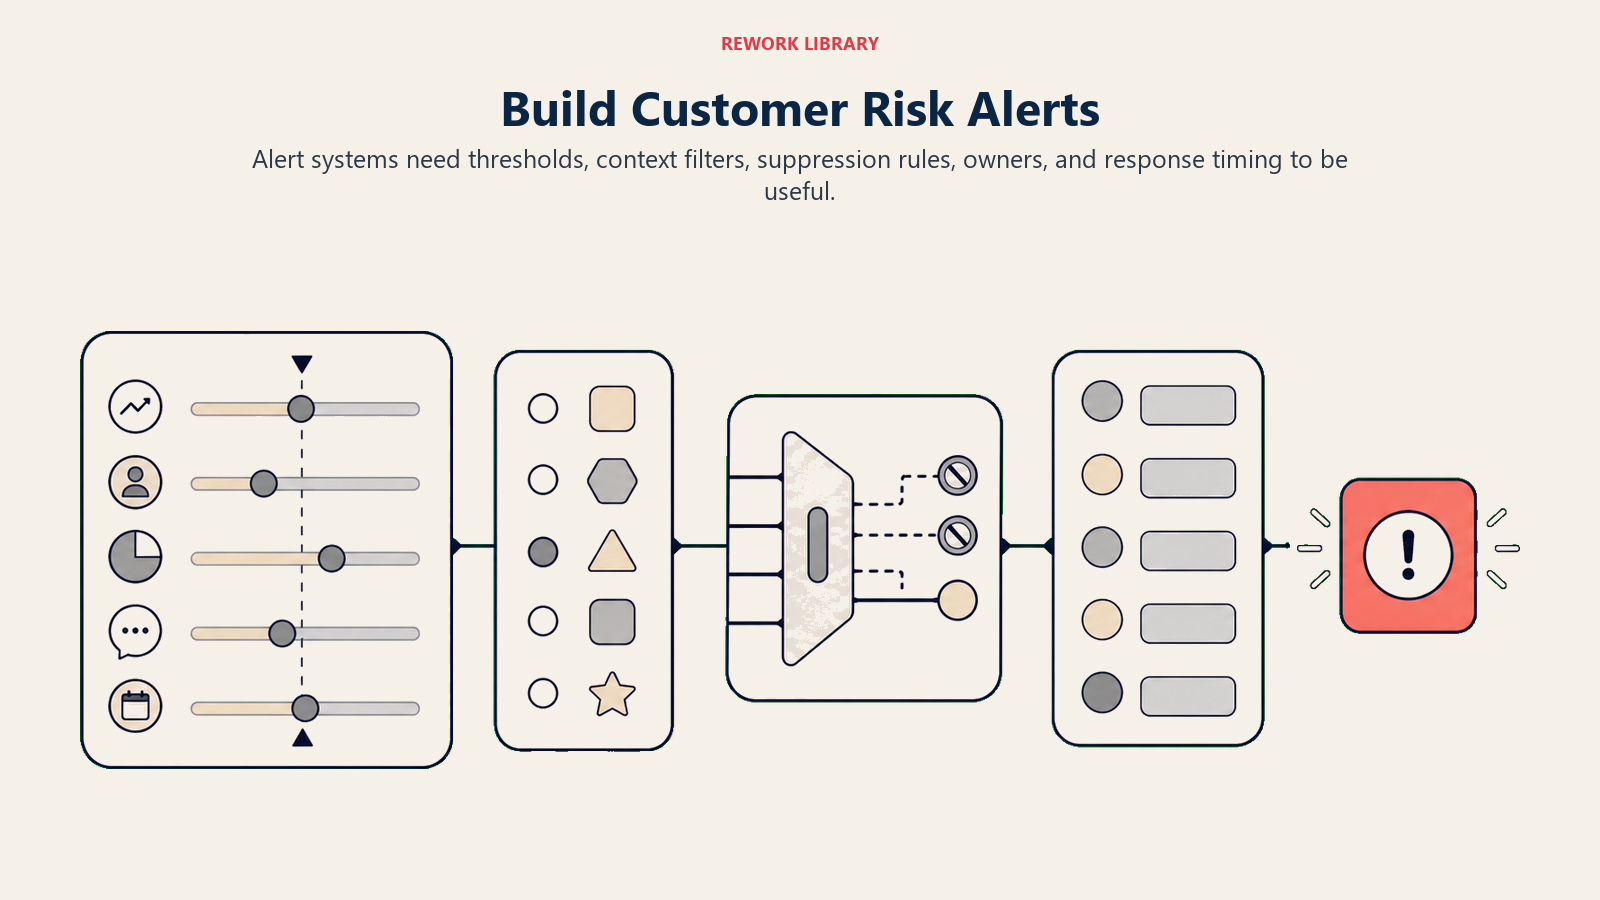
Définissez des conditions de déclenchement claires pour que votre système sache exactement quand émettre une alerte.
Exemple d'alerte : baisse d'usage
Déclenchement quand les utilisateurs actifs reculent de plus de 30 % par rapport à la référence sur 60 jours ET que la baisse dure depuis plus de 14 jours ET que le compte n'est pas dans une période saisonnière de faible usage.
Gravité : Élevée (P1) Assignée à : CSM du compte Escalade : Manager des CSM si l'alerte n'est pas traitée sous 48 heures
Exemple d'alerte : départ du sponsor exécutif
Déclenchement quand le contact sponsor exécutif est marqué « A quitté l'entreprise » dans le CRM OU quand son rôle de sponsor exécutif est supprimé.
Gravité : Critique (P0) Assignée à : CSM du compte + Manager des CSM + commercial Escalade : notification immédiate
Modèle de configuration d'alerte :
Nom de l'alerte : [Nom descriptif]
Description : [Ce que cette alerte détecte]
Condition de déclenchement : [Logique précise]
Sources de données : [D'où viennent les données]
Seuil : [Valeurs précises]
Gravité : [P0/P1/P2/P3]
Assignée à : [Rôle]
Escalade : [Qui + Quand]
Délai de réponse : [SLA]
Action recommandée : [Premières étapes]
Méthode de définition des seuils
Fixer des seuils d'alerte n'est pas une affaire d'intuition. Voici comment procéder :
Étape 1 : analyse historique
Analysez les clients perdus par le passé. Repérez les schémas de comportement communs. Déterminez à quel moment le signal est apparu.
Exemple : 85 % des clients perdus avaient connu une baisse d'usage supérieure à 30 %. 60 % d'entre eux, une baisse supérieure à 40 %. Fixez votre seuil à 30 % de baisse : vous détecterez 85 % des clients qui partent, avec quelques faux positifs.
Étape 2 : test sur les données historiques
Appliquez votre seuil aux 12 derniers mois de données. Calculez le taux de vrais positifs (clients perdus que vous avez détectés). Calculez le taux de faux positifs (clients sains que vous avez signalés).
Étape 3 : équilibrer sensibilité et spécificité
Une sensibilité élevée suppose des seuils plus bas, plus d'alertes et un taux de faux positifs plus élevé. Réservez-la aux comptes critiques, dont la perte aurait un fort impact.
Une spécificité élevée suppose des seuils plus hauts, moins d'alertes, et vous risquez de manquer certains risques. Réservez-la aux grands portefeuilles où la fatigue d'alerte pose problème.
Étape 4 : seuils propres à chaque segment
Les clients enterprise ont normalement des niveaux d'usage de référence plus bas. Fixez le seuil à 35 % de baisse.
Les clients SMB doivent avoir un usage plus élevé. Fixez le seuil à 25 % de baisse.
Étape 5 : itérer selon la précision
Suivez chaque mois les résultats des alertes. Ajustez les seuils si vous obtenez trop de faux positifs ou de faux négatifs. Affinez chaque trimestre.
Priorisation et routage des alertes
Chaque type d'alerte demande une logique de routage différente.
Les alertes P0 (critiques) vont au CSM du compte (e-mail immédiat + Slack), au Manager des CSM (notification immédiate) et au commercial (si le renouvellement approche). Livraison instantanée.
Les alertes P1 (élevées) vont au CSM du compte (e-mail + dashboard) et au Manager des CSM (résumé quotidien). Livraison sous 1 heure.
Les alertes P2 (moyennes) vont au CSM du compte (dashboard + résumé quotidien). Livraison dans l'e-mail de résumé quotidien.
Les alertes P3 (faibles) vont au CSM du compte (dashboard uniquement). Livraison dans le résumé hebdomadaire.
Règles de routage :
Selon la valeur du compte : les comptes de plus de 100 k$ d'ARR sont escaladés, une P2 devient P1. Les comptes de moins de 10 k$ d'ARR sont rétrogradés, une P1 devient P2. C'est de l'allocation de ressources.
Selon la proximité du renouvellement, relevez la gravité d'un niveau à moins de 60 jours de l'échéance, et vous pouvez la baisser à plus de 180 jours.
Selon le segment de clientèle : les alertes enterprise remontent au CSM et aux Sales. Les alertes SMB vont au CSM seul (sauf ARR élevé).
Canaux et moments de notification
Choisissez le canal de notification en fonction de la gravité de l'alerte.
Critique (P0) : message instantané Slack/Teams, e-mail immédiat, SMS (pour le départ du sponsor exécutif ou un échec de paiement) et badge sur le dashboard.
Élevée (P1) : e-mail sous 1 heure, badge sur le dashboard et e-mail de synthèse quotidien.
Moyenne (P2) : badge sur le dashboard et e-mail de résumé quotidien.
Faible (P3) : dashboard uniquement et e-mail de résumé hebdomadaire.
Stratégie de timing :
Les alertes en temps réel concernent les événements critiques comme un échec de paiement ou une demande de résiliation. Envoyez une notification immédiate dès que l'événement survient.
Les alertes groupées conviennent aux signaux de priorité moyenne. Un e-mail par jour à 9 h, heure locale, résume toutes les alertes P2.
Les synthèses hebdomadaires couvrent les signaux de faible priorité. Le résumé du lundi matin donne une vue d'ensemble du portefeuille.
Éviter la surcharge d'alertes :
N'envoyez pas la même alerte à répétition. Une fois déclenchée, mettez-la en sourdine pendant 7 jours, sauf si la situation s'aggrave.
Regroupez les alertes liées. Envoyez une seule notification par compte, pas une alerte distincte pour chaque indicateur.
Respectez les horaires de travail des CSM. Aucune alerte entre 20 h et 8 h, sauf si elle est critique.
Suppression et dédoublonnage des alertes
Règles de suppression :
La suppression temporaire fonctionne ainsi : l'alerte se déclenche, le CSM en accuse réception, le système la met en sourdine pendant 7 jours. Le CSM a ainsi le temps d'enquêter et d'agir. Une nouvelle alerte est émise si la situation s'aggrave.
Les arrêts planifiés demandent une suppression manuelle. Quand un client annonce une période d'usage réduit prévue (congés, migration, etc.), supprimez manuellement les alertes d'usage pour cette période.
Les schémas saisonniers doivent être supprimés automatiquement. En décembre, l'usage est généralement inférieur de 40 % pendant les fêtes. Supprimez automatiquement les alertes de baisse d'usage du 15 décembre au 5 janvier. Adaptez la règle à chaque segment : les clients du secteur éducatif ont eux aussi besoin d'une suppression pendant les vacances d'été.
Dédoublonnage :
Le problème : plusieurs alertes pour un même problème de fond créent du bruit.
Exemple : le compte XYZ voit son usage baisser. Des alertes se déclenchent pour la baisse des utilisateurs actifs, la fréquence de connexion réduite, la chute d'usage des fonctionnalités et la diminution de la durée des sessions. Le CSM reçoit 4 alertes pour le même problème.
La solution est la consolidation des alertes. Regroupez les alertes liées. Envoyez une seule notification : « Compte XYZ : baisse d'usage multi-indicateurs ». Le détail présente tous les indicateurs concernés. Le CSM voit le tableau complet, pas des signaux fragmentés.
Mise en œuvre : définissez des groupes d'alertes (groupe usage, groupe engagement, groupe support). Quand plusieurs alertes d'un même groupe se déclenchent en 24 heures, consolidez-les. Envoyez une seule notification avec tout le contexte.
Playbooks de réponse aux alertes
Protocoles de réponse par type d'alerte
Playbook : alerte de baisse d'usage
Déclencheur : les utilisateurs actifs ont reculé de plus de 30 % en 30 jours
Étapes de réponse :
Enquêter (sous 24 heures) :
- Vérifier le produit : problèmes ou changements
- Examiner les tickets de support récents
- Rechercher des changements chez les parties prenantes
- Identifier les utilisateurs devenus inactifs
Prendre contact (sous 48 heures) :
- E-mail ou appel au contact principal
- « Nous avons remarqué une baisse d'usage et voulions faire un point »
- Rester attentif aux signaux (problèmes, priorités modifiées, concurrent)
Diagnostiquer la cause profonde :
- Problèmes de produit ? (Escalade vers l'équipe produit)
- Lacunes d'onboarding ? (Campagne de nouvel onboarding)
- Changements chez les parties prenantes ? (Reconstruire les relations)
- Valeur non perçue ? (Revue du ROI, extension des cas d'usage)
Mettre en œuvre la solution :
- Adapter l'intervention à la cause profonde
- Fixer le calendrier de suivi
- Surveiller l'usage chaque semaine
Documenter et suivre :
- Consigner les constats dans le CRM
- Mettre à jour le plan de réussite
- Suivre le résultat de l'intervention
Playbook : départ du sponsor exécutif
Déclencheur : le sponsor exécutif a quitté l'entreprise
Étapes de réponse :
Évaluation immédiate (sous 4 heures) :
- Confirmer le départ
- Identifier le remplaçant (s'il y en a un)
- Évaluer le contrat et le calendrier de renouvellement
Coordination interne (sous 24 heures) :
- Alerter le Manager des CSM et le commercial
- Élaborer une stratégie de reconstruction de la relation
- Préparer un plan de transition du sponsor exécutif
Prise de contact avec le client (sous 48 heures) :
- Féliciter le sponsor sortant, demander à être présenté à son remplaçant
- Sans remplaçant, contacter la partie prenante de niveau immédiatement supérieur
- Demander une réunion pour « assurer la continuité de la réussite »
Remise à plat de la relation (sous 2 semaines) :
- Réunion avec le nouveau décideur
- Rétablir la proposition de valeur
- Comprendre les nouvelles priorités et les nouveaux objectifs
- Cartographier la nouvelle organisation
Engagement renforcé (90 jours suivants) :
- Points de contact hebdomadaires
- Executive Business Review
- Démontrer la valeur et le ROI
- Obtenir l'engagement du nouveau sponsor
Playbook : pic de tickets de support
Déclencheur : plus de 3 fois le volume normal de tickets en 30 jours
Étapes de réponse :
Analyser les tickets (sous 24 heures) :
- Quels types de problèmes ?
- Le même problème revient-il ? (systémique)
- Des problèmes différents ? (friction générale)
- Quels niveaux de gravité ?
Se coordonner avec le support (sous 48 heures) :
- S'assurer que les tickets sont priorisés
- Accélérer la résolution
- Déterminer s'il s'agit d'un bug produit ou d'un manque de formation
Contact proactif (sous 72 heures) :
- Le CSM appelle le client
- Reconnaître les problèmes
- Expliquer le plan de résolution
- Proposer un soutien supplémentaire
Résolution et suivi :
- S'assurer que tous les tickets sont résolus
- Vérifier la satisfaction après résolution
- Éviter la récidive (formation, changement de processus)
Réparation de la relation :
- Si la satisfaction a été touchée, investir dans la relation
- Excuses d'un dirigeant si nécessaire
- Démontrer l'engagement envers la réussite du client
Étapes d'investigation et de validation
Processus d'investigation standard :
Étape 1 : valider l'alerte
- S'agit-il d'un vrai signal ou d'un faux positif ?
- Vérifier la qualité des données (échec d'intégration, décalage de données ?)
- Confirmer que la situation persiste (pas un simple accroc passager)
Étape 2 : rassembler tout le contexte
- Examiner toutes les données du client (pas seulement l'indicateur de l'alerte)
- Vérifier le health score et les autres dimensions
- Relire les derniers points de contact et les notes
- Rechercher des facteurs externes (changements d'organisation, conditions de marché)
Étape 3 : identifier la cause profonde
- Pourquoi cela se produit-il ?
- Depuis quand ?
- Qu'est-ce qui a changé ?
- Est-ce un symptôme ou une cause ?
Étape 4 : évaluer la gravité et l'urgence
- Quelle est la gravité du risque ?
- De combien de temps dispose-t-on pour intervenir ?
- Le client évalue-t-il activement des alternatives ?
- Qu'est-ce qui est en jeu (ARR, compte stratégique) ?
Étape 5 : définir le plan d'action
- Quelle intervention est nécessaire ?
- Qui doit être impliqué ?
- Quel est le calendrier ?
- Quelles ressources sont requises ?
Documentation : Consignez les constats dans le CRM pour pouvoir les consulter plus tard et analyser les schémas.
Stratégies d'intervention
Adapter l'intervention à la cause profonde :
Cause profonde : problèmes produit ou techniques
- Intervention : résolution du problème, solutions de contournement, escalade vers l'ingénierie
- Délai : immédiat (priorité élevée)
- Parties impliquées : Support, Produit, Ingénierie
Cause profonde : manque de valeur ou de ROI
- Intervention : revue de la valeur, extension des cas d'usage, analyse du ROI, formation
- Délai : 2 à 4 semaines
- Parties impliquées : CSM, parfois les Sales
Cause profonde : lacunes d'onboarding ou d'adoption
- Intervention : nouvel onboarding, formation, partage de bonnes pratiques
- Délai : 2 à 4 semaines
- Parties impliquées : CSM, équipe Formation
Cause profonde : changements chez les parties prenantes
- Intervention : reconstruction de la relation, engagement des dirigeants, rétablissement de la valeur
- Délai : 4 à 8 semaines
- Parties impliquées : CSM, Sales, équipe de direction
Cause profonde : budget ou contexte économique
- Intervention : preuve du ROI, souplesse contractuelle, analyse coûts-bénéfices
- Délai : variable (lié au cycle budgétaire)
- Parties impliquées : CSM, Sales, Finance
Cause profonde : pression concurrentielle
- Intervention : différenciation, partage de la roadmap, engagement des dirigeants
- Délai : 2 à 6 semaines
- Parties impliquées : CSM, Sales, Produit
Cadre de choix de l'intervention :
- Diagnostiquer d'abord la cause profonde
- Choisir l'intervention qui traite la cause (pas seulement le symptôme)
- Impliquer les bonnes parties prenantes
- Fixer un calendrier et des critères de réussite clairs
- Surveiller et ajuster
Procédures d'escalade
Quand escalader :
Vers le Manager des CSM :
- Alerte non résolue dans le délai du SLA
- Client qui demande l'intervention d'un dirigeant
- Effort de sauvegarde exigeant des ressources au-delà de l'autorité du CSM
- Compte de forte valeur en risque critique
Vers l'équipe Sales :
- Renouvellement menacé (négociation du contrat nécessaire)
- Relation avec un dirigeant nécessaire
- Situation concurrentielle
- Opportunité d'expansion nécessitant l'intervention des Sales
Vers l'équipe Produit :
- Problème produit systémique
- Écart fonctionnel qui alimente le churn
- Plusieurs clients signalent le même problème
- Feedback décisif pour la roadmap
Vers l'équipe de direction :
- Compte stratégique en danger
- Risque de réputation (feedback public négatif)
- Valeur du contrat supérieure à X $ (seuil propre à chaque entreprise)
- Client qui demande l'implication de la direction générale
Processus d'escalade :
Étape 1 : préparer le contexte
- Documenter toute la situation
- Analyse de la cause profonde
- Actions déjà menées
- Recommandation sur le soutien attendu de l'escalade
Étape 2 : escalader par les bons canaux
- Utiliser les circuits d'escalade définis
- Fournir le contexte complet (ne pas obliger le dirigeant à chercher l'information)
- Être précis sur l'aide demandée
Étape 3 : coordonner la réponse
- Se mettre d'accord sur le message et l'approche
- Responsabilités claires (qui fait quoi)
- Calendrier de l'intervention escaladée
Étape 4 : exécuter et assurer le suivi
- Mettre en œuvre l'intervention escaladée
- Suivre l'avancement
- Tenir l'équipe d'escalade informée
- Boucler la boucle une fois le problème résolu
Exigences de documentation
Ce qu'il faut documenter :
Détails de l'alerte :
- Type d'alerte et déclencheur
- Date et heure du déclenchement
- Détails du compte
- Indicateurs et seuils
Constats de l'investigation :
- Cause profonde identifiée
- Contexte et facteurs contributifs
- Communication avec le client (le cas échéant)
- Évaluation de la gravité
Actions menées :
- Intervention retenue
- Personnes impliquées
- Calendrier
- Ressources utilisées
Résultat :
- Le problème est-il résolu ?
- Le client a-t-il réagi positivement ?
- Évolution du health score (le cas échéant)
- Churn évité ou non
Enseignements :
- Ce qui a fonctionné
- Ce qui n'a pas fonctionné
- Ferions-nous les choses autrement la prochaine fois ?
Où documenter :
- CRM (système de référence principal)
- Plateforme de customer success (si distincte)
- Suivi des escalades (si critique)
- Wiki d'équipe (améliorations des playbooks)
Pourquoi la documentation compte :
- Identification des schémas (problèmes récurrents)
- Amélioration des playbooks (apprendre ce qui marche)
- Partage des connaissances (l'équipe apprend de chacun)
- Responsabilisation (suivre les délais de réponse et les résultats)
- Contexte historique (les futurs CSM comprennent l'historique du compte)
Gérer la fatigue d'alerte
Équilibrer sensibilité et bruit
Le problème de la fatigue d'alerte est bien réel.
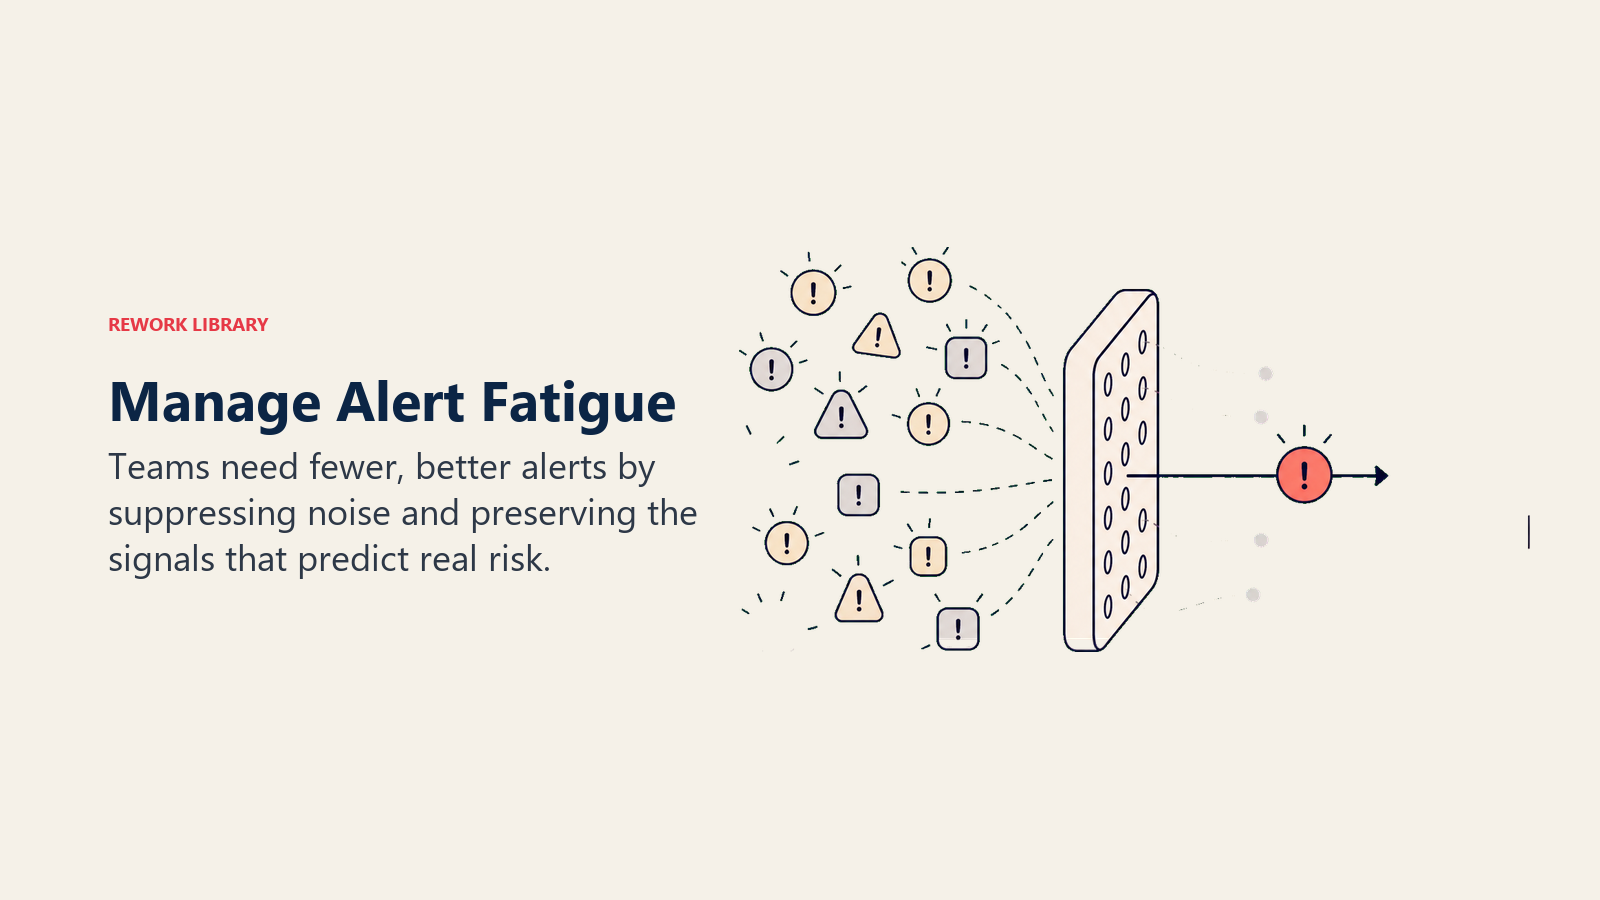
Trop sensible, et le moindre petit changement déclenche une alerte. Les CSM reçoivent plus de 50 alertes par jour. Ils finissent par les ignorer, car le bruit couvre le signal. Les alertes critiques passent à la trappe.
Trop prudent, et seules les situations extrêmes déclenchent une alerte. Vous manquez les signaux précoces. L'intervention arrive trop tard. Le churn augmente.
Pour trouver l'équilibre, visez ces indicateurs cibles : 3 à 8 alertes par CSM et par semaine (volume gérable). 70 à 80 % de vrais positifs (la plupart des alertes sont justifiées). Plus de 85 % de taux de réponse (les CSM agissent réellement sur les alertes). Plus de 60 % de taux de sauvegarde (les interventions fonctionnent).
Voici le processus de calibrage :
Mois 1, mesurez votre point de départ. Combien d'alertes se sont déclenchées ? Combien ont donné lieu à une action ? Combien ont prédit un vrai churn ?
Mois 2, analysez la précision. Quelles alertes avaient un taux de vrais positifs élevé ? Gardez-les sensibles. Lesquelles étaient surtout de faux positifs ? Réduisez leur sensibilité.
Mois 3, ajustez les seuils. Relevez les seuils des alertes bruyantes. Maintenez ou abaissez ceux des alertes précises.
Mois 4, validez les améliorations. Le volume d'alertes a-t-il diminué ? Le taux de vrais positifs a-t-il augmenté ? Les CSM réagissent-ils davantage ?
Poursuivez ensuite par des revues trimestrielles pour affiner les seuils en fonction des résultats.
Affinement et réglage des alertes
Vous disposez de cinq stratégies d'affinement :
Stratégie 1 : relever le seuil minimum. L'approche actuelle déclenche l'alerte si l'usage baisse de plus de 20 %. L'approche affinée la déclenche si l'usage baisse de plus de 30 %. Résultat : moins d'alertes, plus de précision.
Stratégie 2 : exiger une durée minimale. L'approche actuelle déclenche l'alerte dès qu'un seuil est franchi. L'approche affinée ne la déclenche que si la situation dure plus de 14 jours. Résultat : filtre les accrocs passagers, réduit le bruit.
Stratégie 3 : ajouter des règles contextuelles. L'approche actuelle déclenche une alerte sur tout usage faible, sans distinction. L'approche affinée tient compte des références propres à chaque segment : les clients enterprise et SMB ne se comportent pas de la même façon. Résultat : des seuils adaptés à chaque segment.
Stratégie 4 : combiner plusieurs signaux. L'approche actuelle déclenche l'alerte à la baisse d'un seul indicateur. L'approche affinée ne la déclenche que si au moins 2 indicateurs reculent. Résultat : un signal plus fort, moins de faux positifs.
Stratégie 5 : détection d'anomalies par machine learning. L'approche actuelle repose sur des seuils statiques. L'approche affinée utilise des modèles de ML qui apprennent les comportements normaux et alertent en cas d'écart. Résultat : une adaptation aux références propres à chaque client.
Processus de réglage :
Chaque semaine : examinez le volume d'alertes et recueillez l'avis des CSM sur leur utilité.
Chaque mois : calculez le taux de vrais positifs par type d'alerte et identifiez les 3 alertes les plus bruyantes.
Chaque trimestre : appliquez les ajustements de seuils, validez les améliorations et documentez les changements.
Consolider les alertes liées
La fragmentation des alertes est un vrai problème.
Voici ce qui se passe : le compte XYZ voit sa santé se dégrader. Le système déclenche 5 alertes distinctes : utilisateurs actifs en baisse de 30 %, fréquence de connexion réduite, usage des fonctionnalités en recul, durée des sessions en baisse et health score tombé à 55. Le CSM reçoit 5 alertes pour un même problème de fond.
La solution passe par des alertes consolidées.
Au lieu de 5 alertes, envoyez-en une seule : « Compte XYZ : dégradation de la santé multi-indicateurs ». Le résumé indique que le health score est passé de 72 à 55 en 30 jours. Le détail montre les utilisateurs actifs à -32 % (45 → 31), la fréquence de connexion à -40 % (quotidienne → 3 fois par semaine), l'usage des fonctionnalités à -25 % (6 fonctionnalités → 4,5 en moyenne) et la durée des sessions à -35 %. Action recommandée : enquêter sur la cause profonde de la baisse d'usage.
Avantages : une notification au lieu de cinq. Une vue complète du problème. Moins de fatigue d'alerte. Le CSM voit le schéma d'ensemble, pas des indicateurs isolés.
Pour la mise en œuvre :
Définissez des groupes d'alertes. Le groupe Usage comprend les utilisateurs actifs, les connexions, les fonctionnalités et la durée des sessions. Le groupe Engagement comprend les points de contact, les QBR, la formation et les e-mails. Le groupe Support comprend les tickets, les escalades et le CSAT. Le groupe Relation comprend les changements chez les parties prenantes et la réactivité.
Logique de consolidation : si plusieurs alertes du même groupe se déclenchent en 24 heures, fusionnez-les en une seule alerte consolidée. Affichez tous les indicateurs concernés dans la vue détaillée.
Le machine learning pour réduire le bruit
Applications du ML :
Détection d'anomalies :
- Le ML apprend les comportements normaux de chaque compte
- Il n'alerte que lorsque le comportement s'écarte nettement de la référence apprise
- Il s'adapte aux schémas propres à chaque compte
Exemple :
- Le compte A compte normalement 50 utilisateurs actifs
- Le compte B compte normalement 500 utilisateurs actifs
- Les deux tombent à 40 utilisateurs
- Approche traditionnelle : les deux déclenchent une alerte « usage faible »
- ML : le compte A est normal (-20 %, dans la variance de référence), aucune alerte
- Le compte B est anormal (-92 %), l'alerte se déclenche
Alertes prédictives :
- Le ML prédit la probabilité de churn à partir de la trajectoire actuelle
- Il n'alerte que lorsque la probabilité de churn dépasse un seuil
Exemple :
- Compte avec une légère baisse d'usage
- Approche traditionnelle : alerte ou non, selon le seuil
- ML : analyse le schéma, prédit 15 % de probabilité de churn (risque faible), aucune alerte
- Compte avec une baisse similaire mais un schéma différent
- ML : prédit 75 % de probabilité de churn (risque élevé), l'alerte se déclenche
Priorisation des alertes :
- Le ML note chaque alerte selon la probabilité qu'elle traduise un vrai risque
- Les CSM voient d'abord les alertes à forte confiance
Avantages :
- Moins de faux positifs (le ML apprend ce qui est normal ou préoccupant)
- Adaptation à l'évolution des schémas
- Prédiction du risque plus précise
Prérequis :
- Données historiques (12 mois ou plus)
- Ressources en data science
- Infrastructure de ML
- Entraînement continu des modèles
Idéal pour : les grandes entreprises SaaS dotées d'équipes data et de systèmes d'alerte matures.
Tenir compte de la capacité de l'équipe
Dimensionner le volume d'alertes selon la capacité de l'équipe :
Calculer la capacité :
- Un CSM moyen gère 50 comptes
- Il peut traiter 5 à 8 alertes significatives par semaine
- Chaque investigation ou réponse prend 1 à 2 heures
Calcul à l'échelle du portefeuille :
- 500 clients répartis entre 10 CSM
- Objectif : 50 à 80 alertes par semaine au total (5 à 8 par CSM)
- Taux d'alerte : 10 à 16 % des comptes par semaine
Si le volume d'alertes dépasse la capacité :
Option 1 : réduire la sensibilité des alertes
- Relever les seuils
- Réduire le nombre de types d'alertes
- Se concentrer sur les signaux à plus fort impact
Option 2 : augmenter la capacité de l'équipe
- Recruter davantage de CSM
- Automatiser les réponses courantes
- Utiliser l'IA pour assister l'investigation
Option 3 : trier et prioriser
- Les CSM se concentrent sur les seules alertes P0/P1
- Les P2/P3 sont traitées par des programmes à grande échelle
- Accepter que certains signaux ne reçoivent pas d'attention immédiate
Option 4 : améliorer l'efficacité
- De meilleurs playbooks (réponse plus rapide)
- Pré-investigation (l'automatisation rassemble le contexte)
- Messages types de prise de contact (gain de temps pour le CSM)
Surveiller :
- Taux de réponse des CSM aux alertes (doit dépasser 80 %)
- Si le taux de réponse chute, le volume d'alertes est probablement trop élevé
- Ajuster les seuils ou renforcer la capacité
Intégration inter-fonctionnelle
Coordination avec l'équipe Sales
Quand impliquer les Sales :
Renouvellement menacé :
- Contrat à moins de 90 jours
- Health score < 60
- Alerter les Sales pour un appui à la négociation commerciale
Relation avec un dirigeant nécessaire :
- Client qui demande un engagement au niveau de la direction
- Compte de forte valeur en danger
- Les Sales entretiennent de meilleures relations avec les dirigeants
Opportunité d'expansion :
- Health score > 80
- Les signaux d'usage indiquent que le compte est prêt pour l'expansion
- Les Sales mènent la conversation commerciale d'expansion
Situation concurrentielle :
- Client qui évalue des alternatives
- Les Sales peuvent défendre la différenciation
- Peut exiger de la souplesse sur les prix et les contrats
Mécanismes de coordination :
Alertes partagées :
- Les alertes critiques sont copiées au commercial
- Les alertes de risque de renouvellement (à 60 jours) sont copiées aux Sales
Revues de comptes hebdomadaires :
- CS et Sales examinent ensemble les comptes à risque
- Se mettre d'accord sur l'approche et sur qui pilote
- Coordonner les prises de contact (éviter les doublons)
Intégration CRM :
- Health scores visibles dans le CRM
- Les alertes créent des tâches pour le commercial
- Notes et historique du compte partagés
Responsabilités claires :
- Le CS pilote : la relation, l'adoption, la santé du compte
- Les Sales pilotent : la négociation du contrat, les conditions commerciales, les relations avec les dirigeants
- En collaboration : comptes à risque, renouvellements, expansion
Boucles de feedback avec l'équipe Produit
Quand escalader au Produit :
Problèmes produit systémiques :
- Plusieurs clients signalent le même problème
- Problème qui alimente le churn
- Écart fonctionnel face à la concurrence
Demandes de fonctionnalités :
- Demandes répétées pour la même fonctionnalité
- Deals perdus faute d'une fonctionnalité
- Expansion bloquée par un écart fonctionnel
Problèmes d'utilisabilité :
- Clients en difficulté sur certains workflows
- Faible adoption de fonctionnalités clés
- Tickets de support qui révèlent de la confusion
Veille concurrentielle :
- Clients qui comparent avec les fonctionnalités d'un concurrent
- Tendances du marché qui exigent une évolution du produit
Mécanismes de feedback :
Point hebdomadaire Produit/CS :
- Le CS partage les principaux problèmes clients
- Le Produit partage les mises à jour de la roadmap
- Alignement sur les priorités
Suivi du feedback :
- Consigner les demandes de fonctionnalités dans l'outil produit (Productboard, Aha, etc.)
- Les étiqueter avec l'ARR du client et le risque de churn
- Prioriser les fonctionnalités qui évitent le churn
Programmes bêta :
- Associer les clients à risque à la bêta (si la fonctionnalité répond à leur besoin)
- Montrer l'engagement à combler les écarts
- Susciter l'adhésion
Communication sur la roadmap :
- Le Produit partage la roadmap avec le CS
- Le CS communique les échéances aux clients à risque
- « La fonctionnalité dont vous avez besoin arrive au T3 » peut sauver un compte
Collaboration avec l'équipe Support
Intégration CS-Support :
Le Support alerte le CS :
- Les tickets P1 créent automatiquement une alerte CS
- Les escalades notifient le CSM
- Les faibles scores CSAT déclenchent une prise de contact du CS
Le CS apporte le contexte :
- Comptes de forte valeur signalés pour un support prioritaire
- Comptes à risque marqués pour un traitement sur mesure
- Le contexte de la situation du client aide le support
Suivi après un incident :
- Le CS fait un suivi après la résolution du ticket
- S'assure de la satisfaction
- Répare la relation si nécessaire
Identification des schémas :
- Le Support repère les problèmes récurrents
- Le CS escalade au Produit s'ils sont systémiques
- Communication proactive aux autres clients si le problème est répandu
Outils de coordination :
- Visibilité partagée sur le système de tickets
- Indicateurs de santé du support dans le dashboard CS
- Stand-up hebdomadaire CS-Support
Circuits d'escalade vers la direction
Quand escalader à la direction :
Compte stratégique en danger :
- Client de premier plan (par ARR ou valeur stratégique)
- Un churn représenterait une perte importante de revenus ou de réputation
- Nécessite l'engagement de la direction générale
Risque de réputation :
- Client qui menace de publier un avis négatif
- Escalade sur les réseaux sociaux
- Influence dans le secteur (impact possible sur d'autres clients)
Litiges contractuels :
- Questions juridiques ou commerciales
- Nécessite un pouvoir de décision au niveau de la direction
Remise à plat de la relation :
- Client qui demande l'implication du CEO ou d'un dirigeant
- Escalades précédentes sans succès
- Relation de dirigeant à dirigeant nécessaire
Processus d'escalade :
Étape 1 : préparer le dossier pour la direction
- Contexte du client (taille, importance stratégique, historique)
- Situation actuelle (ce qui s'est passé, cause profonde)
- Actions menées (ce qui a été tenté, résultats)
- Demande (qu'attendons-nous de la direction ?)
- Calendrier (urgence)
Étape 2 : escalader via le Manager
- Le Manager des CSM relit le dossier
- Valide que l'escalade est justifiée
- Ajoute contexte et recommandation
- Escalade vers l'équipe de direction
Étape 3 : engagement de la direction
- Le dirigeant contacte le client (appel, e-mail, réunion)
- Écoute, fait preuve d'empathie, s'engage sur une résolution
- Coordonne les ressources internes
- Tient ses engagements
Étape 4 : le CSM exécute
- Le CSM met en œuvre le plan de résolution
- Le dirigeant fait des points réguliers
- Le CSM informe le dirigeant une fois le sujet résolu
Bonnes pratiques :
- Escalader tôt s'il s'agit d'un compte stratégique (n'attendez pas que tout soit perdu)
- Bien préparer le dirigeant (ne le laissez pas chercher le contexte)
- Formuler une demande claire (que doit faire précisément le dirigeant ?)
- Aller au bout (l'implication d'un dirigeant crée de la responsabilisation)
Mesurer l'efficacité du système
Précision des alertes (vrais et faux positifs)
Indicateurs clés :
Taux de vrais positifs (rappel) : Parmi les clients perdus, quelle part avions-nous signalée par une alerte ?
- Formule : alertes ayant abouti à un churn / total des clients perdus
- Objectif : > 75 % (détecter la majorité des churns)
Exemple :
- 20 clients perdus ce trimestre
- 16 avaient été signalés par le système d'alerte précoce
- Taux de vrais positifs : 16/20 = 80 % ✓
Taux de faux positifs : Parmi les clients signalés, quelle part a finalement renouvelé ?
- Formule : alertes suivies d'un renouvellement / total des alertes
- Objectif : < 40 % (quelques faux positifs sont acceptables, mais pas trop)
Exemple :
- 50 alertes déclenchées ce trimestre
- 30 clients ont renouvelé, 20 sont partis
- Taux de faux positifs : 30/50 = 60 % (trop élevé, réduire la sensibilité)
Précision : Parmi les clients signalés, quelle part est réellement partie ?
- Formule : alertes ayant abouti à un churn / total des alertes
- Objectif : > 60 %
Exemple :
- 50 alertes déclenchées
- 20 churns
- Précision : 20/50 = 40 % (faible, trop de faux positifs)
Score F1 : Équilibre entre précision et rappel
- Formule : 2 × (Précision × Rappel) / (Précision + Rappel)
- Objectif : > 0,65
Suivez chaque mois, affinez chaque trimestre selon les résultats.
Délai de réponse
Mesurer la rapidité de traitement des alertes :
SLA de réponse par gravité :
- P0 (critique) : < 4 heures
- P1 (élevée) : < 24 heures
- P2 (moyenne) : < 72 heures
- P3 (faible) : < 1 semaine
Performance réelle :
Exemples d'indicateurs :
- Délai de réponse moyen P0 : 2,3 heures ✓
- Délai de réponse moyen P1 : 18 heures ✓
- Délai de réponse moyen P2 : 96 heures ✗ (dépasse le SLA)
- Délai de réponse moyen P3 : 5 jours ✓
Action : chercher pourquoi les alertes P2 dépassent le SLA. Causes possibles :
- Trop d'alertes P2 (réduire la sensibilité)
- Problèmes de capacité des CSM (ajouter des ressources ou automatiser)
- Playbooks peu clairs (améliorer les consignes de réponse)
Suivre :
- Répartition des délais de réponse (médiane, 90e percentile)
- Part des alertes respectant le SLA
- Tendance des délais de réponse (amélioration ou dégradation)
Impact : Une réponse plus rapide va de pair avec de meilleurs taux de sauvegarde. Chaque jour de retard réduit l'efficacité de l'intervention.
Taux de réussite des interventions
Mesurer les résultats des interventions déclenchées par les alertes :
Taux de réussite par type d'alerte :
Exemple :
| Type d'alerte | Interventions | Sauvés | Perdus | Taux de sauvegarde |
|---|---|---|---|---|
| Baisse d'usage | 45 | 32 | 13 | 71 % |
| Départ d'un dirigeant | 12 | 7 | 5 | 58 % |
| Pic de support | 23 | 19 | 4 | 83 % |
| Faible engagement | 34 | 22 | 12 | 65 % |
| Total | 114 | 80 | 34 | 70 % |
Enseignements :
- Les alertes de pic de support ont le taux de sauvegarde le plus élevé (la résolution des problèmes fonctionne)
- Les alertes de départ d'un dirigeant ont le plus faible (reconstruire la relation est difficile)
- Un taux de sauvegarde global de 70 % est solide (contre environ 20 % en mode réactif)
Suivre :
- Taux de sauvegarde par type d'alerte
- Taux de sauvegarde par stratégie d'intervention
- Taux de sauvegarde par CSM (piste de coaching)
- Taux de sauvegarde par segment de clientèle
Utiliser pour :
- Valider la valeur des alertes (permettent-elles de sauver des comptes ?)
- Affiner les playbooks (quelles interventions fonctionnent le mieux ?)
- Prioriser les types d'alertes (se concentrer sur ceux qui ont le plus d'impact)
- Justifier l'investissement dans le système d'alerte précoce (ROI)
Suivi des clients sauvés
Quantifier la valeur du système d'alerte précoce :
Définition d'un client sauvé : Client signalé par une alerte, intervention mise en œuvre, client ayant renouvelé (et qui serait probablement parti sans intervention).
Suivi :
Rapport mensuel des clients sauvés :
- Nombre de clients sauvés
- ARR sauvé
- Types d'alertes ayant déclenché l'intervention
- Stratégies d'intervention utilisées
Exemple :
Résultats d'octobre :
- Clients sauvés : 8
- ARR sauvé : 340 k$
- Répartition des alertes :
- Baisse d'usage : 5 sauvegardes (220 k$)
- Départ d'un dirigeant : 1 sauvegarde (80 k$)
- Pic de support : 2 sauvegardes (40 k$)
Répartition des interventions :
- Nouvel onboarding : 3 sauvegardes
- Engagement des dirigeants : 2 sauvegardes
- Résolution de problèmes : 2 sauvegardes
- Revue de la valeur : 1 sauvegarde
Depuis le début de l'année :
- Clients sauvés : 67
- ARR sauvé : 3,2 M$
- ROI du système d'alerte précoce : 15x (coût du système 200 k$, 3,2 M$ sauvés)
Attribution :
- Prudence : ne compter que les sauvegardes où l'alerte a directement mené à une intervention
- Documenter le moment de l'intervention (avant ou après l'alerte)
- Le CSM confirme que le client serait parti sans intervention
Utiliser pour :
- Démontrer la valeur du système d'alerte précoce
- Justifier l'investissement et les ressources
- Célébrer les réussites de l'équipe
- Affiner les stratégies d'alerte et d'intervention
Indicateurs d'amélioration du système
Suivre la maturité du système d'alerte précoce :
Couverture des alertes :
- Part des clients perdus qui avaient donné lieu à des alertes (objectif : > 80 %)
- Tendance : doit augmenter à mesure que le système s'améliore
Délai d'anticipation :
- Nombre moyen de jours entre l'alerte et le churn (objectif : > 60 jours)
- Tendance : doit augmenter (détection plus précoce)
Taux de réponse :
- Part des alertes sur lesquelles les CSM agissent (objectif : > 85 %)
- Tendance : doit rester élevé et stable
Exhaustivité des playbooks :
- Part des types d'alertes dotés d'un playbook de réponse défini (objectif : 100 %)
- Tendance : doit atteindre 100 % et s'y maintenir
Confiance des CSM :
- Interroger les CSM sur leur confiance dans le système d'alerte (échelle de 1 à 10)
- Objectif : > 8/10
- Tendance : doit augmenter à mesure que la précision progresse
Exhaustivité des intégrations :
- Part des sources de données intégrées (produit, CRM, support, enquêtes)
- Objectif : 100 % des sources critiques
- Tendance : augmente à mesure que de nouvelles sources sont ajoutées
Suivi trimestriel : Rendez compte à la direction du CS de la santé du système et des améliorations.
Techniques d'alerte avancées
Analyse prédictive et ML
Des alertes réactives aux modèles prédictifs :
Alertes réactives :
- « L'usage a baissé de 30 % »
- Dit ce qui s'est produit
- Il reste du temps pour intervenir, mais la baisse est déjà en cours
Alertes prédictives :
- « Le schéma d'usage indique 75 % de probabilité de churn dans 90 jours »
- Dit ce qui va se produire
- Intervenir avant même que la baisse ne commence
Exemple de modèle prédictif :
Données d'entrée :
- Indicateurs actuels d'usage, d'engagement et de sentiment
- Tendances d'usage (trajectoire)
- Schémas historiques issus des clients perdus
- Attributs du client (segment, ancienneté, ARR)
Sortie du modèle :
- Probabilité de churn (0 à 100 %)
- Délai prévu avant le churn
- Principaux facteurs de risque identifiés
Déclenchement de l'alerte :
- Si la probabilité de churn > 70 % → alerte P1
- Si la probabilité de churn > 85 % → alerte P0
Avantages :
- Alerte plus précoce (prédire avant que les indicateurs ne baissent)
- Plus de précision (apprend des schémas complexes)
- Facteurs de risque précis (dit pourquoi)
Prérequis :
- Plus de 1 000 clients
- 18 à 24 mois de données historiques
- Ressources en data science
- Infrastructure de ML
Idéal pour : les grandes entreprises SaaS aux opérations data matures.
Reconnaissance de schémas
Identifier les schémas de churn à partir des données historiques :
Exemple de schéma : la spirale du désengagement
Schéma :
- Le sponsor exécutif manque une QBR (baisse d'engagement)
- Deux semaines plus tard : l'usage baisse de 15 % (impact sur l'adoption)
- Quatre semaines plus tard : les tickets de support augmentent (friction)
- Huit semaines plus tard : usage en baisse de 40 %, le client part
Enseignement : L'absence à la QBR est le signal le plus précoce. Si nous voyons ce schéma s'amorcer, intervenons dès l'étape 1.
Alerte fondée sur un schéma :
- Déclencheur : le sponsor exécutif manque une QBR
- Données historiques : 60 % des comptes correspondant à ce schéma sont partis
- Action : prise de contact immédiate du CSM, reprogrammer la QBR, évaluer la santé de la relation
Schémas de churn courants :
Le départ silencieux :
- Baisse progressive de l'usage sur plus de 6 mois
- Ni plainte ni ticket de support
- Désengagement discret
- Signal précoce : la fréquence de connexion diminue
L'activiste frustré :
- Pic de tickets de support
- Feedback négatif
- Critiques ouvertes sur les problèmes
- Signal précoce : le premier ticket escaladé
La coupe budgétaire :
- Signal économique (licenciements, gel des budgets)
- Usage stable, mais renouvellement menacé
- Signal précoce : communication des parties prenantes sur le budget
Le changement de concurrent :
- Demandes de fonctionnalités calquées sur l'offre d'un concurrent
- Questions sur la migration
- Signal précoce : mentions de concurrents
Utilisez la reconnaissance de schémas pour :
- Repérer tôt les schémas à haut risque
- Créer des playbooks adaptés à chaque schéma
- Prédire la trajectoire probable du churn
- Intervenir au moment optimal du schéma
Comparaison de cohortes
Comparer un compte à des comptes similaires :
Exemple d'analyse de cohorte :
Compte XYZ :
- Secteur : santé
- Taille : 200 employés
- ARR : 50 k$
- Ancienneté : 8 mois
- Usage : 60 % d'utilisateurs actifs
Ce compte est-il en bonne santé ?
Comparaison avec la cohorte (santé, 100 à 300 employés, 40 à 60 k$ d'ARR, 6 à 12 mois d'ancienneté) :
- Utilisateurs actifs en moyenne : 72 %
- Comptes en bonne santé (renouvelés) : 78 % d'actifs
- Comptes perdus : 55 % d'actifs
Enseignement : Avec 60 %, le compte XYZ est sous la moyenne de la cohorte et plus proche du profil de churn que du profil sain.
Alerte : le compte XYZ est en dessous de sa cohorte, il est à risque.
Avantages :
- Évaluation mise en contexte (est-ce bon ou mauvais pour ce type de client ?)
- Références propres à chaque segment
- Identification des cas atypiques
Mise en œuvre :
- Définir les cohortes (secteur, taille, produit, ancienneté)
- Calculer les références de chaque cohorte
- Alerter quand un compte se situe nettement sous la moyenne de sa cohorte
Cas d'usage :
- Étalonner les health scores
- Fixer des seuils propres à chaque segment
- Distinguer les meilleurs comptes de ceux à risque
- Reporting côté client (« Vous êtes dans les 25 % les plus performants parmi des entreprises similaires »)
Détection d'anomalies
Détecter les comportements inhabituels :
Seuils traditionnels :
- Alerte si les utilisateurs actifs < 50
- Fonctionne pour certains comptes, pas pour d'autres
Détection d'anomalies :
- Apprendre le comportement normal de chaque compte
- Alerter quand le comportement s'écarte nettement de la référence de ce compte
- S'adapte aux schémas propres à chaque compte
Exemple :
Compte A :
- Normal : 200 à 220 utilisateurs actifs
- Ce mois-ci : 180 utilisateurs actifs
- Variation : -20 utilisateurs (dans la variance normale)
- Détection d'anomalies : pas d'alerte (toujours dans la plage attendue)
Compte B :
- Normal : 50 à 55 utilisateurs actifs
- Ce mois-ci : 35 utilisateurs actifs
- Variation : -20 utilisateurs (écart significatif)
- Détection d'anomalies : alerte (anormal pour ce compte)
Les deux comptes ont perdu 20 utilisateurs, mais seule la baisse du compte B est anormale.
Types d'anomalies :
Chute soudaine :
- Un indicateur chute brutalement par rapport à la référence
- Exemple : l'usage baisse de 50 % en une semaine
Inversion de tendance :
- Un indicateur en croissance se met à baisser
- Exemple : des utilisateurs ajoutés chaque mois, puis des pertes soudaines
Rupture de schéma :
- Le comportement ne correspond pas au schéma historique
- Exemple : activité habituelle du lundi au vendredi, puis plus aucune activité le week-end
Avantages :
- Références propres à chaque compte (pas de seuil unique pour tous)
- Détecte des changements qui ne franchissent aucun seuil absolu
- Réduit les faux positifs (comprend ce qui est normal pour chaque compte)
Mise en œuvre :
- Modèles de détection d'anomalies par machine learning
- Nécessite des données historiques par compte
- Outils : AWS SageMaker, Azure ML ou modèles de ML sur mesure
Corrélation multi-signaux
Combiner plusieurs signaux pour une prédiction plus solide :
Signal unique :
- L'usage a baissé de 25 %
- Seul, il peut indiquer ou non un risque sérieux
Plusieurs signaux corrélés :
- L'usage a baissé de 25 % ET
- L'engagement recule (aucun contact depuis 60 jours) ET
- Le sentiment se dégrade (le NPS est passé de 8 à 5)
Signaux combinés = indicateur de risque bien plus fort
Analyse de corrélation :
Combinaisons à haut risque :
- Usage faible + engagement faible + sentiment faible = 85 % de probabilité de churn
- Usage faible seul = 40 % de probabilité de churn
- N'alerter que sur les combinaisons à haut risque (réduit les faux positifs)
Schéma : la triple menace
- Usage, engagement et sentiment en baisse simultanée
- Données historiques : 80 % des comptes présentant ce schéma sont partis
- Action : alerte P0, intervention immédiate
Schéma : la situation rattrapable
- Usage en baisse mais engagement et sentiment élevés
- Données historiques : 70 % sauvés grâce à un nouvel onboarding
- Action : alerte P2, playbook de nouvel onboarding
Mise en œuvre :
- Analyser quelles combinaisons de signaux prédisent le churn
- Créer des règles d'alerte pour les combinaisons à forte probabilité
- Pondérer davantage les signaux combinés que les signaux isolés
Avantages :
- Plus de précision (multi-signaux = prédiction plus solide)
- Moins de faux positifs (une anomalie isolée n'est pas forcément un risque)
- Meilleur ciblage des interventions (on sait de quel type de problème il s'agit)
L'essentiel à retenir
Plus vous repérez le risque tôt, plus il est facile de sauver le client. Un système d'alerte précoce fait la différence entre la gestion de crise permanente et un customer success proactif.
Les équipes dotées d'un système d'alerte précoce efficace obtiennent des taux de sauvegarde de 60 à 80 %, contre 15 à 25 % en mode réactif. Elles détectent le risque 4 à 6 semaines plus tôt que si elles attendaient un préavis de résiliation. Elles réduisent le churn de 30 à 40 %, parce que l'intervention proactive fonctionne. La productivité des CSM progresse : ils se concentrent sur les vrais risques, pas sur les fausses alertes. Et la rétention devient prévisible, car elles savent prévoir avec précision quels comptes sont à risque.
Les équipes sans système d'alerte précoce subissent des départs surprises. « Nous ne l'avions pas vu venir » devient une phrase récurrente. Les taux de sauvegarde restent bas, car il est trop tard pour intervenir efficacement. Elles gaspillent leur énergie à enquêter sur des comptes qui ne sont pas réellement à risque. C'est le mode crise en permanence. Elles éteignent des incendies en continu. La rétention est imprévisible, faute de pouvoir prévoir avec précision.
Un système d'alerte précoce complet repose sur cinq éléments : des alertes sur les indicateurs avancés pour détecter les problèmes tôt. Un équilibre de sensibilité entre signal et bruit. Des playbooks de réponse clairs pour que chacun sache quoi faire. Une intégration inter-fonctionnelle pour impliquer les bonnes parties prenantes. Et un affinement continu pour améliorer la précision au fil du temps.
Commencez simplement, mesurez la précision, affinez en continu. Le meilleur système d'alerte précoce est celui auquel les CSM font confiance et sur lequel ils agissent.
Construisez votre système d'alerte précoce. Détectez le risque tôt. Intervenez de façon proactive. Regardez votre rétention s'améliorer.
Prêt à construire votre système d'alerte précoce ? Commencez par le suivi de la santé client, concevez des modèles de health score et mettez en place la gestion des clients à risque.
Pour aller plus loin :
Senior Operations & Growth Strategist
On this page
- Le concept de système d'alerte précoce
- Indicateurs avancés et indicateurs retardés
- Gérer le signal et le bruit
- Les fenêtres de temps pour intervenir
- Niveaux de gravité et escalade
- Les catégories de signaux de risque
- Baisse d'usage et désengagement
- Dégradation de la relation
- Baisse du sentiment et de la satisfaction
- Schémas de problèmes et de support
- Changements chez les parties prenantes
- Activité concurrentielle
- Construire des systèmes d'alerte
- Configuration des déclencheurs d'alerte
- Méthode de définition des seuils
- Priorisation et routage des alertes
- Canaux et moments de notification
- Suppression et dédoublonnage des alertes
- Playbooks de réponse aux alertes
- Protocoles de réponse par type d'alerte
- Étapes d'investigation et de validation
- Stratégies d'intervention
- Procédures d'escalade
- Exigences de documentation
- Gérer la fatigue d'alerte
- Équilibrer sensibilité et bruit
- Affinement et réglage des alertes
- Consolider les alertes liées
- Le machine learning pour réduire le bruit
- Tenir compte de la capacité de l'équipe
- Intégration inter-fonctionnelle
- Coordination avec l'équipe Sales
- Boucles de feedback avec l'équipe Produit
- Collaboration avec l'équipe Support
- Circuits d'escalade vers la direction
- Mesurer l'efficacité du système
- Précision des alertes (vrais et faux positifs)
- Délai de réponse
- Taux de réussite des interventions
- Suivi des clients sauvés
- Indicateurs d'amélioration du système
- Techniques d'alerte avancées
- Analyse prédictive et ML
- Reconnaissance de schémas
- Comparaison de cohortes
- Détection d'anomalies
- Corrélation multi-signaux
- L'essentiel à retenir