Résolution des incidents et support : transformer les problèmes en leviers de fidélisation - 2026
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
La façon dont vous traitez les problèmes compte plus que les problèmes eux-mêmes. Chaque incident est un moment de vérité. Votre réponse renforce la confiance ou l'érode. Votre suivi consolide la relation ou l'abîme.
Les clients s'attendent à rencontrer des problèmes. Les logiciels ont des bugs. Les intégrations tombent en panne. Les utilisateurs font des erreurs. Ce que les clients ne pardonnent pas, c'est l'indifférence, la communication défaillante ou l'absence de prise en main du sujet.
Les entreprises qui affichent les meilleurs taux de rétention ne sont pas celles qui n'ont aucun incident. Ce sont celles qui les gèrent si bien que leurs clients sont plus fidèles après le problème qu'avant.
Quand un client vous dit « la façon dont vous avez géré cet incident m'a rendu encore plus confiant dans notre partenariat », vous avez transformé un point négatif en avantage concurrentiel. C'est l'objectif.
Une bonne résolution d'incident allie rapidité, transparence, empathie et sens des responsabilités. Le client se sent écouté, informé et soutenu tout au long du processus. L'incident est réglé en profondeur. La relation en sort renforcée.
Le rôle du CS dans la résolution des incidents
Votre téléphone sonne à 14 h un mardi. Votre plus gros compte n'accède plus à la plateforme. La production est à l'arrêt pour 200 utilisateurs. Le CEO pose des questions. Qui est responsable ?
Cela dépend de ce que recouvre « cela ». S'il s'agit de corriger le problème technique, c'est l'affaire du Support ou de l'Engineering. S'il s'agit de gérer la relation client pendant la crise, c'est la vôtre.
La plupart des entreprises se partagent la résolution des incidents entre le Support et le CS, mais la frontière varie. Le Support gère en général le dépannage technique : identifier les bugs, corriger les problèmes de configuration, guider les utilisateurs dans les fonctionnalités, répondre aux incidents. Il résout le problème technique immédiat.
Le CS s'occupe de tout ce qui entoure ce problème. Vous évaluez l'impact stratégique sur le compte. Vous gérez les attentes des parties prenantes. Vous coordonnez l'escalade lorsque le Support a besoin de moyens supplémentaires. Vous veillez à ce que le client ne se sente pas abandonné pendant la gestion de crise. Et vous faites un suivi ensuite pour vous assurer qu'il est satisfait et qu'il comprend ce qui s'est passé.
Voyez les choses ainsi : le Support répare le produit. Le CS protège la relation.
Quand l'incident relève directement de vous : problèmes d'adoption, divergence stratégique, conduite du changement dans l'organisation, écarts de réalisation de valeur. Ce ne sont pas des bugs techniques, mais des défis de relation et de business. Vous en êtes responsable de bout en bout.
Quand vous coordonnez sans être responsable : bugs techniques, défauts du produit, échecs d'intégration, problèmes de performance. Le Support ou l'Engineering est responsable de la correction. Vous êtes responsable de faire en sorte que le client se sente bien pris en charge pendant ce temps.
Voici à quoi ressemble la coordination en pratique. Un client signale que son intégration API renvoie des erreurs 500. Vous consignez l'incident, impliquez le Support, expliquez le contexte business (« ils lancent une nouvelle application mobile la semaine prochaine, qui dépend de cette API ») et fixez les attentes avec le client (« notre équipe enquête en ce moment, j'aurai une première évaluation d'ici la fin de la journée »). Le Support débogue l'API. Vous tenez le client informé et vous gérez son inquiétude face à l'échéance de lancement.
L'élément le plus important de votre rôle est la défense du client en interne. Vous représentez son point de vue. Vous faites en sorte que son urgence soit bien perçue. Vous poussez pour une priorisation lorsque l'impact business est élevé. Vous êtes le champion du client.
« Ce n'est pas un simple désagrément mineur. Ils lancent auprès de 500 nouveaux utilisateurs la semaine prochaine, et ce bug bloque leur mise en production. Nous devons en faire une priorité. »
Votre capacité à mobiliser les bonnes ressources au bon moment détermine la qualité de la résolution. Il vous faut des relations avec l'Engineering pour les problèmes produit, avec le Support pour le dépannage technique, avec le Product pour les demandes de fonctionnalités et les solutions de contournement, avec la direction pour les escalades et les décisions critiques, et avec l'équipe commerciale du compte pour le contexte business.
Quand un incident critique survient, vous êtes le chef d'orchestre. Les autres jouent chacun de leur instrument. Vous veillez à ce qu'ils jouent la même partition.
Et tout au long du processus, vous protégez la relation. Les problèmes créent du stress. Les émotions montent. Une communication calme, régulière et transparente préserve la relation pendant que le problème se règle.
Détection et prise en charge des incidents
Les meilleurs CSM repèrent les incidents avant que les clients ne les signalent.
Vous parcourez votre dashboard lundi matin et remarquez que l'un de vos comptes a enregistré trois échecs de connexion pendant le week-end. L'usage a chuté de 40 % vendredi. Leur champion ne s'est pas connecté depuis mardi. Quelque chose ne va pas.
Vous les contactez : « Bonjour, j'ai remarqué une activité inhabituelle sur votre compte. Que se passe-t-il ? »
Il s'avère qu'ils ont déployé une nouvelle configuration SSO qui bloque la moitié de leurs utilisateurs. Ils comptaient vous écrire aujourd'hui. Mais vous le saviez déjà. C'est cela, la détection proactive des incidents.
Mettez en place une surveillance des baisses de health score, des changements de schémas d'usage, des pics de tickets de support, des journaux d'erreurs du produit et des lacunes d'adoption de fonctionnalités. Votre plateforme CS devrait faire remonter tout cela automatiquement, mais si ce n'est pas le cas, créez vos propres alertes. Vérifiez au minimum chaque semaine.
Lorsque des clients signalent directement des incidents, par e-mail, par téléphone, via un feedback dans l'application ou lors de vos points de suivi réguliers, disposez d'un processus de prise en charge clair. Qui consigne l'incident ? Où va-t-il ? De quelles informations avez-vous besoin ? Sous quel délai répondez-vous ?
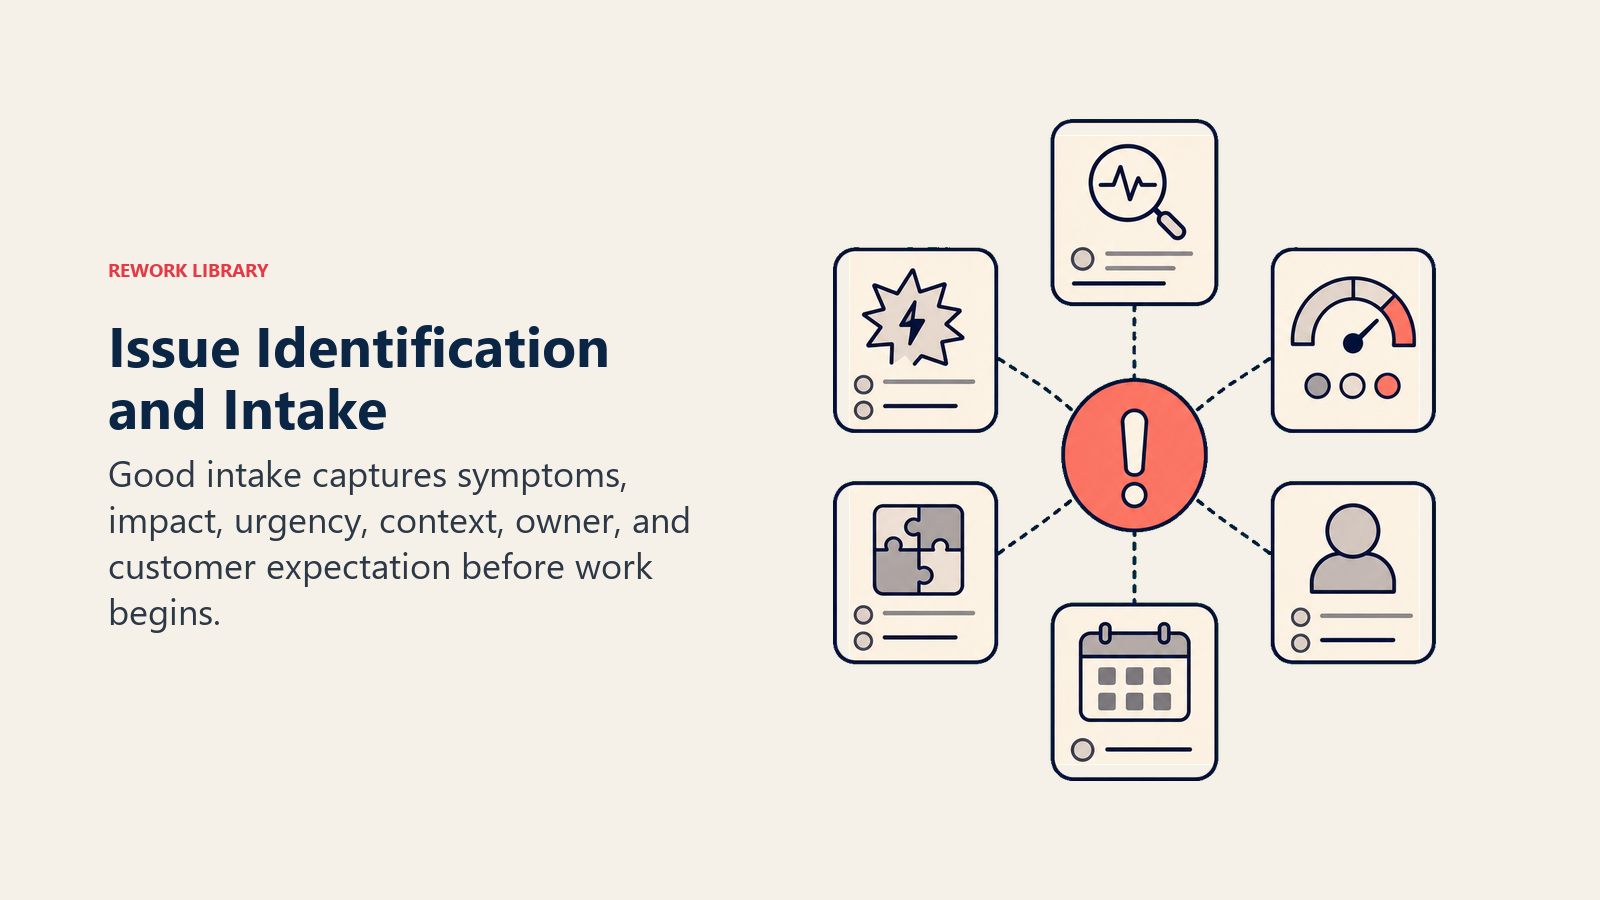
Voici ce qu'il faut recueillir immédiatement :
- Ce qui est cassé ou ne fonctionne pas comme prévu
- Ce que l'utilisateur essayait de faire
- Le nombre d'utilisateurs concernés
- L'impact business
- Les solutions de contournement déjà essayées
- Le degré d'urgence pour le client
Obtenez ces informations dès le premier échange. Ne les faites pas répéter à trois interlocuteurs différents.
Par ailleurs, n'attendez pas que le Support vous escalade les tickets. Passez régulièrement en revue les tickets de vos comptes. Configurez un dashboard qui affiche le volume de tickets, les tendances de gravité et les incidents fréquents par compte. Si l'un de vos comptes a ouvert quatre tickets en une semaine sur la même fonctionnalité, vous devez le savoir. Il y a peut-être un problème de formation plus large. Peut-être que la fonctionnalité ne correspond pas à leur workflow. Peut-être qu'il existe un bug que le Support n'a pas encore relié aux autres.
Les anomalies d'usage signalent souvent des incidents que les clients n'ont pas encore remontés. Une chute soudaine de l'usage peut signifier qu'ils ont trouvé une solution de contournement en dehors de votre produit. Une hausse du taux d'erreurs peut signifier que quelque chose est tombé en panne et qu'ils s'en accommodent en silence. L'abandon d'une fonctionnalité peut signifier qu'ils ont essayé, que cela n'a pas marché, et qu'ils ont renoncé. Votre plateforme doit vous alerter sur ces schémas.
Et soyez attentif à ce que les clients ne disent pas à voix haute. Une remarque lancée en passant pendant une QBR. Un ton agacé en évoquant une fonctionnalité précise. Une réponse de détracteur NPS mentionnant des « problèmes de fiabilité ». Ce sont des signaux. Faites un suivi. Mettez au jour le vrai problème avant qu'il ne devienne un risque de churn.
Évaluation et priorisation des incidents
Tous les incidents ne méritent pas la même réponse. Vous ne pouvez pas tout traiter comme critique, sinon plus rien ne le sera.
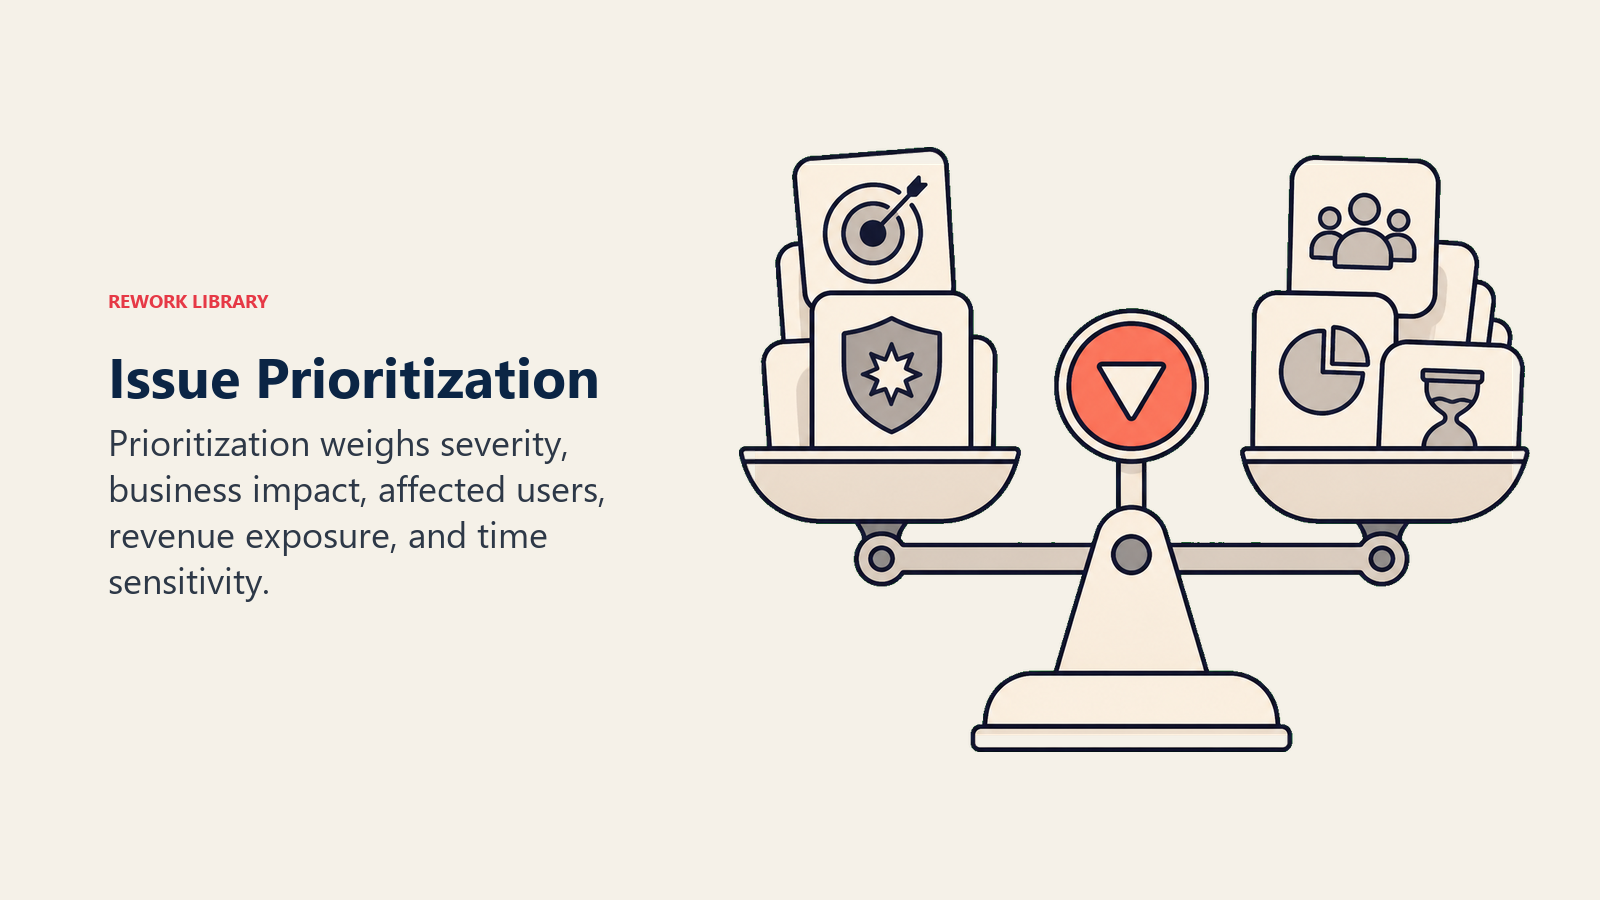
Commencez par l'impact et l'urgence. L'impact répond à ces questions : dans quelle mesure le client est-il touché ? Son activité est-elle à l'arrêt ? S'agit-il d'une gêne importante ? Ou d'un simple désagrément mineur ?
Un incident vraiment critique bloque des processus clés de l'entreprise. Du chiffre d'affaires est en jeu. Les gens ne peuvent plus faire leur travail. Un incident à fort impact perturbe des workflows importants, mais des solutions de contournement existent, même pénibles. Un impact moyen est gênant mais gérable. Un impact faible passe presque inaperçu.
L'urgence est un critère distinct. Elle répond à la question : dans quel délai faut-il résoudre le problème ? Un incident qui bloque un lancement produit demain est urgent même si le problème sous-jacent est mineur. Un bug agaçant présent depuis six mois est peu urgent, même s'il a un impact modéré.
Il faut aussi tenir compte du contexte business. Un problème technique mineur sur un compte stratégique proche du renouvellement peut passer avant un problème majeur sur un petit compte en bonne santé qui vient de renouveler. La taille du compte (ARR), son importance stratégique, son état de santé actuel, la visibilité auprès des dirigeants et le risque concurrentiel comptent tous.
La segmentation client influe aussi sur l'allocation des ressources. Les clients Enterprise attendent une réponse immédiate et un accompagnement sur mesure. Le mid-market attend une réponse rapide selon un processus standard. Les SMB reçoivent des délais de réponse standard et une résolution efficace. Connaissez vos engagements de SLA par segment.
Prenons un exemple concret. Le client A signale un bug qui l'empêche d'exporter des rapports. Valeur annuelle du contrat : 500 000 $. Date de renouvellement : le mois prochain. Health score actuel : jaune. Il en a déjà parlé lors de deux appels précédents. Priorité : haute.
Le client B signale le même bug. Valeur annuelle du contrat : 15 000 $. Il a renouvelé le trimestre dernier. Health score : vert. Il n'en avait jamais parlé. Priorité : moyenne.
Même problème technique. Priorités business différentes.
Définissez explicitement vos critères d'escalade pour que les décisions soient cohérentes et non dictées par l'émotion. Escaladez lorsque la gravité est critique ou l'impact élevé. Lorsqu'une échéance approche alors que l'incident n'est pas résolu. Lorsque le compte est stratégique ou qu'il existe un risque sur le renouvellement. Lorsque la résolution exige une expertise senior ou des décisions de la direction. Lorsqu'un schéma récurrent révèle un problème systémique.
Mettez ces critères par écrit. Formez votre équipe. Ainsi, quand vous escaladez, vous pouvez expliquer pourquoi dans un langage que tout le monde comprend.
Processus de gestion des incidents
Chaque incident est consigné. Sans exception.
Utilisez votre CRM ou votre plateforme CS pour documenter le détail de l'incident, attribuer une gravité et une priorité, le rattacher au compte client, suivre le statut et l'avancement, conserver toutes les communications et mesurer le délai de résolution. Ce qui n'est pas dans le système n'existe pas.
Ce n'est pas de la bureaucratie. C'est de la responsabilisation. Cela permet de repérer des schémas, de mesurer la performance, de prouver que vous traitez les préoccupations des clients et de vous assurer que rien ne passe entre les mailles du filet.
Désignez dès le départ des responsables clairs. Qui pilote la résolution d'ensemble ? Qui fait le travail technique ? Qui gère la communication avec le client ? Pour les incidents critiques, qui est le sponsor exécutif ? Rendez cela explicite. Écrivez-le. Dites-le à tous les intervenants.
Définissez ensuite un rythme de communication et tenez-le. Pour les incidents critiques, informez le client chaque jour, voire plusieurs fois par jour. Les incidents de priorité haute donnent lieu à un point tous les 2 à 3 jours. La priorité moyenne, à un point hebdomadaire. La priorité basse, à un point lorsque des avancées significatives ont lieu.
Dites d'emblée au client à quoi s'attendre : « Je ferai un point mercredi et vendredi jusqu'à la résolution. »
Et faites-le vraiment. Même si le point se résume à « nous travaillons toujours dessus et nous n'avons pas encore avancé ». Le silence radio détruit la confiance plus vite qu'une progression lente.
En interne, suivez le temps écoulé depuis l'ouverture de l'incident, le temps écoulé depuis la dernière mise à jour, les blocages et dépendances, les prochaines étapes et leurs responsables, ainsi que le niveau de satisfaction du client face à l'avancement. Quand les choses stagnent, quand l'Engineering attend une décision du Product, quand le Support attend que le client fournisse des journaux, c'est à vous de débloquer la situation. Relancez les personnes. Faites prendre les décisions. Gardez le rythme.
Quand vous pensez que l'incident est résolu, vérifiez-le sérieusement. Le correctif technique fonctionne-t-il ? L'utilisateur peut-il mener à bien sa tâche initiale ? L'impact business a-t-il disparu ? Le client est-il satisfait ?
Ne fermez pas le ticket parce que l'Engineering dit « c'est déployé ». Fermez-le quand le client confirme : « oui, cela fonctionne maintenant ».
Documentez ensuite l'ensemble : cause racine, solution mise en œuvre, délai de résolution, retour du client, enseignements tirés et mesures prises pour éviter que cela ne se reproduise. Partagez ces éléments en interne. Mettez à jour vos runbooks. Formez les nouveaux arrivants à partir de ce cas. Chaque incident doit rendre toute votre entreprise plus avisée.
Gestion des escalades
Vous escaladez vers le Support lorsque vous avez besoin d'une expertise technique qui dépasse vos connaissances, lorsque le dépannage standard a échoué, lorsque vous soupçonnez un bug produit ou lorsque plusieurs clients signalent le même problème.
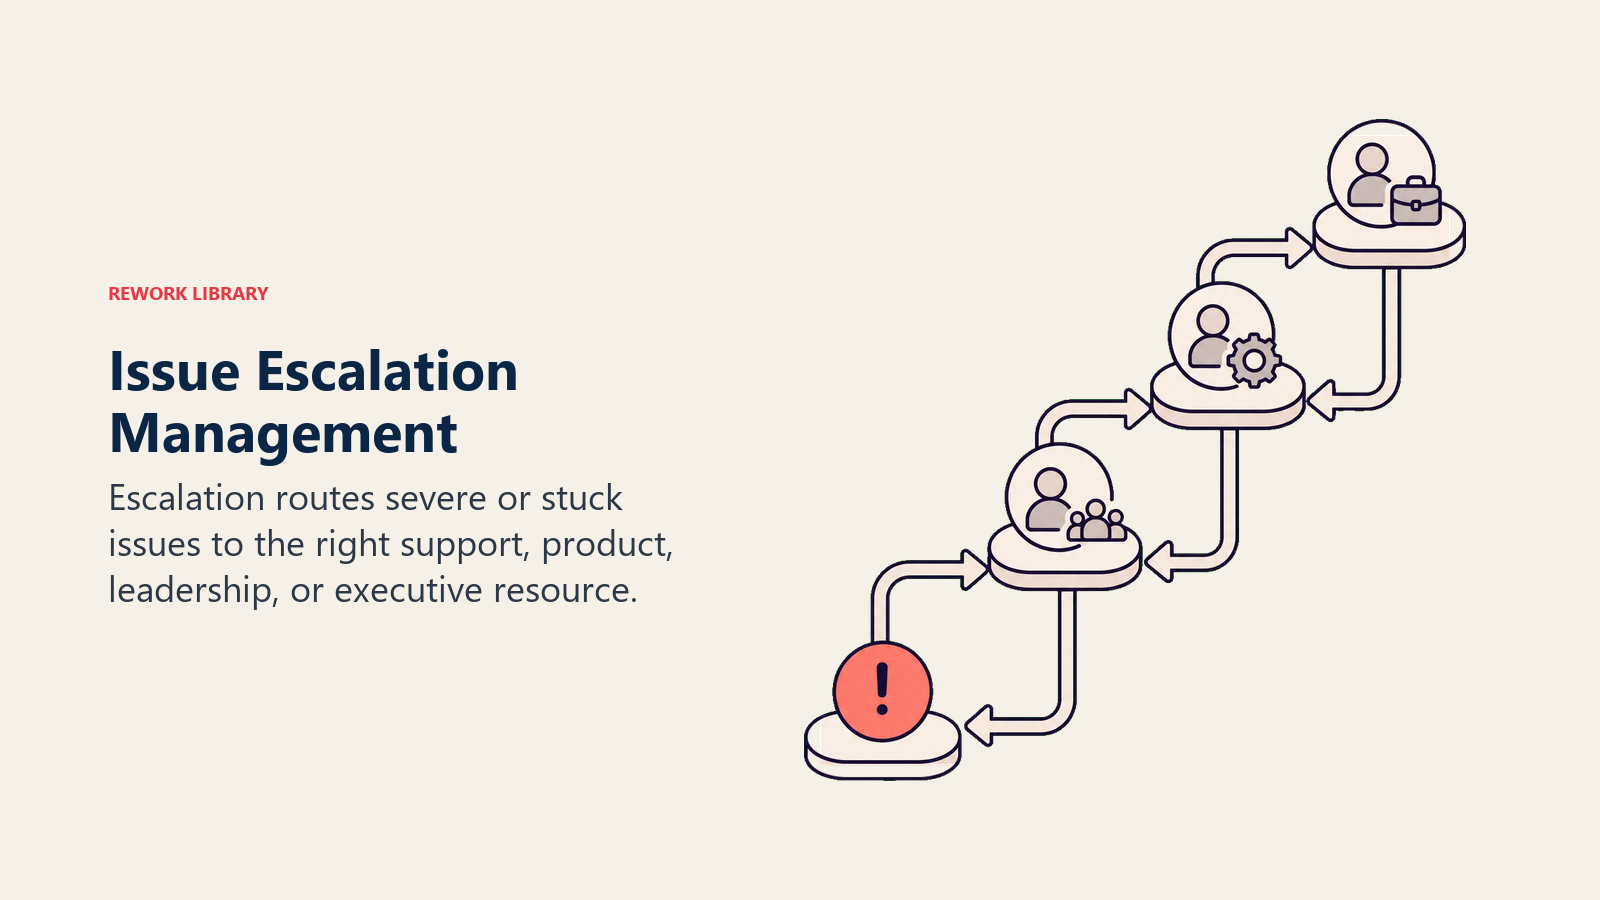
Dans ce cas, donnez-leur du contexte. Ne vous contentez pas de transférer l'e-mail du client. Expliquez ce que le client cherche à accomplir, ce qu'il a déjà essayé, l'impact business et l'urgence. Facilitez leur travail.
Vous escaladez vers l'Engineering lorsque le Support confirme un bug produit, lorsque le client a besoin d'un correctif spécifique, lorsque les solutions de contournement sont insuffisantes ou lorsque des questions d'architecture se posent.
Construisez l'argumentaire business. « Cela touche 40 % des clients Enterprise. La solution de contournement ajoute 30 minutes à un workflow quotidien. » Aidez-les à arbitrer par rapport à leurs autres chantiers.
Vous escaladez vers la direction lorsque la résolution exige une exception à la politique en vigueur, lorsque vous avez besoin de ressources importantes ou d'arbitrages, lorsque le client menace de partir, lorsqu'il existe un risque médiatique ou juridique, ou lorsqu'il faut arbitrer entre des priorités transverses.
Arrivez préparé. « Voici la situation, voici ce que demande le client, voici les arbitrages possibles, et voici ma recommandation. » Ne vous contentez pas de remonter un problème brut.
Quand vous escaladez auprès du client, c'est-à-dire que vous lui annoncez que vous impliquez des personnes plus seniors ou plus spécialisées, présentez-le comme une priorisation, pas comme un échec.
« J'escalade ce sujet à notre équipe d'ingénierie, car il demande une investigation technique plus poussée que ce que le support peut fournir. Notre directeur de l'ingénierie l'examinera d'ici la fin de la journée, et je reviendrai vers vous demain matin avec un plan. »
Cela montre que vous le prenez au sérieux et que vous mobilisez les experts. Pas que vous baissez les bras.
Gérer les attentes pendant les escalades est essentiel. Fixez des délais réalistes. Expliquez le processus. Engagez-vous sur une communication précise. Puis tenez ces engagements.
Promettez moins, faites mieux. « J'aurai une mise à jour d'ici vendredi » et un envoi mercredi renforcent la confiance. « Je l'aurai pour mardi » et un envoi vendredi la détruisent.
Et même après avoir escaladé, vous restez l'interlocuteur du client. Vous n'avez pas le droit de dire : « J'ai escaladé auprès du Support, voyez avec eux pour les mises à jour. »
Vous dites : « J'ai escaladé le sujet et je suis l'avancement de près. Je vous tiendrai informé toutes les 48 heures. » Ensuite, vous relancez les équipes internes, obtenez des informations, traduisez le jargon technique et gérez la communication.
Ne laissez jamais le client se perdre dans votre organigramme interne.
Communication avec le client pendant l'incident
Accusez réception de l'incident rapidement. En quelques heures pour les incidents de gravité élevée. Dans les 24 heures pour tous les autres.
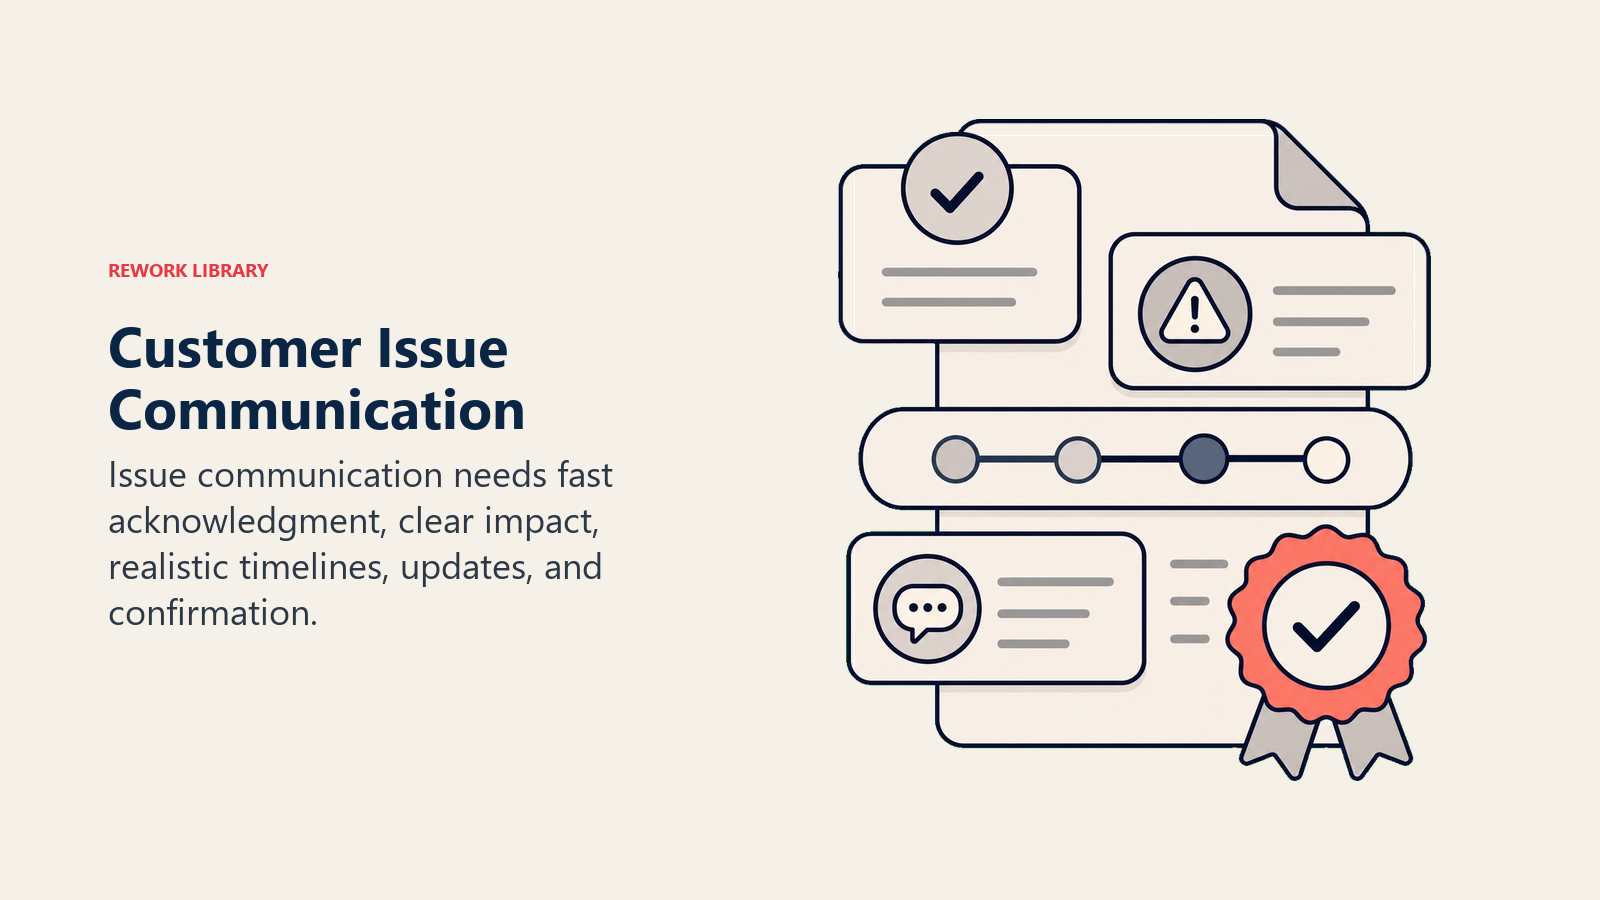
« Merci d'avoir attiré mon attention sur ce point. Je comprends que cela affecte [workflow concerné]. J'enquête avec notre équipe et je reviendrai vers vous avec une première évaluation d'ici [heure précise]. »
Montrez que vous les avez entendus. Montrez que vous comprenez l'impact. Montrez que vous êtes sur le sujet.
Tenez-les ensuite régulièrement informés. Même quand il n'y a pas de nouvelle.
« Petit point d'étape : notre équipe d'ingénierie a identifié la cause racine, un dépassement de délai d'une requête de base de données en cas de forte charge. Elle met en place un correctif qui sera déployé mercredi. Je vous confirmerai jeudi matin que tout fonctionne. »
Partagez l'avancement, les prochaines étapes et le calendrier. Le silence est pire qu'un « nous y travaillons toujours ».
Soyez transparent sur les délais. Donnez le scénario réaliste, pas le meilleur cas. Expliquez les retards ou complications possibles. Dites ce que vous faites pour accélérer.
« Le développement et les tests du correctif prennent généralement 2 à 3 jours. Nous en faisons une priorité, donc je vise un déploiement mercredi. En cas de retard, je vous préviendrai immédiatement. »
Quand les clients s'énervent, et cela arrivera, reconnaissez leur frustration sans chercher d'excuses.
Client : « C'est la troisième fois ce mois-ci. Je perds confiance. »
Vous : « Je comprends votre frustration. Trois incidents en un mois, ce n'est pas acceptable, et je réagirais de la même façon. Laissez-moi vous expliquer ce que nous faisons à la fois pour cet incident précis et pour le problème de fond. »
Reconnaissez leurs émotions. Assumez la responsabilité. Concentrez-vous sur les solutions et l'amélioration.
Fixez des attentes réalistes tout au long du processus. Ne promettez pas ce que vous ne pouvez pas tenir. Prévoyez une marge dans vos délais. Expliquez les dépendances et les risques. Définissez ce que « corrigé » veut dire, car les clients attendent parfois plus que ce que vous livrez réellement. Mieux vaut être réaliste et répondre aux attentes qu'être optimiste et décevoir.
Dès que l'incident est résolu, bouclez la boucle.
« L'incident est résolu. Pouvez-vous confirmer de votre côté que [workflow concerné] fonctionne correctement ? J'ai également documenté la cause et les mesures prévues pour éviter que cela ne se reproduise, et je vous les présenterai lors de notre prochain appel. »
Faites confirmer la résolution. Montrez que vous tenez à éviter toute récidive. Documentez les enseignements.
Suivi après résolution
Dans les 24 à 48 heures suivant le déploiement du correctif, refaites un point.
« Je reviens vers vous pour confirmer que l'incident est bien résolu de votre côté. Avez-vous pu [accomplir la tâche qui était bloquée] ? Des réserves persistent-elles ? »
Ne partez pas du principe que c'est réglé parce que l'Engineering annonce que c'est déployé. Vérifiez auprès du client.
Demandez ensuite quel est son niveau de satisfaction quant à la façon dont vous avez géré l'incident.
« Quel est votre niveau de satisfaction quant à la façon dont nous avons traité cet incident ? Qu'aurions-nous pu faire mieux ? »
Vous voulez un retour sur le processus, pas seulement sur le résultat. L'incident a peut-être été corrigé vite, mais votre communication était irrégulière. Ou la résolution a pris plus de temps qu'ils ne le souhaitaient, mais ils ont apprécié que vous les teniez informés. Tirez des enseignements des deux cas.
Expliquez la cause racine dans un langage qu'ils comprendront.
« La cause racine était [explication technique en langage simple]. Nous avons mis en place [changements précis] pour éviter que cela ne se reproduise. »
Les clients apprécient la transparence. Ils veulent savoir pourquoi cela s'est produit, pas seulement que c'est corrigé. Et ils veulent savoir que vous faites le nécessaire pour que cela ne se reproduise pas.
Montrez-leur les mesures de prévention que vous avez mises en place.
« À la suite de cet incident, nous avons ajouté une surveillance supplémentaire pour le détecter plus tôt, mis à jour notre processus QA pour tester ce scénario et ajouté ce contrôle à notre checklist de déploiement. »
Cela montre que les problèmes débouchent sur des améliorations systémiques. Cela prouve que vous progressez en tant qu'entreprise, au lieu de régler les incidents un par un.
Si l'incident était majeur ou mal géré, traitez frontalement les dégâts sur la relation. Ne laissez pas la situation pourrir. Dans les cas vraiment graves, impliquez un dirigeant qui présentera des excuses personnelles. Envisagez des avoirs de service ou une compensation si elle est justifiée. Engagez-vous sur un plan d'amélioration précis. Offrez une attention renforcée et un accompagnement sur mesure pendant un temps.
Ne faites pas comme si rien ne s'était passé. Assumez et réparez.
Enfin, capitalisez sur les enseignements pour l'organisation. Documentez l'incident et sa résolution. Partagez-les avec votre équipe et le Product. Mettez à jour vos runbooks et vos processus. Intégrez-les à la formation des nouveaux arrivants. Suivez les schémas pour repérer les problèmes systémiques. Chaque incident doit rendre toute votre entreprise plus efficace pour prévenir le suivant.
Transformer les incidents en occasions
Un incident bien géré prouve votre engagement comme jamais un long fleuve tranquille ne pourrait le faire.
Pensez-y. Quand tout fonctionne parfaitement, les clients estiment que c'est normal. Mais quand quelque chose tombe en panne et que vous répondez avec rapidité, transparence, sens des responsabilités et suivi, ils voient votre vrai visage.
Les études montrent systématiquement que les clients ayant vécu un incident bien géré deviennent souvent plus fidèles que ceux qui n'en ont jamais connu. La résolution prouve que vous êtes fiable sous pression.
Avant l'incident : « Ils ont l'air bien. » Après une excellente résolution : « Ils sont vraiment là pour nous. »
Les incidents font aussi émerger des pistes d'amélioration du produit. Chaque bug est l'occasion d'améliorer le produit. Chaque point de friction UX indique où retravailler l'interface. Chaque fonctionnalité manquante montre ce qu'il faut construire ensuite. Les messages d'erreur qui ont dérouté les clients deviennent plus clairs. Les lacunes de documentation sont comblées. Les besoins d'intégration entrent dans la roadmap.
Votre suivi des incidents devient du feedback produit. Veillez à ce que le Product le voie.
Et parfois, bien gérer un incident ouvre des perspectives d'expansion. La bonne volonté née d'une résolution réussie ouvre des portes qui vous étaient fermées jusque-là.
« Maintenant que nous avons réglé cela, assurons-nous que vous tirez pleinement parti de la plateforme. Avez-vous envisagé [piste d'expansion] ? »
Le client est satisfait du partenariat. Il vous fait confiance. Il vous a vu tenir bon sous pression. C'est le moment de proposer la suite.
Mieux encore, les clients qui étaient frustrés mais ont vu que vous avez tout fait pour réparer deviennent vos meilleurs champions. Ils racontent comment vous avez géré la situation.
« Nous avons eu un incident majeur le trimestre dernier, et leur équipe a été formidable. Elle est restée mobilisée jusqu'à la résolution complète, puis nous a montré précisément ce qui avait changé pour que cela ne se reproduise pas. C'est un partenaire de confiance. »
Ce témoignage vaut plus que n'importe quelle campagne marketing.
Analyse des schémas d'incidents
Suivez les incidents récurrents de façon systématique. Taguez-les dans votre CRM avec des catégories comme le périmètre produit, le type de cause racine, le segment client et la gravité. Passez ensuite en revue les schémas chaque mois.
Si le même incident touche plusieurs clients, c'est un problème produit à corriger, pas un cas isolé de support.
Si le même client rencontre des incidents à répétition, il peut s'agir d'un manque de formation, d'un client mal adapté ou d'un problème de configuration spécifique.
Si les incidents augmentent à certains moments, c'est peut-être après les mises en production, peut-être pendant les pics d'utilisation, peut-être quand certains workflows sont sollicités.
Distinguez les incidents propres à un client des incidents systémiques. Les incidents propres à un client (problèmes ponctuels, erreurs de configuration, erreurs d'utilisateur) se règlent et se classent. Documentez-les pour référence, mais ils n'ont pas besoin d'être escaladés.
Les incidents systémiques (schémas observés chez plusieurs clients, bugs produit, fonctionnalités manquantes) doivent être escaladés au Product. Rédigez une documentation sur les solutions de contournement. Communiquez de façon proactive à tous les clients concernés. Suivez le dossier jusqu'à l'obtention d'un correctif définitif.
Réunissez-vous chaque semaine ou chaque mois avec l'équipe Product pour examiner les schémas d'incidents. Constituez un backlog d'incidents priorisé. Documentez pour chacun l'impact client et le risque sur le chiffre d'affaires. Chiffrez le problème. « Cela touche 30 clients représentant 2 M$ d'ARR. Huit d'entre eux arrivent à renouvellement au cours du prochain trimestre. »
Rendez la douleur des clients visible et exploitable.
Cherchez aussi des gains d'efficacité pour le support. Quels incidents reviennent sans cesse faute de documentation ? Où l'équipe de support a-t-elle besoin d'une meilleure formation ? Qu'est-ce qui pourrait être automatisé ? Quel contenu en libre-service réduirait le volume de tickets ? Où les critères de déclenchement des escalades sont-ils flous ?
Et identifiez des mesures préventives. Quelles alertes de surveillance détecteraient les incidents avant que les clients ne les signalent ? Quelles améliorations de l'onboarding éviteraient les erreurs courantes ? Où une meilleure formation des utilisateurs aiderait-elle ? Quelles améliorations UX rendraient les fonctionnalités plus intuitives ? Quelles bonnes pratiques de configuration faut-il documenter ?
Le meilleur incident est celui qui n'arrive jamais.
Modèles et ressources
Workflow de gestion des incidents
1. Identification de l'incident
- Source : [Signalement client / Détection proactive / Ticket de support]
- Date/heure : [Horodatage]
- Impact : [Critique / Élevé / Moyen / Faible]
- Périmètre concerné : [Workflow / Fonctionnalité / Utilisateurs touchés]
2. Évaluation initiale
- Criticité business : [Contexte du compte]
- Segment client : [Niveau de service]
- Sensibilité au calendrier : [Échéances ou événements]
- Santé de la relation : [Health score actuel]
3. Attribution des responsabilités
- Responsable CS : [Nom]
- Responsable technique : [Support/Engineering]
- Sponsor exécutif (si critique) : [Nom]
4. Plan de communication
- Accusé de réception initial : [Sous X heures]
- Rythme des mises à jour : [Tous les X jours/heures]
- Canaux : [E-mail / Appel / Slack]
5. Suivi de la résolution
- Cause racine identifiée : [Date]
- Solution mise en œuvre : [Date]
- Vérification par le client : [Date]
- Incident clos : [Date]
6. Suivi
- Vérification de la satisfaction : [Fait / En attente]
- Cause racine expliquée : [Fait / En attente]
- Mesures de prévention : [Documentées]
- Enseignements consignés : [Fait / En attente]
Matrice d'escalade
| Type d'incident | Gravité | Première réponse | Chemin d'escalade | Rythme des mises à jour |
|---|---|---|---|---|
| Bug produit | Critique | <2 heures | Support → Ingénierie → Direction produit | Toutes les 4 à 6 heures |
| Bug produit | Élevée | <4 heures | Support → Engineering | Quotidien |
| Bug produit | Moyenne | <24 heures | Support | Tous les 2 à 3 jours |
| Échec d'intégration | Critique | <2 heures | Support → Engineering → Partnerships | Toutes les 4 à 6 heures |
| Problème de performance | Critique | <2 heures | Support → Engineering → Infrastructure | Toutes les 4 à 6 heures |
| Demande de fonctionnalité | Toutes | <24 heures | CS → Product | Selon l'avancement |
| Formation/adoption | Toutes | <24 heures | Équipe CS | Hebdomadaire |
Modèles de communication
Accusé de réception initial (incident critique)
Objet : [Description de l'incident] - Analyse en cours en priorité
Bonjour [Prénom],
Merci d'avoir attiré mon attention sur ce point. Je comprends que cela bloque [workflow concerné] et affecte actuellement [périmètre business].
Voici ce que je fais immédiatement :
- J'ai escaladé le sujet à notre équipe [Engineering/Support] en P1
- [Interlocuteur technique] analyse la cause racine en ce moment
- Vous recevrez de ma part une première évaluation et un plan d'action d'ici [heure précise aujourd'hui]
Je vous tiendrai informé toutes les [4 à 6 heures] jusqu'à la résolution complète. Vous pouvez me joindre à tout moment au [coordonnées].
Je m'en occupe.
[Votre nom]
Point d'étape pendant la résolution
Objet : Point d'étape : [Description de l'incident]
Bonjour [Prénom],
Petit point d'étape sur [l'incident] :
Avancement : [Ce qui a été fait depuis la dernière mise à jour]
Statut actuel : [Ce qui se passe en ce moment]
Prochaines étapes : [Ce qui se passera ensuite et quand]
Calendrier : [Délai de résolution prévu]
[Blocages ou risques éventuels]
Prochain point prévu [jour/heure]. N'hésitez pas à me contacter si vous avez des questions.
[Votre nom]
Confirmation de la résolution
Objet : Résolu : [Description de l'incident]
Bonjour [Prénom],
Bonne nouvelle : [l'incident] est résolu. Notre équipe d'ingénierie a déployé ce matin un correctif qui traite la cause racine.
Ce qui a été corrigé : [Explication en langage simple]
Ce que cela change pour vous : [Comment cela résout votre problème]
Ce que nous faisons pour l'éviter : [Mesures de prévention mises en œuvre]
Pouvez-vous confirmer de votre côté que [fonctionnalité concernée] fonctionne correctement ? Je referai un point avec vous [demain/lors du prochain appel] pour m'assurer que tout est solide.
Merci de votre patience pendant le traitement de ce sujet.
[Votre nom]
Suivi après résolution
Objet : Suivi de la résolution de [l'incident]
Bonjour [Prénom],
Je voulais faire un dernier point sur [l'incident] que nous avons résolu la semaine dernière.
Quelques questions rapides :
- Tout fonctionne-t-il bien de votre côté ?
- Quel est votre niveau de satisfaction quant à la façon dont nous avons traité l'incident ? (échelle de 1 à 5)
- Qu'aurions-nous pu faire mieux ?
Vos retours nous aident à nous améliorer pour tous nos clients.
J'ai par ailleurs documenté la cause racine et les mesures de prévention, si vous souhaitez le détail. Je serai ravi de les passer en revue lors de notre prochain appel.
Merci encore pour votre patience et votre partenariat.
[Votre nom]
Champs du système de suivi
Fiche d'incident (CRM/plateforme CS)
- ID de l'incident : [Identifiant unique]
- Client : [Nom du compte et lien]
- Gravité : [Critique / Élevée / Moyenne / Faible]
- Catégorie : [Bug / Fonctionnalité / Formation / Intégration / Performance]
- Statut : [Nouveau / En analyse / En cours / Résolu / Clos]
- Ouverture : [Date/heure]
- Résolution : [Date/heure]
- Délai de résolution : [Calculé automatiquement]
- Responsable CS : [Nom]
- Responsable technique : [Nom]
- Cause racine : [Champ texte]
- Résolution : [Champ texte]
- Mesures de prévention : [Champ texte]
- Satisfaction client : [Note]
- Incidents liés : [Liens vers des incidents similaires]
- Chiffre d'affaires à risque : [Montant en dollars en cas de risque de churn]
Ressources associées
- Retention Fundamentals - Stratégies de base pour la rétention
- Gestion des clients à risque - Gérer les clients exposés à un risque de churn
- Dépannage des appels CS - Gérer les conversations difficiles avec les clients
- Suivi de la santé client - Suivre les indicateurs de santé client
- Stratégie de prévention du churn - Approches systématiques de prévention du churn
Les incidents arrivent. Votre façon d'y répondre définit vos relations clients. Rapidité, transparence, empathie et sens des responsabilités transforment les problèmes en preuves de confiance. Les clients retiennent ce qu'ils ont ressenti dans leurs moments les plus difficiles.
Bien gérés, les incidents ne font pas que résoudre des problèmes. Ils font naître des ambassadeurs.
Senior Operations & Growth Strategist
On this page
- Le rôle du CS dans la résolution des incidents
- Détection et prise en charge des incidents
- Évaluation et priorisation des incidents
- Processus de gestion des incidents
- Gestion des escalades
- Communication avec le client pendant l'incident
- Suivi après résolution
- Transformer les incidents en occasions
- Analyse des schémas d'incidents
- Modèles et ressources
- Workflow de gestion des incidents
- Matrice d'escalade
- Modèles de communication
- Champs du système de suivi
- Ressources associées