Modèles de prédiction du churn : utiliser les données pour anticiper la perte de clients
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
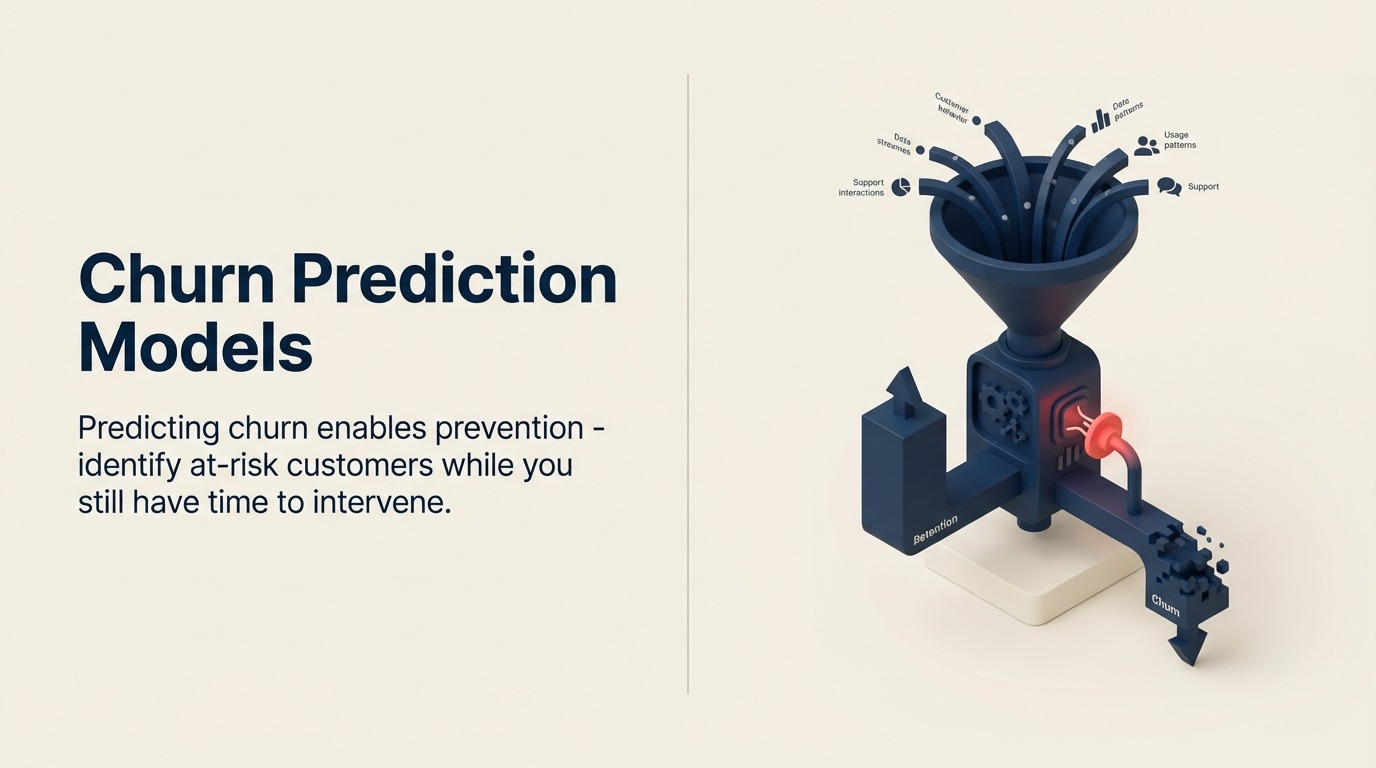
Un modèle de prédiction du churn s'appuie sur les données de comportement des clients, comme la baisse d'usage, le recul de l'engagement et les signaux du support, pour prévoir quels comptes risquent le plus de résilier, idéalement 60 à 90 jours avant qu'ils ne le fassent. Le scoring par règles détecte 60 à 70 % du churn, les modèles pondérés atteignent 75 à 80 %, et les approches de machine learning portent la précision à 85-90 %.
Votre client a envoyé un seul ticket au support le mois dernier, s'est connecté trois fois, et son usage a chuté de 30 % par rapport au mois précédent. Va-t-il partir ?
Sans modèle de prédiction, vous en êtes réduit aux suppositions. Peut-être est-il simplement débordé. Peut-être est-ce saisonnier. Ou peut-être compare-t-il déjà des concurrents, et il vous reste deux semaines pour le faire changer d'avis. Vous ne le saurez qu'à sa résiliation officielle, ce qui est trop tard.
Les modèles de prédiction du churn transforment les tendances de vos données en systèmes d'alerte précoce. Ils identifient les clients les plus susceptibles de partir, avec assez d'avance pour que votre équipe puisse réellement intervenir. Les meilleurs modèles repèrent les clients à risque 60 à 90 jours avant leur départ, ce qui vous laisse une vraie chance de traiter les problèmes et de sauver le compte.
Construire ces modèles n'exige pas un doctorat en data science. De simples modèles à règles détectent 60 à 70 % du churn. Les modèles de scoring pondéré montent à 75-80 %. Les approches de machine learning peuvent atteindre 85 à 90 % de précision. L'essentiel est de commencer par quelque chose, de mesurer son efficacité et de l'améliorer au fil du temps.
Objectifs d'un modèle de prédiction : ce que fait un bon modèle
Un modèle de prédiction du churn efficace répond à des objectifs précis.
L'identification précoce consiste à détecter le risque avant que le client ait décidé, dans sa tête, de partir. Si votre modèle ne signale que les clients qui ont déjà envoyé leur préavis de résiliation, il ne sert à rien. Il vous faut 60 à 90 jours d'avance pour faire la différence.
D'après l'analyse de Gainsight, une intervention avant le seuil des 60 jours réussit trois fois plus souvent qu'une intervention à 30 jours ou moins. À ce stade, le client a souvent déjà étudié des alternatives et pris sa décision. Vous l'apprenez simplement trop tard.
La priorisation des ressources aide votre équipe CS à concentrer son temps limité sur les clients qui en ont le plus besoin. Vous avez 500 clients et 5 CSM. Vous ne pouvez pas offrir un suivi rapproché à tout le monde. Mais vous pouvez identifier les 50 clients au risque le plus élevé et les traiter en priorité.
Sans modèle de prédiction, les CSM se dispersent ou se concentrent sur ceux qui se plaignent le plus fort. Aucune de ces deux approches n'optimise la rétention ni l'utilisation du temps de votre équipe.
Le déclenchement des interventions automatise les réponses selon le niveau de risque. Lorsqu'un client franchit un seuil de risque, votre système peut alerter automatiquement le CSM, lancer une campagne de contact, programmer un appel de revue de santé du compte ou, si nécessaire, escalader auprès de la direction. L'automatisation garantit que rien ne passe entre les mailles du filet, même quand votre équipe est débordée.
La fiabilité des prévisions vous aide à projeter vos revenus futurs et vos taux de churn avec confiance. Si vous savez que 40 comptes représentant 500 K$ d'ARR sont à haut risque ce trimestre, vous pouvez modéliser l'impact financier et vous organiser en conséquence. Les investisseurs veulent voir que vous comprenez la dynamique de votre rétention et que vous savez anticiper vos performances. De bons modèles de churn rendent cela possible.
L'amélioration continue consiste à traiter votre modèle comme un système vivant. Suivez sa précision. Comprenez quand il se trompe. Affinez les données d'entrée. Testez de nouveaux indicateurs. Un modèle qui ne s'améliore pas devient obsolète et perd en efficacité : il demande autant d'attention que votre produit.
Indicateurs prédictifs : les signaux qui annoncent le churn
Certains comportements et événements sont fortement corrélés à un churn à venir. Voici ceux qui comptent vraiment.

La baisse d'usage est le meilleur prédicteur pris isolément. Quand l'usage actif recule de 30 % ou plus d'un mois sur l'autre, le risque de churn grimpe fortement.
Slack a constaté que les équipes dont le volume de messages passe sous un certain seuil quittent le service cinq fois plus que les équipes actives. L'éditeur alerte les CSM dès qu'une baisse d'usage durable apparaît, ce qui leur laisse le temps de comprendre ce qui se passe avant qu'il ne soit trop tard.
Suivez la fréquence de connexion (quotidienne, puis hebdomadaire, puis mensuelle), l'étendue d'usage des fonctionnalités (de 10 fonctionnalités utilisées à 3), le volume d'actions clés (appels API, documents créés, utilisateurs invités), ainsi que la durée et la profondeur des sessions. Chacun de ces éléments dit quelque chose sur la valeur réellement obtenue par le client.
Le recul de l'engagement révèle une relation qui se délite, même quand l'usage du produit paraît correct. Participation en baisse aux QBR, moindre réactivité face aux sollicitations du CSM, abandon des formations ou des webinars, désengagement de la communauté : autant de signes que le client a déjà un pied dehors. Quand les clients cessent d'échanger avec votre équipe, la relation se dégrade, quoi que disent les chiffres d'usage.
L'augmentation des tickets de support, surtout avec un sentiment négatif, signale une frustration croissante. Surveillez les pics de tickets après une période calme, les tickets escaladés ou courroucés, les problèmes récurrents qui montrent l'absence de résolution, et les tickets qui s'interrogent sur des concurrents ou des alternatives.
Le modèle de HubSpot classe à haut risque les comptes qui cumulent 5 tickets ou plus en 30 jours ET un NPS inférieur à 6. La combinaison du volume et du sentiment compte davantage que chacun pris séparément.
La baisse du sentiment et de la satisfaction se repère par la chute du NPS (en particulier un passage de 9 à 6, donc de promoteur à détracteur), des scores CSAT sous le seuil, un langage négatif dans les tickets de support et des réponses d'enquête exprimant de l'insatisfaction.
Wootric a constaté que les clients dont le NPS recule de 3 points ou plus d'un trimestre sur l'autre résilient quatre fois plus que la moyenne. De petites baisses de satisfaction annoncent de fortes hausses du risque de churn.
Les changements d'interlocuteur et de champion créent une vulnérabilité immédiate. Votre champion a quitté l'entreprise. Une réorganisation a supprimé l'équipe qui utilisait votre produit. Une nouvelle direction, qui ne connaît pas votre produit, est arrivée. Les e-mails de contact reviennent en erreur, parce que les personnes ne sont plus là.
Une relation avec un seul interlocuteur devient à haut risque dès que cette personne disparaît. Si une seule personne tient à votre produit, vous êtes à un licenciement de perdre le compte.
Les incidents de paiement et de facturation annoncent aussi bien le churn volontaire que le churn involontaire. Échecs de paiement, demandes de rétrogradation, demandes de délai de paiement, questions budgétaires ou inquiétudes sur le coût, cartes bancaires refusées : tous ces signaux sont corrélés à un churn proche.
Selon les données de Recurly, les clients ayant eu 2 échecs de paiement ou plus partent dans 60 % des cas, contre 5 % en moyenne. Les problèmes de paiement traduisent souvent des tensions financières ou un déclassement de votre produit dans les priorités.
Les signaux concurrentiels indiquent que le client compare activement les offres. Questions sur l'intégration avec des concurrents, demandes de comparaison, mentions de noms de concurrents, activité LinkedIn révélant un intérêt pour des alternatives : lorsque les clients commencent à étudier la concurrence, le compte à rebours est lancé. Ils construisent un dossier pour changer de solution.
Le calendrier du contrat et du renouvellement crée des fenêtres de risque naturelles, indépendamment de tout le reste. Le risque augmente 90 à 60 jours avant le renouvellement, à la fin des contrats annuels, après une hausse de prix et à l'approche des fins d'engagement. Le risque de churn s'accroît à mesure que les échéances de renouvellement approchent, tout simplement parce que les clients réévaluent alors la relation et les alternatives.
Modèles à règles : des seuils simples qui fonctionnent
Commencez par des modèles à règles basiques. Ils sont simples, transparents et étonnamment efficaces pour détecter la majorité du churn.

Définir des seuils de risque revient à fixer des critères clairs et précis, que chacun peut comprendre :
Risque élevé si l'UNE de ces conditions est remplie :
- L'usage a baissé de plus de 40 % d'un mois sur l'autre pendant 2 mois consécutifs ou plus
- Aucune connexion au cours des 30 derniers jours
- Score NPS inférieur à 5, ou en baisse de 4 points ou plus récemment
- Départ confirmé du champion
- Renouvellement dans 60 jours avec un score de santé inférieur à 60
Risque moyen si l'UNE de ces conditions est remplie :
- L'usage a baissé de 20 à 40 % d'un mois sur l'autre
- Moins de 5 connexions au cours des 30 derniers jours
- NPS entre 5 et 6, ou en baisse de 2 à 3 points
- 3 tickets de support ou plus au cours des 30 derniers jours
- Renouvellement dans 90 jours avec un score de santé compris entre 60 et 75
Ces règles sont parfaitement transparentes. Chaque membre de votre équipe comprend exactement pourquoi un client a été signalé, ce qui renforce la confiance dans le système.
Combiner plusieurs signaux améliore considérablement la précision. Les indicateurs isolés génèrent trop de faux positifs : beaucoup de clients en bonne santé ont un mois creux. Des signaux combinés sont bien plus fiables.
Par exemple, ne signalez un compte à haut risque que si 2 de ces conditions ou plus sont réunies : usage sous le seuil, score d'engagement faible, tickets de support en hausse et renouvellement dans les 90 jours. Cela réduit les faux positifs tout en gardant la sensibilité aux risques réels.
Les conditions de déclenchement déterminent quand et comment agir sur les prédictions. Alerte immédiate au CSM pour les comptes à haut risque de plus de 50 K$ d'ARR. Synthèse hebdomadaire pour les comptes à risque moyen. Revue mensuelle des comptes à faible risque où apparaissent des signaux. Campagnes d'intervention automatiques pour les comptes en tech-touch.
Chaque niveau de risque appelle une réponse différente. On ne peut pas traiter tous les signalements de la même façon.
La simplicité et la transparence sont en réalité des forces des modèles à règles, pas des faiblesses. Les CSM comprennent pourquoi les clients sont signalés. Ils peuvent valider eux-mêmes la logique. Ils font confiance aux alertes parce qu'elles ont du sens.
Les modèles de machine learning sont parfois plus précis, mais ils ressemblent souvent à des boîtes noires. Personne ne sait pourquoi un client a été signalé, ce qui rend les CSM sceptiques. Les modèles à règles inspirent confiance précisément parce qu'ils sont explicables.
Intercom a commencé avec une règle très simple : tout client ayant moins de 10 sessions en 30 jours et approchant de son renouvellement est à risque. C'est tout. Elle a détecté 65 % des départs réels, quasiment sans faux positifs. Cette simplicité a favorisé une adoption immédiate dans toute l'équipe CS.
Modèles de scoring : des facteurs pondérés pour une prédiction plus fine
Les modèles de scoring gagnent en finesse en pondérant plusieurs facteurs selon leur pouvoir prédictif.

La sélection des composantes identifie les facteurs qui comptent vraiment dans votre activité. Vous pouvez pondérer l'usage du produit à 30 %, le niveau d'engagement à 20 %, la santé du support à 15 %, la solidité de la relation à 15 %, la santé financière à 10 % et le délai avant renouvellement à 10 %.
Ces pondérations doivent refléter les facteurs qui, dans VOS données, sont historiquement le plus corrélés au churn, et non ceux d'une autre entreprise.
La méthode de pondération peut venir de l'intuition (l'avis d'experts, des responsables CS qui ont vu des centaines de départs), de l'analyse de régression (analyse statistique des schémas de churn passés) ou de tests itératifs (essayer différentes pondérations, mesurer la précision, affiner selon les résultats).
La plupart des entreprises commencent avec des pondérations intuitives, puis les affinent avec les données à mesure que leur historique de churn s'étoffe.
Le calcul du score combine les composantes pondérées en un seul score de santé :
Voici un exemple de client :
- Usage du produit : 40 sur 100, pondéré à 30 % = 12 points
- Engagement : 60 sur 100, pondéré à 20 % = 12 points
- Santé du support : 70 sur 100, pondéré à 15 % = 10,5 points
- Relation : 80 sur 100, pondéré à 15 % = 12 points
- Santé financière : 90 sur 100, pondéré à 10 % = 9 points
- Délai avant renouvellement : 30 sur 100, pondéré à 10 % = 3 points
Score de santé total : 58,5 sur 100, ce qui bascule en zone de risque élevé si votre seuil est fixé à 60.
La définition des seuils détermine les niveaux de risque. Vous pouvez retenir 80-100 pour les comptes sains (vert), 60-79 pour les comptes à risque (jaune) et moins de 60 pour les comptes à haut risque (rouge).
Ces seuils doivent être calibrés sur vos données historiques de churn. Si 80 % des clients perdus avaient un score inférieur à 60 dans les 90 jours précédents, ce seuil est cohérent. Si seulement 40 % étaient dans ce cas, il faut l'ajuster.
La validation et le réglage testent le modèle sur des données historiques pour vérifier qu'il fonctionne vraiment. Combien de clients perdus avaient été signalés à haut risque au préalable ? Combien de clients signalés à haut risque n'ont finalement pas résilié (faux positifs) ? Quel est le délai entre le signalement du risque et le churn effectif ? Le modèle fonctionne-t-il aussi bien dans les différents segments de clientèle ?
Totango a construit un modèle de scoring pondéré et l'a testé a posteriori sur 18 mois de données de churn. La précision initiale était de 71 %, ce qui n'est pas mauvais. Après avoir ajusté les pondérations et les seuils à partir de ce qu'ils avaient appris, ils ont atteint 82 % de précision, avec 75 jours d'avance en moyenne.
Approches de machine learning : détecter des tendances à grande échelle
Avec de gros volumes de données, les modèles de machine learning peuvent repérer des schémas qu'aucun humain ne verrait.

Le choix de l'algorithme dépend du volume de vos données, de vos capacités techniques et de vos exigences de précision :
La régression logistique est l'approche de machine learning la plus simple. Elle prédit la probabilité de churn à partir de plusieurs variables, reste explicable (elle montre quels facteurs comptent le plus), fonctionne bien avec des jeux de données plus petits (100 départs ou plus) et constitue un point de départ courant pour la prédiction du churn par machine learning.
Les arbres de décision et les forêts aléatoires créent une logique de branches à partir de combinaisons de variables. Ils gèrent bien les relations non linéaires et peuvent révéler des tendances inattendues (par exemple « les clients qui font X ET Y mais PAS Z ont un risque de churn multiplié par 10 »). Ils sont plus complexes, mais plus puissants que la régression simple.
Les réseaux de neurones détectent des schémas complexes dans de grands jeux de données. Ils exigent beaucoup de données (plus de 1 000 départs pour un entraînement correct), sont moins explicables mais potentiellement plus précis, et sont généralement surdimensionnés pour la plupart des éditeurs SaaS de taille moyenne.
Les méthodes de gradient boosting comme XGBoost et LightGBM représentent l'état de l'art pour les données structurées. Elles offrent une grande précision avec une explicabilité raisonnable, font référence pour la prédiction sérieuse du churn, mais demandent une vraie expertise en data science pour être bien mises en œuvre.
Les besoins en données d'entraînement déterminent ce qui est réellement faisable pour votre entreprise :
Le jeu de données minimal viable comprend plus de 100 départs historiques, plus de 12 mois de données clients et plus de 20 variables potentielles (usage, engagement, support, etc.).
Le jeu de données optimal comprend plus de 500 départs, plus de 24 mois de données, plus de 50 variables construites et plusieurs segments de clientèle pour une validation rigoureuse.
Si vous ne disposez pas d'assez d'historique de churn, le machine learning ne fera pas mieux que des modèles à règles plus simples. Il vous faut suffisamment de données pour l'entraînement.
Le feature engineering crée des variables prédictives qui capturent des tendances significatives :
Les variables de base incluent le niveau d'usage actuel, le score NPS, le nombre de jours avant renouvellement et le nombre de tickets de support.
Les variables construites sont plus élaborées : tendance d'usage (moyenne à 7 jours par rapport à 30 jours), dynamique d'engagement (en hausse ou en baisse dans le temps), usage relatif (par rapport à des clients similaires), étendue d'adoption des fonctionnalités, ancienneté de la relation et historique de paiement.
ProfitWell a constaté que les variables de tendance (vitesse d'évolution de l'usage) étaient trois fois plus prédictives que les variables ponctuelles (niveau d'usage actuel). La dynamique compte bien plus que l'état du moment.
L'entraînement du modèle suit un processus standard :
Séparez les données historiques en jeux d'entraînement (70 %), de validation (15 %) et de test (15 %). Entraînez le modèle sur le jeu d'entraînement. Réglez les hyperparamètres sur le jeu de validation. Évaluez la performance finale sur le jeu de test (des données que le modèle n'a jamais vues). Puis réentraînez-le sur l'ensemble des données une fois sa validité confirmée.
Cela évite le surapprentissage, c'est-à-dire un modèle qui mémorise les données d'entraînement mais se comporte mal sur de nouvelles données.
L'importance des variables montre ce qui pilote réellement les prédictions, donc où concentrer vos efforts d'intervention :
Un résultat type pourrait faire apparaître la tendance d'usage (variation sur 30 jours) à 28 % d'importance, le délai avant renouvellement à 18 %, le sentiment des tickets de support à 15 %, la baisse du score d'engagement à 12 %, le statut du champion à 10 %, les autres variables cumulant 17 %.
Cela montre quels facteurs comptent le plus dans votre activité et où concentrer vos efforts de rétention.
Performance du modèle : métriques de précision et optimisation
Un modèle n'est utile que s'il est précis et exploitable. Voici comment mesurer et améliorer sa performance.
Les métriques de précision mesurent différents aspects de la qualité de votre modèle :
La précision répond à cette question : parmi les clients signalés à risque, quel pourcentage a réellement résilié ? Une précision élevée (80 % et plus) signifie peu de fausses alertes. Une précision faible (40 %) signifie que les CSM perdent énormément de temps sur des clients qui ne partiront pas.
Le rappel répond à celle-ci : parmi les clients qui ont résilié, quel pourcentage avions-nous signalé à risque au préalable ? Un rappel élevé (85 % et plus) signifie que nous détectons la plupart des départs avant qu'ils ne se produisent. Un rappel faible (50 %) signifie que la moitié de nos départs sont de pures surprises.
Le score F1 équilibre précision et rappel grâce à leur moyenne harmonique. Il évite de truquer le système en n'optimisant qu'une seule métrique. Les bons modèles obtiennent des scores F1 supérieurs à 0,75.
Vrais et faux positifs impliquent un arbitrage qui demande du jugement business :
Les faux positifs (signalés à risque mais qui n'ont pas résilié) vous coûtent du temps de CSM consacré à des interventions inutiles. Mais il y a aussi un bénéfice : un contact proactif peut éviter un churn qui se serait produit sans cette intervention.
Les faux négatifs (clients perdus mais non signalés) vous font manquer l'occasion de sauver un client. Vous perdez du chiffre d'affaires sans même avoir tenté d'intervenir.
La plupart des entreprises optimisent le rappel (détecter les départs), quitte à avoir plus de faux positifs. Rater un départ de 100 K$ coûte bien plus cher qu'une heure de plus passée sur un client qui n'était pas vraiment à risque.
Les arbitrages d'optimisation demandent un réglage adapté à l'économie propre à votre activité :
Pour les comptes à forte valeur, optimisez le rappel. Vous voulez détecter tous les départs possibles, quitte à avoir des faux positifs. Le coût d'un oubli est trop élevé.
Pour les comptes à faible valeur, optimisez la précision. Vous ne pouvez pas vous permettre de gaspiller du temps de CSM sur de fausses alertes quand la valeur du compte ne justifie pas le coût de l'intervention.
Vous pouvez faire tourner deux modèles totalement différents, avec des seuils distincts selon les segments de clientèle.
Les tests A/B vérifient si les améliorations du modèle fonctionnent réellement en pratique :
Le groupe de contrôle reçoit les alertes de votre modèle actuel. Le groupe test reçoit celles d'un nouveau modèle que vous évaluez. Mesurez les taux de churn, les taux de réussite des sauvetages et l'effort de CSM requis dans les deux groupes.
Si le nouveau modèle réduit le churn dans le groupe test sans demander beaucoup plus de temps aux CSM, déployez-le largement. Sinon, cherchez à comprendre pourquoi avant de changer quoi que ce soit.
L'amélioration continue maintient la précision des modèles à mesure que votre activité évolue :
Les revues mensuelles doivent examiner les comptes signalés qui n'ont pas résilié (faux positifs : pourquoi ont-ils été signalés ?) et les départs qui n'avaient pas été signalés (faux négatifs : quels signaux avons-nous manqués ?).
Les actions trimestrielles incluent le réentraînement du modèle avec les nouvelles données, le test de nouvelles variables et de nouveaux indicateurs, et l'ajustement des seuils si les tendances ont changé.
Les actions annuelles comprennent une refonte complète du modèle et l'examen de l'opportunité de passer à des approches plus poussées.
Les schémas de churn évoluent avec le temps, à mesure que votre produit change, que votre base clients gagne en maturité et que le marché bouge. Votre modèle doit évoluer avec eux.
Passer de la prédiction à l'action : des scores aux interventions
Un modèle ne crée de la valeur que s'il déclenche des interventions. Voici comment transformer les prédictions en comptes sauvés.

L'intégration aux workflows place les prédictions au cœur du travail quotidien, là où les équipes opèrent :
L'intégration CRM affiche un champ de score de santé sur chaque fiche client. Les signalements à risque déclenchent des workflows automatisés. Le niveau de risque détermine automatiquement l'affectation du CSM et la priorité.
La visibilité par dashboard donne aux CSM des dashboards qui présentent les comptes à risque triés par ARR. Des rapports de risque hebdomadaires sont envoyés à la direction CS. Les indicateurs de tendance du risque montrent les comptes qui passent du vert au jaune puis au rouge, pour repérer tôt les situations qui se dégradent.
La génération d'alertes prévient les bonnes personnes au bon moment :
Des alertes graduées peuvent inclure une notification immédiate au CSM et une escalade au manager pour les comptes à haut risque et à forte valeur (plus de 50 K$ d'ARR). Les comptes à haut risque et à valeur moyenne (de 10 K$ à 50 K$) figurent dans les synthèses quotidiennes des CSM. Les comptes à risque moyen reçoivent des listes de revue hebdomadaires. Les comptes à faible risque présentant des signaux émergents font l'objet d'un suivi mensuel.
La fatigue d'alertes est bien réelle. Si vous envoyez trop d'alertes, les CSM les ignorent toutes. Segmentez par priorité pour que les alertes critiques retiennent vraiment l'attention.
Les dashboards CSM proposent des vues exploitables qui rendent la priorisation évidente :
Un bon dashboard « Mes comptes à risque » présente les comptes triés par ARR (valeur la plus élevée en premier), le score de risque et sa tendance (en amélioration ou en baisse), les principaux facteurs de risque (usage en baisse, problèmes de support, renouvellement proche), la date du dernier point de contact et la prochaine action suggérée.
Les CSM peuvent ainsi organiser leur journée très facilement : on commence par les comptes à plus forte valeur et au risque le plus élevé, là où l'impact potentiel est le plus grand.
Le déclenchement des interventions automatise les réponses adaptées :
Voici des exemples de scénarios automatisés : un compte à risque moyen reçoit un e-mail de bonnes pratiques et d'astuces d'usage, un compte à haut risque déclenche un appel de contact programmé par le CSM, la détection du départ d'un champion lance une campagne de multi-threading de la relation, la détection d'une baisse d'usage déclenche une séquence de réonboarding.
L'automatisation garantit une réponse homogène, même quand les CSM sont complètement débordés ou en congé.
Le suivi des résultats mesure si les interventions fonctionnent vraiment :
Pour chaque compte à risque, suivez le score de risque au moment du signalement, les interventions tentées, la réaction du client à ces interventions, le résultat final (conservé, perdu, voire en expansion) et le nombre de jours entre le signalement et la résolution.
Ces données alimentent l'amélioration du modèle. Si les clients signalés pour « faible engagement » répondent systématiquement bien aux invitations à des webinars, vous avez trouvé une tactique d'intervention efficace.
L'affinage du modèle à partir des résultats réels pose des questions essentielles :
Quels facteurs de risque ont réagi à l'intervention ? Lesquels étaient en pratique impossibles à prévenir ? Quel délai d'avance est optimal (trop tôt, ce sont des faux positifs ; trop tard, vous ne pouvez plus sauver le compte) ? Les différents segments de clientèle demandent-ils des modèles totalement distincts ?
Zendesk a constaté que les clients SMB nécessitaient 90 jours d'avance, contre seulement 45 jours pour les clients grands comptes. L'éditeur a construit des modèles propres à chaque segment, avec des seuils différents, et amélioré la précision globale de 15 % par rapport à l'approche unique.
Questions fréquentes
Qu'est-ce qu'un modèle de prédiction du churn ? C'est un système qui analyse les tendances des données clients, comme l'usage, l'engagement, les tickets de support et le calendrier de renouvellement, pour estimer la probabilité de résiliation de chaque compte. Les bons modèles signalent le risque 60 à 90 jours à l'avance, afin que votre équipe ait le temps d'intervenir.
Quelle est la précision des modèles de prédiction du churn ? Elle dépend de l'approche. Les modèles simples à règles détectent 60 à 70 % du churn, les modèles de scoring pondéré atteignent 75 à 80 %, et les méthodes de machine learning comme le gradient boosting peuvent atteindre 85 à 90 % avec suffisamment de données historiques.
Quelles données prédisent le mieux le churn ? La baisse d'usage est le signal le plus fort, surtout un recul de 30 % ou plus d'un mois sur l'autre. Les variables de tendance (l'évolution de l'usage) valent mieux que les instantanés ponctuels, et la combinaison de signaux comme un faible engagement et des tickets de support en hausse réduit les faux positifs.
Ai-je besoin de machine learning pour prédire le churn ? Non. Commencez par un modèle à règles transparent, que chacun peut comprendre et auquel chacun peut se fier. Passez ensuite au scoring pondéré, puis au machine learning, uniquement lorsque vous disposez de 100 départs historiques ou plus et d'une maturité data suffisante pour un entraînement fiable.
Avec quelle avance la prédiction du churn peut-elle alerter ? Les meilleurs modèles donnent 60 à 90 jours d'avance. Une intervention avant le seuil des 60 jours réussit environ trois fois plus souvent qu'une action à 30 jours ou moins, car le client n'a pas encore arrêté sa décision de partir.
Prêt à construire une prédiction du churn qui renforce la rétention ? Découvrez comment mettre en place des systèmes de suivi de la santé client, construire des systèmes d'alerte précoce, élaborer des stratégies de sauvetage pour les comptes à risque et instaurer des processus d'analyse du churn qui améliorent continuellement vos modèles.
Ressources associées :
Senior Operations & Growth Strategist
On this page
- Objectifs d'un modèle de prédiction : ce que fait un bon modèle
- Indicateurs prédictifs : les signaux qui annoncent le churn
- Modèles à règles : des seuils simples qui fonctionnent
- Modèles de scoring : des facteurs pondérés pour une prédiction plus fine
- Approches de machine learning : détecter des tendances à grande échelle
- Performance du modèle : métriques de précision et optimisation
- Passer de la prédiction à l'action : des scores aux interventions
- Questions fréquentes