Cadre de A/B testing : une expérimentation systématique pour la croissance e-commerce
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
La plupart des décisions e-commerce reposent sur l'intuition, l'expérience passée ou ce que font les concurrents. L'A/B testing change la donne en transformant des hypothèses en décisions étayées par les données. Entre une boutique qui teste de façon systématique et une autre qui ne le fait pas, l'écart peut atteindre 20 à 30 % de conversion en plus sur la durée.
Les boutiques qui gagnent en e-commerce ne dépensent pas forcément davantage en marketing et n'ont pas nécessairement de meilleurs produits. Elles testent sans relâche, tirent des enseignements de chaque expérience et cumulent de petites améliorations jusqu'à obtenir une vraie croissance. Ce cadre vous montre comment bâtir cette capacité grâce à une optimisation du taux de conversion méthodique.
Pourquoi l'A/B testing compte en e-commerce
Chaque modification apportée à votre boutique comporte un risque. Un nouveau design de checkout peut augmenter les conversions de 15 % ou les faire chuter de 20 %. Sans test, vous jouez à pile ou face. Avec des tests, vous prenez des paris éclairés, appuyés sur des données. Le coût des changements non testés est bien réel. Une boutique e-commerce de taille moyenne qui réalise 500 000 \(de ventes par mois peut perdre 50 000 à 100 000\) en un seul mois à cause d'une refonte bien intentionnée mais non validée. Les tests protègent contre ces pertes tout en faisant ressortir méthodiquement les gains.
Gains typiques d'une démarche de test systématique :
- Optimisation de la page d'accueil et des pages catégorie : 5 à 15 % de conversion en plus
- Améliorations de la page produit : 10 à 25 % de hausse du taux d'ajout au panier
- Affinage du parcours de checkout : 8 à 20 % d'amélioration du taux de finalisation
- Tests de prix et de promotions : 3 à 12 % de revenu par visiteur en plus
- Tests d'e-mails et de messages : 15 à 40 % de gain sur les taux d'ouverture et de clic
Le ROI d'un programme de test mature se situe généralement entre 5:1 et 20:1. Pour chaque dollar investi dans l'infrastructure et les ressources de test, les boutiques dégagent 5 à 20 $ de revenu supplémentaire. Le mot clé est « mature » : cela ne se fait pas du jour au lendemain.
Ce qui distingue les programmes de test les plus performants :
- Cadence de test : au minimum 8 à 12 tests par trimestre
- Taux de réussite : 20 à 30 % des tests produisent des améliorations statistiquement significatives
- Rapidité de mise en œuvre : les variantes gagnantes sont déployées en 1 à 2 semaines
- Documentation des enseignements : chaque test est documenté, qu'il gagne ou qu'il perde
- Adhésion transverse : le test est intégré au développement produit
La vraie valeur ne tient pas aux victoires de chaque test. Elle réside dans la connaissance accumulée de ce qui fonctionne pour vos clients, expérience après expérience. Cette compréhension cumulative devient un avantage concurrentiel difficile à copier. Suivre les bons indicateurs et KPI e-commerce vous garantit de mesurer ce qui compte le plus.
Fondements statistiques et significativité
Comprendre les statistiques qui sous-tendent l'A/B testing n'a rien d'académique : cela évite des erreurs coûteuses et vous aide à faire confiance à vos résultats. Nul besoin d'un doctorat, mais les fondamentaux sont indispensables. Structure de l'hypothèse : Tout test commence par une hypothèse qui contient trois éléments : le changement que vous apportez, la métrique que vous comptez faire bouger et l'ampleur attendue. « Remplacer le texte du bouton CTA « Acheter maintenant » par « Ajouter au panier » augmentera le taux d'ajout au panier d'au moins 10 %. » L'hypothèse nulle suppose qu'il n'existe aucune différence entre les variantes. L'hypothèse alternative affirme qu'une différence existe. Votre test rejette soit l'hypothèse nulle (il trouve une différence significative), soit ne la rejette pas (aucune différence concluante). Calcul de la taille d'échantillon : La taille d'échantillon détermine la durée du test. La formule repose sur quatre données :
- Taux de conversion de référence (performance actuelle)
- Effet minimal détectable (plus petite amélioration qui vaut la peine d'être détectée)
- Puissance statistique (généralement 80 %, soit 80 % de chances de détecter de vrais effets)
- Seuil de significativité (généralement 95 %, soit 5 % de risque de faux positifs)
Pour une page de checkout dont le taux de conversion de référence est de 2 %, détecter une amélioration relative de 10 % (de 2,0 % à 2,2 %) avec 95 % de confiance exige environ 38 000 visiteurs par variante, soit 76 000 visiteurs au total.
Plus le taux de référence est élevé, moins il faut de trafic. Une page d'accueil dont le taux d'engagement est de 15 % n'a besoin que de 4 800 visiteurs par variante pour détecter un gain de 10 %. C'est pourquoi tester des pages à fort trafic mais à faible conversion demande souvent de la patience.
Les niveaux de confiance expliqués : Une confiance de 95 % signifie que, si vous répétiez ce test 100 fois, vous observeriez 95 fois des résultats similaires. Les 5 % restants sont des faux positifs : vous avez détecté une différence qui n'existe pas réellement.
Certaines équipes retiennent 90 % de confiance pour itérer rapidement et 99 % pour les changements majeurs, comme une refonte des prix ou du checkout. L'arbitrage se joue entre vitesse et certitude. Une confiance plus faible donne des réponses plus vite, mais accepte davantage de faux positifs.
Pièges statistiques courants :
Le problème du « peeking » : consulter les résultats avant d'avoir atteint la taille d'échantillon fait exploser le taux de faux positifs. Regarder les résultats chaque jour alors qu'il faut 30 jours pour atteindre l'échantillon peut faire passer les faux positifs de 5 % à 20-25 %. Utilisez des calculateurs de test séquentiel si vous devez suivre l'avancement.
Les tests multiples : lancer cinq tests en parallèle, chacun avec 95 % de confiance, revient à avoir environ 23 % de chances qu'au moins un affiche un faux positif. Ajustez les seuils de significativité (correction de Bonferroni) ou limitez le nombre de tests simultanés.
Le forage de segments : constater que votre test a « gagné » auprès des utilisateurs mobiles Android en Californie après avoir perdu globalement est presque toujours trompeur. Définissez les segments à l'avance dans votre hypothèse, ou traitez les segments identifiés après coup comme des idées de nouveaux tests.
Approches bayésienne et fréquentiste : La plupart des outils s'appuient sur les statistiques fréquentistes : tailles d'échantillon fixes et résultats binaires (significatif ou non). Les approches bayésiennes fournissent des distributions de probabilité et permettent un suivi continu sans pénalité liée au « peeking ».
Le test bayésien convient mieux aux entreprises qui doivent décider plus vite et peuvent se contenter d'indications probabilistes (« cette variante a 78 % de chances d'être meilleure »). Le test fréquentiste convient mieux aux décisions à fort enjeu qui exigent une réponse nette, oui ou non, avec des taux d'erreur maîtrisés.
Pour la plupart des tests e-commerce, les approches fréquentistes suffisent. Réservez les méthodes bayésiennes aux programmes avancés qui mènent plus de 20 tests par trimestre.
Cadre de priorisation des tests
Vous pourriez tester des centaines d'éléments. La question est de savoir par où commencer. Les méthodes de priorisation évitent les tests au hasard et maximisent le ROI. Matrice impact / effort : Placez les tests potentiels sur deux axes : Impact élevé, effort faible (à faire en premier) :
- Modifier le texte ou la couleur du bouton CTA
- Ajuster la taille ou le nombre des images produit
- Ajouter des badges de confiance près du checkout
- Reformuler les messages sur la livraison
- Tester des variantes d'objets d'e-mail
Impact élevé, effort élevé (à planifier avec soin) :
- Refonte complète du checkout
- Nouvelle mise en page de la page produit
- Restructuration de la navigation
- Mise en place d'un moteur de personnalisation
- Refonte de l'expérience de l'application mobile
Impact faible, effort faible (à faire si les ressources le permettent) :
- Changements de texte des liens du pied de page
- Retouches de la mise en page de la page « À propos »
- Petits ajustements de rédaction
- Mises à jour du style des icônes
Impact faible, effort élevé (à éviter) :
- Système d'illustrations sur mesure
- Charte graphique très détaillée
- Systèmes d'animation complexes
Besoins en trafic et délai avant significativité : Calculez la durée de chaque test à partir du trafic de la page et des taux de conversion de référence. Une page produit qui reçoit 10 000 visiteurs par mois et teste une métrique de référence de 15 % a besoin d'environ 2 à 3 semaines pour détecter un gain de 10 %. Une page de checkout avec 1 000 visiteurs par mois peut en demander 2 à 3 mois.
Au début de votre programme, privilégiez les tests qui atteignent vite la significativité. Vous créez ainsi de l'élan et vous ralliez la direction à votre démarche. À mesure que le programme gagne en maturité, attaquez-vous aux tests plus longs sur les pages à faible trafic.
Saisonnalité : Évitez de tester pendant les périodes de pointe, sauf si votre trafic est énorme. Le Black Friday n'est pas le moment de tester un nouveau parcours de checkout : les flux de trafic, le comportement des clients et le contexte promotionnel diffèrent radicalement des périodes ordinaires.
Menez vos tests pendant des périodes « normales », représentatives du comportement habituel des clients. Si votre activité est très saisonnière (vêtements d'été, décorations de fêtes), il peut être nécessaire de tester au sein de chaque saison et de revalider sur d'autres périodes.
Dépendances et stratégie de tests séquentiels : Certains tests doivent précéder les autres. Testez le message de la page d'accueil avant les pages produit sur lesquelles arrivent les visiteurs. Optimisez votre parcours de checkout avant de tester la conception de chacun de ses champs de formulaire.
Construisez une feuille de route de tests structurée ainsi :
- Tests de fondation (pages à fort trafic et à fort impact)
- Tests du funnel de conversion (séquence page d'accueil → produit → panier → checkout)
- Tests d'affinage (éléments individuels au sein de pages déjà optimisées)
- Tests de personnalisation (variantes propres à chaque segment)
Cette approche séquentielle garantit que chaque test s'appuie sur des enseignements validés, au lieu d'optimiser un socle défaillant.
Méthodologie et conception des tests
La façon de structurer un test compte autant que ce que vous testez. Une méthodologie défaillante invalide les résultats, quelle que soit la rigueur de vos statistiques. Variable unique ou multivariable : Les A/B tests comparent deux versions en ne changeant qu'un élément. Les tests A/B/n comparent plusieurs variantes (A/B/C/D). Les tests multivariés combinent plusieurs changements pour identifier les interactions entre les éléments. Commencez par des tests à variable unique. Ils sont plus simples à interpréter et demandent moins de trafic. Un test de page produit qui ne modifie que l'image principale offre un enseignement clair. Un test multivarié qui change simultanément l'image, le titre, les puces et le CTA exige 10 à 20 fois plus de trafic et brouille les enseignements.
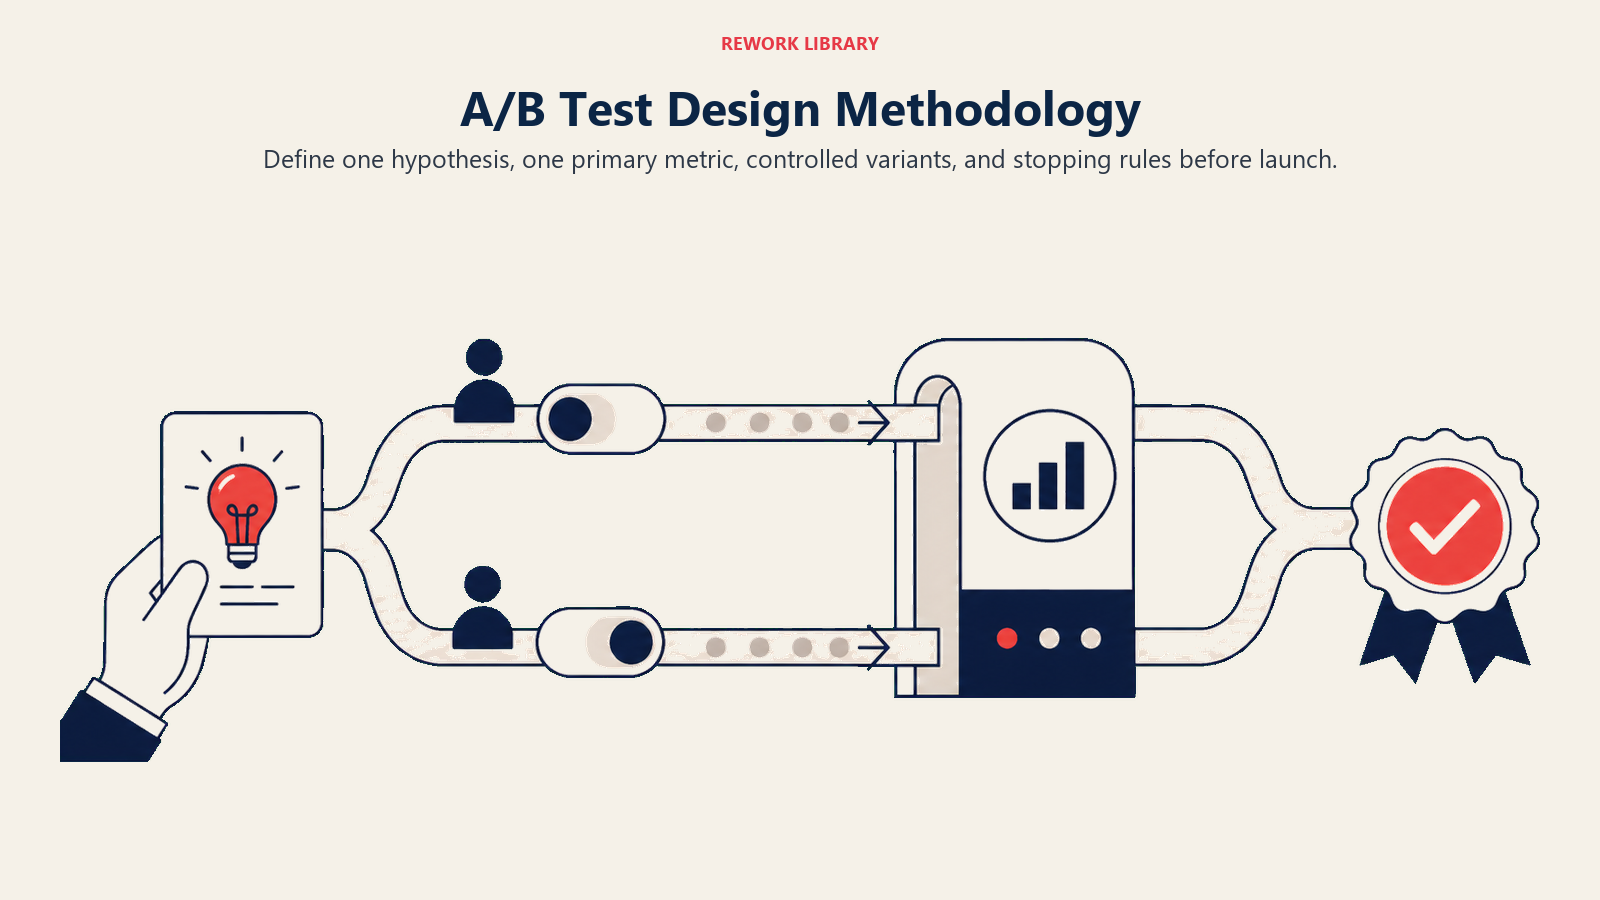
Réservez les tests multivariés aux programmes matures qui disposent d'un trafic substantiel (500 000 visiteurs mensuels et plus) et dont vous avez précisément besoin de comprendre les interactions entre éléments.
Conception du groupe de contrôle : Votre contrôle doit représenter l'expérience actuelle, pas une version idéalisée. Si votre checkout actuel compte six champs de formulaire, ne corrigez pas les bugs et n'améliorez pas les textes dans le contrôle pendant que vous testez une variante à cinq champs. Corrigez les bugs dans les deux variantes ou dans aucune.
Dans la mesure du possible, gardez le même contrôle d'un test à l'autre. Si vous avez validé une nouvelle page d'accueil en janvier, utilisez-la comme contrôle pour les tests de février. Vous obtenez ainsi une base de comparaison stable et des améliorations qui se cumulent.
Répartition de l'échantillon et allocation du trafic : Une répartition 50/50 convient à la plupart des tests. Utilisez parfois 90/10 ou 80/20 pour tester des changements potentiellement risqués : vous limitez l'exposition au risque tout en continuant à collecter des données.
Le trafic doit être réparti de façon aléatoire, et non selon le jour de la semaine, l'heure ou les caractéristiques de l'utilisateur (sauf si vous testez précisément la personnalisation). L'affectation aléatoire garantit que les variantes ne diffèrent que par l'élément testé, et non par la composition sous-jacente de la clientèle.
Groupes témoins pour l'impact à long terme : Pour les changements majeurs, envisagez un groupe témoin permanent qui conserve l'ancienne expérience. Ce groupe de 5 à 10 % permet de mesurer des effets à long terme (les clients qui ont vécu le nouveau checkout reviennent-ils plus souvent ? Dépensent-ils davantage dans la durée ?) que les tests de courte durée ne captent pas.
Ces groupes témoins sont particulièrement utiles pour les changements structurants, comme une refonte de la navigation, un changement de stratégie de prix ou le lancement d'un programme de fidélité. Passez-vous-en pour les tests tactiques, comme la couleur d'un bouton ou des variantes de titre. Comprendre la valeur vie client permet de juger si les changements améliorent la rentabilité à long terme, au-delà des gains de conversion initiaux.
Durée des tests et variations saisonnières : Menez chaque test sur au moins une semaine complète pour capter les différences de comportement entre jours de semaine et week-ends. Deux semaines, c'est mieux : vous captez d'éventuels effets liés aux dates de paie. Allongez la durée pour les pages à faible trafic ou lorsque vous mesurez des métriques fines.
Arrêtez les tests une fois la taille d'échantillon atteinte, et non au moment où vous voyez un résultat qui vous plaît. Prolongez-les si des facteurs externes interviennent (panne du site, pic médiatique inattendu, événement concurrent majeur).
Domaines clés à tester
Certains domaines offrent régulièrement un retour disproportionné sur les tests. Concentrez-y vos premiers efforts. Optimisation de la page produit : Les pages produit sont des moteurs de conversion. De petites améliorations se cumulent sur des centaines, voire des milliers de SKU. Priorités de test :
- Nombre et disposition des images principales (une grande image, plusieurs angles, mise en situation)
- Zoom sur l'image et fonctionnalités de la galerie
- Structure et longueur de la description produit
- Nombre, ordre et mise en forme des puces
- Emplacement et visibilité des avis
- Texte, couleur et position du bouton CTA
- Emplacement des messages sur la livraison et les retours
- Interface de sélection de la taille et des variantes
Un distributeur de mode a augmenté ses conversions de 18 % en testant des images en situation en position principale contre des photos du produit seul. Une boutique d'articles pour la maison a gagné 12 % sur son taux d'ajout au panier en plaçant les informations de livraison dans la partie visible sans défilement. Ces changements ne coûtent rien à mettre en œuvre, mais il faut des tests pour les valider.
Découvrez les approches méthodiques d'optimisation de la page produit.
Variantes du parcours de checkout : L'abandon au checkout atteint en moyenne 70 % en e-commerce. Chaque point de pourcentage récupéré se traduit directement en revenu.
Tests à fort impact :
- Checkout en une page ou en plusieurs étapes
- Achat en tant qu'invité ou création de compte obligatoire
- Nombre et ordre des champs du formulaire
- Indicateurs de progression et intitulés des étapes
- Affichage et ordre des moyens de paiement
- Présentation des options de livraison
- Emplacement des badges de confiance
- Visibilité du récapitulatif du panier
Un éditeur de logiciels a réduit son abandon au checkout de 22 % en passant de trois étapes à un parcours sur une seule page. Un distributeur de vêtements a obtenu le résultat inverse : un parcours clair en plusieurs étapes a surpassé la page unique de 8 %. Ce sont vos clients qui désignent le gagnant. L'optimisation du parcours de checkout demande des tests systématiques, pas des bonnes pratiques toutes faites.
Tests de prix et de promotions : Les tests de prix sont à haut risque et à fort potentiel. Une variation de prix de 5 % peut faire bouger le revenu de 15 à 20 % selon votre élasticité.
Approches de test :
- Variations de prix pour les nouveaux produits
- Présentation des remises (en % ou en montant)
- Seuils de livraison gratuite
- Prix et configurations des bundles
- Structures de prix par paliers
- Messages d'urgence promotionnels
- Affichage du prix de référence
Testez les prix sur des segments contrôlés avant tout déploiement à l'échelle de l'entreprise. Un fournisseur B2B a testé des hausses de 8 %, 10 % et 12 % sur les seuls nouveaux clients, et a constaté que 10 % était le bon point d'équilibre : un gain de revenu significatif sans effet sur la conversion. Le test lui a évité de laisser filer de la marge ou de se placer hors de prix.
Explorez l'élaboration méthodique de votre stratégie d'optimisation des prix.
Messages et propositions de valeur : La façon dont vous décrivez votre valeur détermine qui convertit. De petits changements de message résonnent différemment selon les segments.
Variantes à tester :
- Angle du titre principal (caractéristiques du produit, bénéfices client ou résultats émotionnels)
- Preuves à l'appui du sous-titre
- Emplacement de la proposition de valeur dans la partie visible sans défilement
- Formules de positionnement des pages catégorie
- Objets d'e-mail et texte d'aperçu
- Texte des annonces et cohérence du message avec la landing page
Une entreprise SaaS a comparé « Gagnez 10 heures par semaine » et « Automatisez vos tâches répétitives » : le message centré sur le gain de temps a converti 23 % mieux. Une marque de bien-être a constaté que le message axé sur un résultat émotionnel (« Sentez-vous plein d'énergie chaque matin ») l'emportait de 16 % sur les bénéfices fonctionnels (« Contient 500 mg de vitamine B12 »).
Tests de navigation et d'interface : La navigation détermine si les clients trouvent les produits. Les schémas d'interface déterminent si l'expérience semble intuitive ou frustrante.
Priorités de test :
- Méga-menu ou menu déroulant classique
- Visibilité et fonctionnalités de la barre de recherche
- Organisation et nom des catégories
- Disponibilité des options de filtre et de tri
- Structure du menu mobile
- Navigation fixe ou défilante
- Mise en place d'un fil d'Ariane
Un distributeur d'articles de plein air a augmenté la découverte de produits de 31 % en testant une navigation par activité (« Camping », « Randonnée », « Escalade ») contre une navigation par type de produit (« Tentes », « Chaussures », « Sacs à dos »). Les représentations mentales des clients comptent plus que le classement interne des produits.
Tests spécifiques au trafic et aux canaux : Chaque canal amène des clients avec une intention différente. Ce qui marche pour la recherche payante peut échouer sur les réseaux sociaux organiques.
Tests propres à chaque canal :
- Variantes de landing page pour le trafic payant
- Structures d'e-mails promotionnels
- Éléments de preuve sociale pour le trafic froid
- Expériences destinées aux clients fidèles ou aux nouveaux clients
- Mises en page et parcours spécifiques au mobile
Une marque de décoration a constaté que le trafic social convertissait 43 % mieux sur des pages produit très visuelles et avec peu de texte, tandis que le trafic issu de la recherche préférait les descriptions et spécifications détaillées. Les expériences uniques pour tous fonctionnent moins bien que les approches sur mesure. Une segmentation client efficace vous aide à adapter les expériences selon les comportements et les préférences.
Outils et stack technologique
Le bon choix d'outils équilibre fonctionnalités, facilité d'usage et coût. Votre premier outil ne sera pas le dernier : les programmes matures passent à des plateformes plus élaborées.
Plateformes spécialisées d'A/B testing :
Optimizely (grandes entreprises, 50 000 à 300 000 $ et plus par an) : Plateforme d'expérimentation complète avec éditeur visuel, tests multivariés, moteur de personnalisation et moteur statistique robuste. Idéale pour les grands distributeurs dotés d'équipes d'optimisation dédiées.
VWO (marché intermédiaire, 1 000 à 10 000 $ et plus par mois) : Éditeur visuel, cartes de chaleur, enregistrements de sessions et enquêtes, en plus des tests. Un bon équilibre entre fonctionnalités et coût pour les boutiques en croissance qui mènent 10 à 20 tests par an.
Convert (petites entreprises, 700 à 2 000 $ et plus par mois) : Plateforme légère centrée sur l'essentiel du test, avec conformité à la protection des données intégrée. Convient bien aux boutiques qui démarrent un programme de test systématique.
Google Optimize (abandonné en 2023) : Outil gratuit intégré à Google Analytics, aujourd'hui arrêté. Il illustre le risque des outils gratuits : ils disparaissent. Prévoyez un budget pour une vraie infrastructure de test.
Fonctionnalités natives des plateformes :
Shopify : des expérimentations de thème sont disponibles sur Shopify Plus (2 000 $ et plus par mois) pour tester la page d'accueil et les templates. Elles se limitent aux changements au niveau du thème, pas aux éléments individuels.
WooCommerce : nécessite des extensions tierces comme Nelio A/B Testing (200 à 400 $ par an) ou l'intégration de plateformes externes.
BigCommerce : partenaire d'Optimizely et de Google Optimize (lorsqu'il était actif). Aucune capacité de test native.
Magento : intégration d'Adobe Target pour Adobe Commerce Cloud (30 000 $ et plus par an). Mise en place complexe qui mobilise des ressources de développement.
Intégration avec l'analytique : Votre outil de test doit partager ses données avec votre plateforme d'analytique. Suivez les micro-conversions (ajout au panier, ajout à une liste d'envies, inscription à la newsletter) et les macro-conversions (achats, revenu) dans les deux systèmes.
Mettez en place une infrastructure d'analytique et de suivi solide avant de lancer des tests. On ne peut pas mesurer ce que l'on ne suit pas.
Calculateurs statistiques et outils de validation : Utilisez des calculateurs externes pour valider les résultats de votre outil, surtout pour les décisions critiques :
- Le calculateur de test A/B d'Evan Miller (gratuit et fiable)
- Le calculateur de taille d'échantillon d'Optimizely
- Le calculateur de durée de test A/B de VWO
- Le calculateur de confiance d'Adobe
Recoupez les résultats significatifs avec un second calcul. Les outils se trompent parfois, surtout avec de petits échantillons ou des taux de référence inhabituels.
Besoins en tableaux de bord et en reporting : Construisez des dashboards qui suivent :
- Les tests en cours et le temps restant avant leur terme
- Les résultats des tests terminés et l'état de leur mise en œuvre
- Le taux de réussite et le gain moyen par test gagnant
- Le revenu supplémentaire total généré par le programme de test
- Le coût par test et les calculs de ROI
Partagez des synthèses mensuelles avec les parties prenantes. La transparence fait naître le soutien et les ressources nécessaires pour étendre les tests.
Gestion des balises : Utilisez Google Tag Manager, Adobe Launch ou des outils similaires pour déployer les variantes de test sans mobiliser les développeurs à chaque changement. Cela peut faire passer la cadence de 2-3 tests par trimestre à 10-15 tests.
La gestion des balises permet aussi un retour arrière rapide si les tests provoquent des problèmes techniques. Un retrait en un clic vaut mieux qu'un déploiement d'urgence par les développeurs.
Bonnes pratiques de mise en œuvre
L'exécution détermine si votre test, conçu avec soin, produit des résultats valides ou des données inutilisables. Définir des métriques de succès claires : Chaque test a besoin d'une seule métrique principale. Ajoutez des métriques secondaires pour le contexte, mais ne sélectionnez pas le gagnant selon la métrique qui vous arrange.
Exemples de métriques principales :
- Tests de page produit : taux d'ajout au panier
- Tests de checkout : taux de finalisation
- Tests de page d'accueil : taux de clic vers la page produit
- Tests de prix : revenu par visiteur (et non le seul taux de conversion)
Les métriques secondaires servent de garde-fous. Une variante de page produit qui augmente l'ajout au panier de 15 % mais réduit les achats réels de 8 % est perdante, pas gagnante. C'est l'ensemble du funnel qui compte.
Établir la base de référence et l'effet minimal détectable : Faites tourner votre site pendant 1 à 2 semaines en mesurant la performance actuelle avant de tester. Cette base de référence alimente les calculs de taille d'échantillon et donne du contexte aux résultats.
Définissez votre effet minimal détectable (MDE), c'est-à-dire la plus petite amélioration qui vaut la peine d'être mise en œuvre. Pour les changements très coûteux, il faudra peut-être un gain de 10 à 15 % pour justifier les coûts de développement. Pour les changements peu coûteux, un gain de 3 à 5 % mérite d'être capté.
Le MDE influe sur la taille d'échantillon. Détecter des gains de 5 % exige 4 fois plus de trafic que détecter des gains de 10 %. Trouvez l'équilibre entre ambition statistique et délais réalistes.
Processus de QA et de validation : Avant de lancer les tests :
- Chargez les deux variantes dans plusieurs navigateurs (Chrome, Safari, Firefox, Edge)
- Testez sur des appareils mobiles (iOS Safari, Android Chrome)
- Vérifiez que le suivi se déclenche correctement dans l'outil d'analytique
- Contrôlez l'impact des scripts de test sur la vitesse des pages
- Confirmez que les variantes s'affichent correctement sur plusieurs tailles d'écran
- Testez l'envoi des formulaires et la finalisation des transactions
Une seule heure de QA évite des tests invalides qui gaspillent des semaines de trafic. Un distributeur de produits électroniques a mené un test de checkout pendant trois semaines avant de découvrir que la variante cassait Apple Pay, ce qui invalidait tous les résultats mobiles. Veillez à valider la vitesse et les performances du site pour le groupe de contrôle comme pour la variante.
Points d'attention par segment : Les effets d'un test varient souvent selon le segment. Prévoyez l'analyse par segment à l'avance :
- Type d'appareil (mobile, ordinateur ou tablette)
- Source de trafic (organique, payant, e-mail, réseaux sociaux)
- Type de client (nouveau ou fidèle)
- Région géographique
- Catégorie de produit
Définissez à l'avance 2 à 3 segments critiques. L'analyse de segments après coup sert à générer des hypothèses, pas à les valider.
Compatibilité des appareils et des navigateurs : Les variantes doivent fonctionner à l'identique sur tous les appareils. Une galerie produit qui fonctionne à merveille sur ordinateur mais qui est cassée sur mobile invalide les résultats.
Portez une attention particulière à :
- Les interactions tactiles ou au clic
- Les états au survol (inexistants sur mobile)
- Les points de rupture du responsive design
- Les particularités CSS ou JavaScript propres à chaque navigateur
- La compatibilité des moyens de paiement (Apple Pay, Google Pay, PayPal)
Tests mobile et ordinateur : Le comportement sur mobile diffère fondamentalement de celui sur ordinateur. L'attention est plus courte, les schémas d'interaction diffèrent et le contexte varie.
Envisagez des tests distincts pour le mobile et l'ordinateur plutôt que de supposer qu'une même expérience convient aux deux. Un distributeur de meubles a constaté que les pages produit très axées sur l'ambiance l'emportaient sur mobile (mode exploration), tandis que les pages riches en caractéristiques techniques gagnaient sur ordinateur (mode recherche).
Analyser les résultats et définir les actions
Obtenir des résultats est une chose. Les interpréter correctement et agir en conséquence en est une autre. Lire les résultats statistiques : Votre outil de test fournit plusieurs chiffres clés : Taux de conversion : un contrôle à 2,3 % et une variante à 2,6 % représentent une amélioration relative de 13 % (0,3 / 2,3 = 13 %). Intervalle de confiance : « IC à 95 % : +5 % à +22 % » signifie que vous êtes confiant à 95 % que le vrai gain se situe entre 5 % et 22 %. Des intervalles larges indiquent qu'il vous faut plus de données.
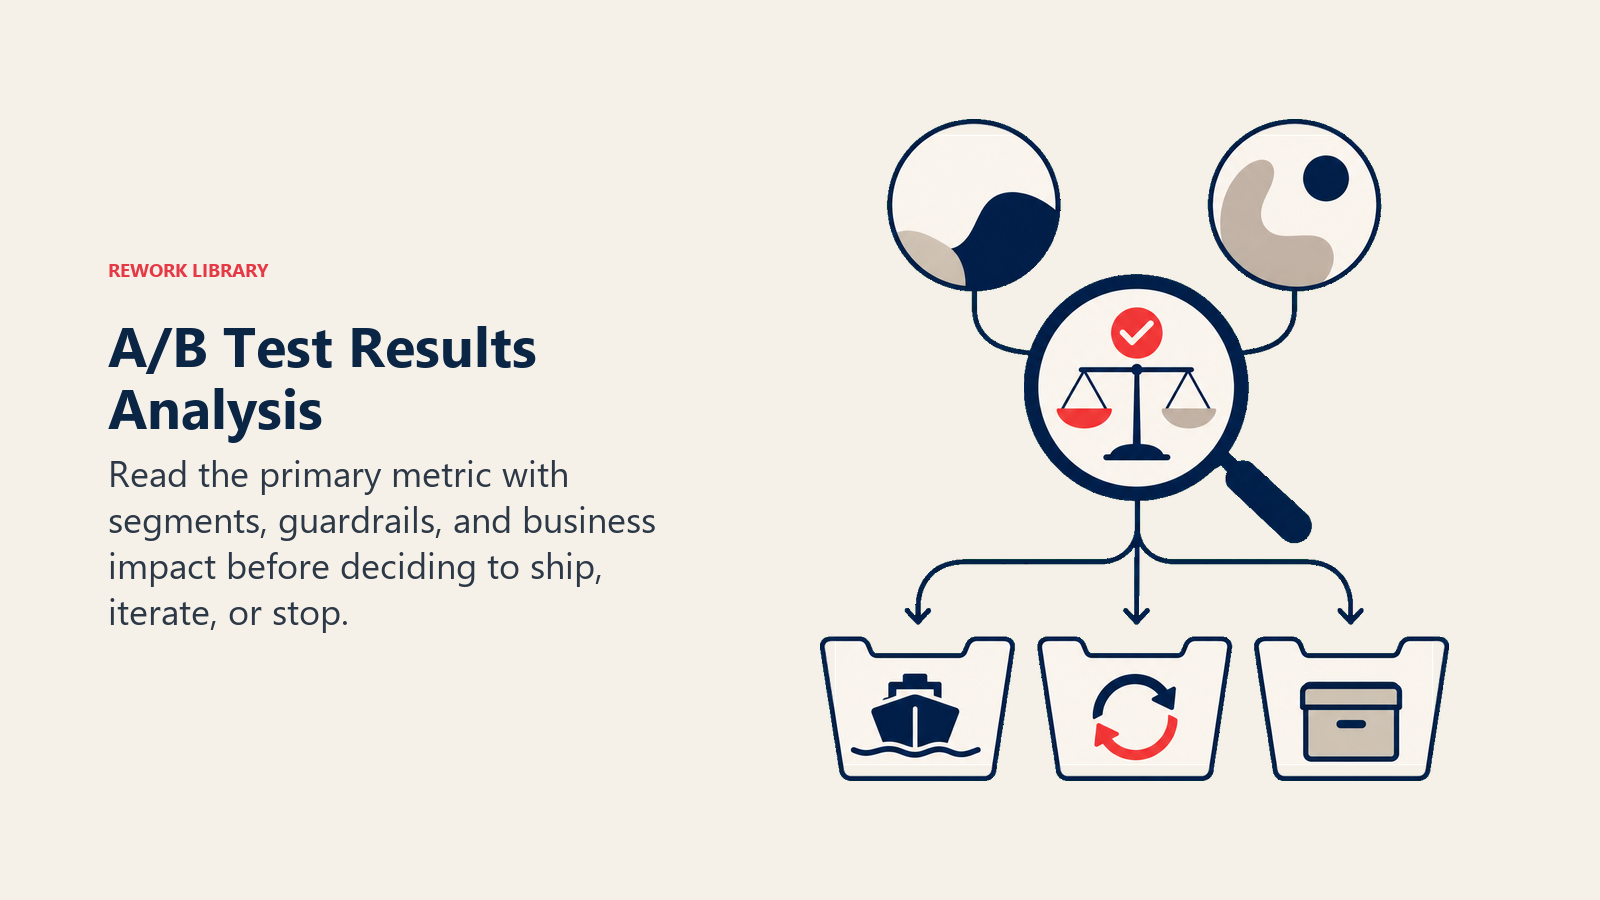
Valeur p : en dessous de 0,05 (pour 95 % de confiance), la différence est statistiquement significative. Au-dessus de 0,05, le résultat n'est pas concluant : le hasard ne peut pas être écarté.
Probabilité de battre la référence : métrique bayésienne qui indique la probabilité que la variante surpasse le contrôle. Au-delà de 95 %, on déclenche généralement la mise en œuvre.
Significativité statistique et significativité pratique : Un test peut être statistiquement significatif sans valoir quoi que ce soit en pratique. En testant deux titres de page d'accueil, la variante B peut l'emporter avec 99,9 % de confiance pour une amélioration de 0,8 % du taux de clic.
Statistiquement valide, certes. Mais 0,8 % d'amélioration sur une métrique située à deux étapes du revenu ne changera rien. La significativité pratique pose la question suivante : « Cette amélioration vaut-elle l'effort de la mettre en œuvre et de la maintenir ? »
Appliquez votre seuil d'effet minimal détectable. Si vous avez fixé le MDE à 5 % et détecté 1,5 %, le test est une victoire statistique mais un renoncement pratique.
Chiffrer le gain et l'impact : Traduisez les améliorations en pourcentage en résultats pour l'entreprise :
- Gain de 12 % sur l'ajout au panier de la page produit × 50 000 visiteurs mensuels × 15 % de taux de référence × 85 \(de panier moyen × 25 % de taux d'achat = 19 125\) de revenu supplémentaire mensuel
- Amélioration de 8 % de la finalisation du checkout × 5 000 débuts de checkout mensuels × 45 % de taux de finalisation de référence × 120 \(de commande moyenne = 21 600\) de revenu supplémentaire mensuel
Montrez aux parties prenantes l'impact en dollars, pas seulement des gains en pourcentage. « Ce test générera 258 000 $ de revenu annuel supplémentaire » fait débloquer des ressources. « Ce test a amélioré la conversion de 8 % » vaut un e-mail de félicitations.
Gérer les résultats non concluants : La plupart des tests (60 à 70 %) donnent des résultats non concluants : aucune différence statistiquement significative n'est détectée. Ce n'est pas un échec, c'est un apprentissage.
Un résultat non concluant signifie que :
- Votre hypothèse était fausse (le changement n'a pas d'importance)
- Votre MDE était trop ambitieux (il y a peut-être un gain de 2 %, mais vous en attendiez 10 % pour la significativité)
- Il vous faut plus de temps ou de trafic pour détecter de plus petits effets
- Des facteurs externes ont introduit trop de bruit
Ne prolongez pas indéfiniment un test en quête de significativité. Acceptez les résultats non concluants, documentez les enseignements et passez au test suivant. Certaines équipes relancent un test avec des changements plus marqués après un résultat non concluant.
Gérer les résultats négatifs : Les résultats négatifs, quand la variante fait moins bien que le contrôle, enseignent autant que les résultats positifs. Une baisse de 10 % avec 95 % de confiance est une connaissance précieuse.
Documentez pourquoi vous pensiez que la variante gagnerait et pourquoi elle a perdu. Ces « études de cas d'échec » évitent de répéter les erreurs et construisent la mémoire de l'entreprise. Une marque de beauté a testé un message d'urgence (« Plus que 3 en stock ! ») en espérant plus de conversions, mais a constaté une baisse de 14 % : les clients se sont sentis manipulés. Cet enseignement a évité des erreurs similaires dans d'autres catégories.
Stratégies de déploiement : Pour les tests gagnants :
Déploiement complet immédiat (le plus courant) : Vous basculez, la variante devient le nouveau contrôle et vous passez au test suivant.
Déploiement progressif (pour les changements majeurs) : Déployez sur 25 % du trafic pendant une semaine, puis 50 %, puis 75 %, puis 100 %. Vous repérez ainsi les problèmes imprévus avant le déploiement complet.
Groupe témoin permanent (pour les changements stratégiques) : Gardez 5 % du trafic sur l'ancienne expérience indéfiniment pour mesurer l'impact à long terme.
Mettez en œuvre les variantes gagnantes en 1 à 2 semaines. Plus vous tardez, plus vous laissez filer de revenu. Une amélioration validée qui génère 20 000 \(par mois vous coûte 10 000\) pour chaque délai de deux semaines.
Normes de documentation : Créez un référentiel de tests qui consigne :
- L'hypothèse et son raisonnement
- La conception et les variantes testées
- Les métriques principales et secondaires
- La taille d'échantillon et la durée
- Les résultats et la significativité statistique
- La quantification de l'impact business
- L'état de mise en œuvre
- Les principaux enseignements
Utilisez un tableur, une base Notion ou un outil dédié. Le format compte moins qu'une documentation régulière. Les tests futurs s'appuieront sur cette mémoire collective.
Une culture du test continu
Ce qui sépare les entreprises qui testent de temps en temps de celles qui ont une culture du test, c'est la cadence d'exécution et l'engagement de l'organisation.
Intégrer le test dans les processus : Le test ne doit pas être un projet à part : il doit devenir la façon normale d'aborder les changements. Avant toute mise à jour importante, posez-vous la question : « Devrions-nous tester ? »
Intégrez le test dans :
- Le développement produit (tester les nouvelles fonctionnalités avant le déploiement complet)
- Les campagnes marketing (tester le message avant d'augmenter les dépenses)
- Les changements de prix (tester d'abord sur des segments restreints)
- Les améliorations UX (valider les hypothèses avant d'investir lourdement)
La question ne devrait pas être « Devons-nous tester ? », mais « Pourquoi ne testerions-nous pas ? »
Structure d'équipe et responsabilités : Dans les petites entreprises (moins de 5 M$ de chiffre d'affaires), le test est généralement confié à un responsable marketing ou growth qui y consacre 25 à 40 % de son temps.
Les entreprises de taille moyenne (5 à 50 M$) recrutent souvent un spécialiste CRO dédié ou un product manager growth qui pilote la feuille de route de tests.
Les grandes entreprises (plus de 50 M$) constituent des équipes d'optimisation avec des analystes, des designers et des développeurs entièrement dédiés à l'expérimentation.
Quelle que soit la taille, organisez un comité de test mensuel pour examiner les résultats, hiérarchiser les prochains tests et s'accorder sur la méthodologie.
Alignement et adhésion des parties prenantes : Les tests échouent quand les dirigeants ou les équipes produit contournent le processus et livrent des changements sans validation. Évitez-le en :
- Partageant chaque mois des synthèses des tests avec la direction
- Chiffrant en dollars l'impact du programme de test
- Associant les parties prenantes à la formulation des hypothèses
- Menant des tests sur les changements qu'elles proposent (elles deviennent des promotrices quand leurs tests gagnent)
Montrez le coût de l'absence de test. Si une refonte envisagée toucherait 100 000 clients par mois et avait 30 % de chances de réduire la conversion de 10 %, le coût attendu de l'absence de test est de X 000 $ par mois (à calculer selon votre panier moyen). Le test supprime ce risque.
Cadence de test et approche en portefeuille : Les programmes matures mènent 8 à 15 tests par trimestre dans différents domaines :
- 40 % d'améliorations incrémentales à forte confiance (victoires probables)
- 40 % de tests incertains avec un potentiel significatif (risque modéré)
- 20 % de « paris audacieux » qui testent des approches radicalement différentes (risque élevé, gain élevé)
Ce portefeuille équilibre des victoires régulières (qui bâtissent la crédibilité et cumulent les gains) et de grands paris (à la recherche d'améliorations de 30 à 50 % qui aboutissent de temps à autre).
Suivez votre taux de réussite. Si 80 % des tests gagnent, vous manquez d'ambition : testez des changements plus importants. Si 10 % seulement gagnent, vos tests sont trop dispersés : concentrez-vous sur les domaines d'amélioration déjà validés.
Apprendre des échecs : Les tests perdants apprennent ce qui n'a pas d'importance, ce qui est aussi précieux que d'apprendre ce qui en a. Après 50 tests, vous saurez que vos clients réagissent fortement aux signaux de confiance mais se moquent des fioritures de design. Cette focalisation évite de gaspiller des efforts.
Constituez une bibliothèque des « tests ratés » avec les hypothèses qui ne se sont pas vérifiées, et relisez-la chaque trimestre. Des tendances émergent : « Nos clients ne réagissent systématiquement pas aux messages d'urgence », ou « La qualité des images compte plus que leur nombre », ou encore « Un checkout simplifié bat toujours un checkout complexe ».
Ces tendances deviennent des avantages stratégiques que vos concurrents n'ont pas.
Techniques de test avancées
Une fois votre base solide, des approches avancées créent de la valeur supplémentaire.
Personnalisation et tests dynamiques : Au lieu de proposer la même variante à tout le monde, proposez des expériences différentes selon les attributs du client :
- Les nouveaux visiteurs voient des éléments qui instaurent la confiance
- Les clients fidèles voient des recommandations de produits personnalisées
- Les clients qui ont abandonné leur panier voient des offres spéciales
- Les segments à forte valeur voient d'abord les produits haut de gamme
La personnalisation exige beaucoup plus de trafic (tester plusieurs variantes sur plusieurs segments) et des outils plus élaborés. Réservez-la aux programmes matures qui comptent 500 000 visiteurs mensuels et plus.
Expérimentation contextuelle : Testez la performance des changements dans différents contextes :
- Disponibilité des produits (messages « en stock », « stock limité » ou « en rupture »)
- Périodes promotionnelles (prix normaux, soldes ou événements de fin d'année)
- Sources de trafic (landing pages de recherche payante ou réseaux sociaux organiques)
- Variations saisonnières (été ou hiver pour l'habillement)
Les tests contextuels produisent des enseignements plus nuancés que les approches uniques pour tous.
Tests sur les nouveaux clients et les clients existants : Les nouveaux clients et les clients fidèles n'ont pas les mêmes besoins. Les nouveaux ont besoin d'information, de confiance et de propositions de valeur claires. Les clients fidèles recherchent l'efficacité, la personnalisation et des récompenses.
Testez séparément ces segments. Une marque d'articles pour la maison a constaté que les nouveaux clients avaient besoin d'informations produit détaillées et d'avis, tandis que les clients fidèles convertissaient mieux avec un contenu minimal et des options de réachat rapides.
Défis multi-appareils et multi-sessions : Les clients se renseignent souvent sur mobile et achètent sur ordinateur, ou abandonnent leur panier sur ordinateur et finalisent sur mobile. Les outils de test standard peinent à gérer ces cas.
Les mises en œuvre avancées s'appuient sur un suivi au niveau de l'utilisateur (cookies, identifiants de compte) pour garantir une expérience cohérente d'un appareil à l'autre. Un client du groupe « variante » voit ainsi la variante, qu'il soit sur mobile, sur ordinateur ou sur tablette.
Pour la plupart des programmes, un test propre à chaque appareil (les utilisateurs mobiles toujours dans le test mobile, ceux sur ordinateur dans le test ordinateur) est plus simple et suffisant.
Tester pendant les périodes de pointe : Les périodes de fort trafic (Black Friday, Cyber Monday, fêtes de fin d'année) donnent envie de tester. Ne le faites pas.
Les périodes de pointe introduisent énormément de bruit : taux de conversion, comportement des clients et flux de trafic diffèrent radicalement des périodes ordinaires. Les tests menés pendant les pointes ne se reproduisent souvent pas en période normale.
Profitez des pointes pour collecter des données de référence en vue des tests de l'an prochain avant la haute saison. Testez votre parcours de checkout des fêtes en octobre, pas en décembre.
Tests internationaux et de localisation : Vendre dans plusieurs pays ou langues impose de tester les préférences culturelles. La signification des couleurs, le ton des messages, les types de preuve sociale et même les préférences de mise en page varient selon les cultures.
Un distributeur de mode européen a constaté que les clients britanniques réagissaient à un message de luxe discret, tandis que les clients allemands préféraient les spécifications techniques et les certifications de qualité. Une même page produit ne fonctionnait pas pour les deux marchés.
Testez les principaux marchés indépendamment quand le trafic le permet. Utilisez les schémas gagnants des plus grands marchés comme hypothèses pour les plus petits.
Erreurs de test courantes et solutions
Tirez profit des erreurs coûteuses des autres. Erreurs statistiques :
Mener des tests sous-dimensionnés : tester avec un trafic insuffisant vous empêche de détecter des améliorations significatives. Calculez la taille d'échantillon avant de lancer le test.
Solution : aucun test ne démarre tant que le calcul de la taille d'échantillon ne confirme pas que vous atteindrez la significativité dans un délai raisonnable (4 à 6 semaines au maximum).
Arrêter les tests trop tôt : consulter les résultats chaque jour et s'arrêter dès que la significativité apparaît fait grimper les faux positifs à 20-30 % au lieu de 5 %.
Solution : fixez la durée du test d'après le calcul de la taille d'échantillon et ne regardez pas les résultats avant la fin. Si vous devez suivre l'avancement, utilisez des calculateurs de test séquentiel.
Le problème des comparaisons multiples : tester quatre variantes simultanément sans correction donne 18 % de risque de faux positif, et non 5 %.
Solution : limitez le nombre de tests simultanés, ajustez les seuils de significativité (en divisant par le nombre de tests) ou recourez aux approches bayésiennes, qui gèrent mieux les variantes multiples.
Erreurs business :
Tester la mauvaise métrique : optimiser le taux de clic alors qu'il faudrait optimiser le revenu par visiteur produit des clics qui ne convertissent pas.
Solution : définissez des métriques de succès qui tiennent compte de l'impact sur l'ensemble du funnel et des résultats business, pas seulement de l'engagement immédiat.
Ignorer le contexte : mener des tests pendant des périodes atypiques (pannes du site, buzz viral, pénuries d'approvisionnement) produit des résultats non généralisables.
Solution : mettez les tests en pause lors d'événements inhabituels. Mieux vaut retarder de deux semaines que gaspiller des semaines de trafic sur des données invalides.
Tout tester : répartir les ressources de test sur des dizaines de petites améliorations empêche d'atteindre la significativité sur quoi que ce soit d'important.
Solution : concentrez les tests sur les domaines à fort impact. Trois tests qui atteignent la significativité valent mieux que dix tests non concluants.
Erreurs de mise en œuvre :
Variantes cassées : des variantes avec des erreurs JavaScript, un checkout défaillant ou des problèmes d'affichage invalident les résultats.
Solution : une checklist de QA obligatoire couvrant tous les navigateurs, appareils et parcours utilisateur critiques avant le lancement.
Problèmes de suivi : un outil d'analytique qui ne se déclenche pas correctement, des événements de conversion manquants ou des doublons faussent les résultats.
Solution : vérifiez le suivi dans le contrôle et dans la variante avant le lancement. Contrôlez chaque jour pendant la première semaine pour repérer rapidement les problèmes.
Flash du contenu d'origine : les utilisateurs voient brièvement le contrôle avant que JavaScript n'affiche la variante, ce qui crée une expérience déroutante et fausse les résultats.
Solution : utilisez des outils de test côté serveur dans la mesure du possible, ou mettez en place des méthodes de déploiement sans scintillement (masquage par style, scripts synchrones).
Erreurs d'organisation :
Le syndrome HiPPO : l'opinion de la personne la mieux payée prend le dessus sur les résultats des tests. Le dirigeant préfère la variante B alors que la variante A a gagné, et c'est la variante B qui est livrée.
Solution : engagez-vous à l'avance à respecter les résultats des tests. Définissez les critères de décision avant le lancement : « Si la variante atteint 95 % de confiance avec un gain d'au moins 5 %, nous la mettons en œuvre, quelles que soient les opinions. »
Le test de façade : mener des tests pour la forme tout en ignorant les résultats, ou mettre en œuvre des changements sans test.
Solution : suivez les taux de mise en œuvre. Si vous terminez des tests mais ne mettez en œuvre que moins de 30 % des variantes gagnantes, vous gaspillez des ressources. Identifiez et levez ce qui vous bloque.
Le manque de patience : exiger des résultats en quelques jours alors que les tests demandent des semaines pousse à sélectionner les données non concluantes qui arrangent.
Solution : fixez les attentes dès le départ. Partagez un calendrier des tests qui indique quand les résultats seront disponibles. Expliquez aux parties prenantes ce que les tailles d'échantillon exigent.
Faux positifs et réplication : Même avec une méthodologie parfaite, 5 % de vos « victoires » à 95 % de confiance sont des faux positifs, des coups de chance et non de vraies améliorations.
Pour les changements critiques, répliquez les tests avant la mise en œuvre complète. Relancez le test avec du trafic neuf. S'il se confirme, la confiance monte à 99,75 % (0,05 × 0,05 = 0,0025 de taux de faux positifs). S'il ne se confirme pas, il s'agissait probablement d'un faux positif.
La plupart des tests tactiques ne justifient pas le coût d'une réplication. Mais pour les changements stratégiques (grandes refontes, changements de prix, révisions du checkout), la réplication évite des erreurs coûteuses.
Construire une feuille de route de tests
Une feuille de route transforme des tests ponctuels en programme stratégique. Point de départ : des tests à fort impact et à faible effort : Mois 1 à 3 : gains rapides
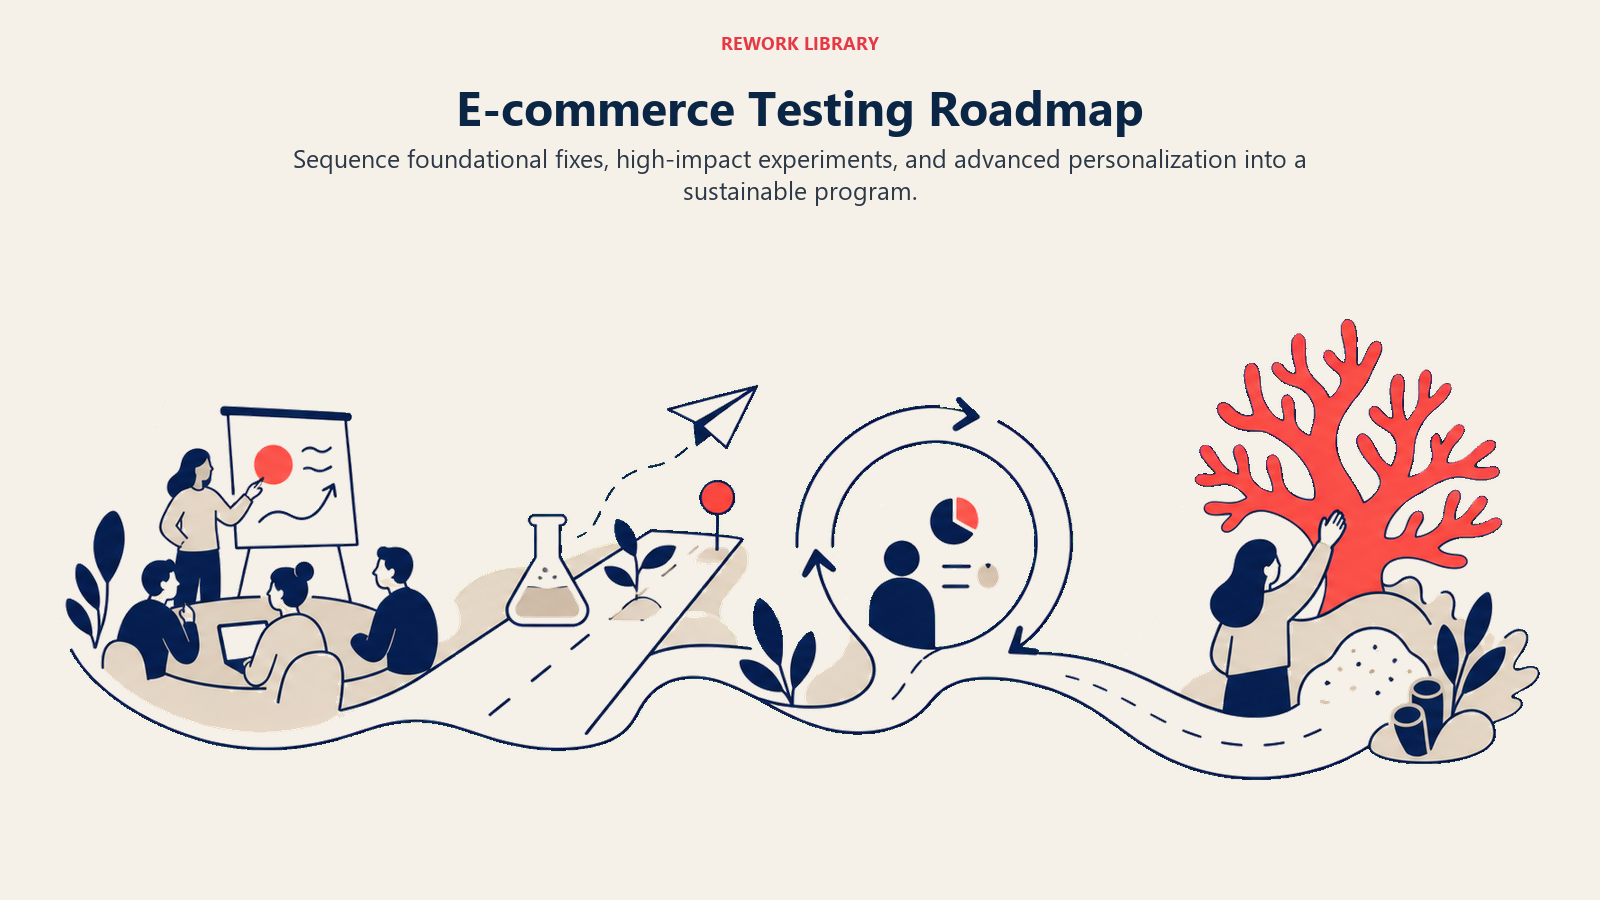
- Texte et emplacement du CTA principal de la page d'accueil
- Disposition de la galerie d'images de la page produit
- Emplacement des badges de confiance sur la page de checkout
- Messages des e-mails de relance de panier abandonné
- Mises en page des principales pages catégorie
Objectif : 4 à 6 tests, 30 à 40 % de taux de réussite, 30 000 à 60 000 $ de revenu annuel supplémentaire
Mois 4 à 6 : optimisation du funnel de conversion
- Refonte complète du template de page produit
- Structure du parcours de checkout (une page ou plusieurs)
- Navigation et organisation des catégories
- Présentation des prix et affichage des remises
- Améliorations de l'expérience propres au mobile
Objectif : 3 à 5 tests, 25 à 35 % de taux de réussite, 80 000 à 150 000 $ de revenu annuel supplémentaire
Déploiement dans toute l'organisation :
Mois 7 à 12 : extension et systématisation
- Tests d'e-mail marketing (objets, mises en page, horaires d'envoi)
- Optimisation des landing pages pour le trafic payant
- Expérience après achat et cross-sells
- Personnalisation pour les principaux segments
- Pré-tests des campagnes saisonnières
Objectif : 8 à 12 tests, 25 à 30 % de taux de réussite, 150 000 à 300 000 $ de revenu annuel supplémentaire. Tester votre e-mail marketing pour l'e-commerce aide à optimiser votre canal le plus performant.
Année 2 : optimisation avancée
- Règles de personnalisation poussées
- Tests prédictifs à l'aide du ML
- Algorithmes de cross-sell et d'upsell
- Optimisation des prix sur l'ensemble des catégories
- Adaptation aux marchés internationaux
Intégration à la feuille de route produit : Les équipes produit et ingénierie voient souvent le test comme un frein au développement. Présentez-le plutôt comme un moyen de réduire le risque du développement.
Avant de construire une nouvelle fonctionnalité, testez un prototype ou un MVP. Un distributeur de meubles voulait créer un outil de visualisation de pièce (trois mois de développement). Il a d'abord testé une fonction simple « voyez-le chez vous » à l'aide d'une superposition de photo basique. Elle a fait baisser la conversion de 4 % : les clients l'ont trouvée gadget. Le test a épargné trois mois de développement inutile.
Intégrez des points de contrôle de test au développement produit :
- Validation du concept (les clients l'utiliseront-ils ?)
- Test de design (quelle variante de design performe le mieux ?)
- Affinage de la fonctionnalité (quelle mise en œuvre précise fonctionne le mieux ?)
- Validation du déploiement (déploiement progressif avec suivi des métriques)
Objectifs annuels et mesure : Fixez des objectifs au niveau du programme :
Objectifs de l'année 1 (nouveau programme) :
- Mener 12 à 15 tests
- Atteindre 25 à 30 % de taux de réussite
- Générer 200 000 à 400 000 $ de revenu supplémentaire
- Bâtir l'infrastructure de test et la documentation
Objectifs de l'année 2 (programme en croissance) :
- Mener 20 à 25 tests
- Atteindre 30 à 35 % de taux de réussite
- Générer 500 000 à 800 000 $ de revenu supplémentaire
- Étendre les tests à l'e-mail et au trafic payant
Objectifs de l'année 3 (programme mature) :
- Mener 30 à 40 tests
- Atteindre 30 à 40 % de taux de réussite
- Générer 1 à 2 M$ de revenu supplémentaire
- Mettre en œuvre la personnalisation et les techniques avancées
Mesurer le ROI du programme de test : Calculez les coûts totaux du programme :
- Abonnement à l'outil de test (15 000 à 50 000 $ par an)
- Temps du personnel (part du salaire des membres de l'équipe concernés)
- Ressources de design et de développement
- Outils d'analytique et de suivi
Comparez-les au revenu supplémentaire documenté issu des tests gagnants. Les programmes matures atteignent généralement un ROI de 10:1 à 20:1.
Un distributeur du marché intermédiaire (15 M$ de chiffre d'affaires annuel) a investi 60 000 \(par an dans son programme de test (outil et personnel) et a généré 680 000\) de revenu supplémentaire grâce à des améliorations validées. Ce ROI de 11:1 ne tient pas compte de la valeur des erreurs évitées grâce aux tests perdants.
Le ROI du test se cumule. Les améliorations de l'année 1 deviennent la nouvelle référence pour les tests de l'année 2. Une hausse de 15 % du taux de conversion la première année rend une amélioration de 10 % la deuxième année plus précieuse en valeur absolue. Cette optimisation cumulative crée des avantages concurrentiels durables.
L'A/B testing fait passer l'e-commerce de l'intuition à l'optimisation systématique. Le cadre présenté ici (rigueur statistique, priorisation stratégique, méthodologie solide et engagement de l'organisation) transforme le test d'une tactique occasionnelle en moteur de croissance cumulatif.
Commencez par les domaines à fort impact avec des outils simples. Construisez votre taux de réussite et votre crédibilité. Passez à des techniques plus élaborées à mesure que votre programme gagne en maturité. Surtout, engagez-vous à tester sans relâche, à apprendre en continu et à déployer rapidement les variantes gagnantes validées.
Les boutiques qui domineront l'e-commerce dans cinq ans ne seront pas celles qui ont les plus gros budgets ou le plus de produits. Ce seront celles qui auront testé de façon plus systématique, appris plus vite et cumulé de petites améliorations jusqu'à obtenir de solides avantages concurrentiels. Bâtissez cette capacité dès maintenant.
Ressources associées
- Optimisation du taux de conversion (CRO) - Stratégies et méthodes complètes pour le CRO
- Optimisation de la page produit - Guide détaillé pour améliorer la page produit
- Optimisation du parcours de checkout - Réduire les frictions et l'abandon au checkout
- Stratégie de prix pour l'e-commerce - Approches stratégiques et psychologie des prix
- Récupération des paniers abandonnés - Regagner méthodiquement les ventes perdues
- Configuration de l'analytique et du suivi - Bâtir de solides fondations de mesure
- Marketing automation - Automatiser les tests et la personnalisation à grande échelle
Sales Operations Practice Lead
On this page
- Pourquoi l'A/B testing compte en e-commerce
- Fondements statistiques et significativité
- Cadre de priorisation des tests
- Méthodologie et conception des tests
- Domaines clés à tester
- Outils et stack technologique
- Bonnes pratiques de mise en œuvre
- Analyser les résultats et définir les actions
- Une culture du test continu
- Techniques de test avancées
- Erreurs de test courantes et solutions
- Construire une feuille de route de tests
- Ressources associées