More in
Sales-Tech-Nachrichten
AI-Vertriebsteams wachsen 2,6-mal schneller. Gartner sagt: Käufer wollen trotzdem einen Ansprechpartner
Juni 6, 2026
Aircall kauft Piper AI, um jeden Verkaufsanruf in Pipeline zu verwandeln
Juni 6, 2026
Salesforce gibt Marketingteams AI-Agents, die Sales Pipeline aufbauen
Juni 6, 2026
Revenue Intelligence hat das Risiko gezeigt. Revenue Execution handelt danach.
Juni 5, 2026
Meta hat einen AI-Agent in WhatsApp integriert, der für jedes Unternehmen Verkäufe abschließt
Juni 4, 2026
VCs haben über 200 Mio. Dollar in AI-Sales-Startups investiert: Das GTM-Stack-Signal
Juni 4, 2026
Sind AI SDRs in 2026 ihr Geld wert? Die Daten sprechen für ein hybrides Team
Juni 3, 2026
GTM Engineering in 2026: Die Vertriebsstelle, die drei Rollen ersetzt
Juni 3, 2026
ZoomInfo versorgt Ihre AI-Sales-Agents mit verifizierten Daten: Der Kompromiss beim Single-Vendor-Ansatz
Juni 3, 2026
Salesforce Summer '26 bringt Multi-Agent-Orchestration am 15. Juni. Das Sales-Ops-Audit, bevor Ihre Agents anfangen, Aufgaben weiterzureichen
Juni 2, 2026
OpenAIs Enterprise-Agent-Plattform: Was RevOps verstehen muss, bevor Ihr Data-Science-Team anfängt zu bauen
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Ihr Data-Science-Team ist wahrscheinlich bereits begeistert. Möglicherweise bereits am Prototypisieren. Und wenn Ihr Unternehmen eine KI-Initiative mit irgendeinem Momentum hat, hat jemand fast sicher erwähnt, interne Agents auf OpenAIs Infrastruktur aufzubauen.
Das ist kein schlechter Instinkt. Aber er schafft ein RevOps-Problem, über das noch niemand spricht.
Im Februar 2026 berichtete TechCrunch, dass OpenAI „Frontier" gestartet hat – eine Enterprise-Plattform für Unternehmen, die ihre eigenen KI-Agents mit OpenAIs zugrundeliegenden Modellen als Engine aufbauen und verwalten möchten. Wie TechCrunch es beschrieb, ist die Plattform darum aufgebaut, Agents „wie menschliche Mitarbeiter" zu behandeln – mit Management-, Aufsicht- und Deployment-Tooling enthalten. Das ist kein neues GPT-Modell. Es ist eine Infrastrukturschicht, die oben auf den Modellen sitzt, und sie zielt direkt auf Organisationen ab, die aufhören wollen, vorgefertigte KI-Tools zu kaufen und beginnen wollen, ihre eigenen zu konstruieren.
Diese Unterscheidung – Plattform versus Modell – ist das Erste, was RevOps richtig stellen muss, weil es ändert, wem was gehört.
Plattform vs. Modell: Warum RevOps sich darum kümmern muss
Wenn Ihr Unternehmen Zugang zu einem KI-Modell kauft (GPT-4, Claude, Gemini), übernimmt das Modell das Denken. Ihre Daten sitzen in Ihren Systemen, und das Modell verarbeitet Eingaben, die Sie ihm geben. Die Sicherheitsgrenze ist relativ klar.
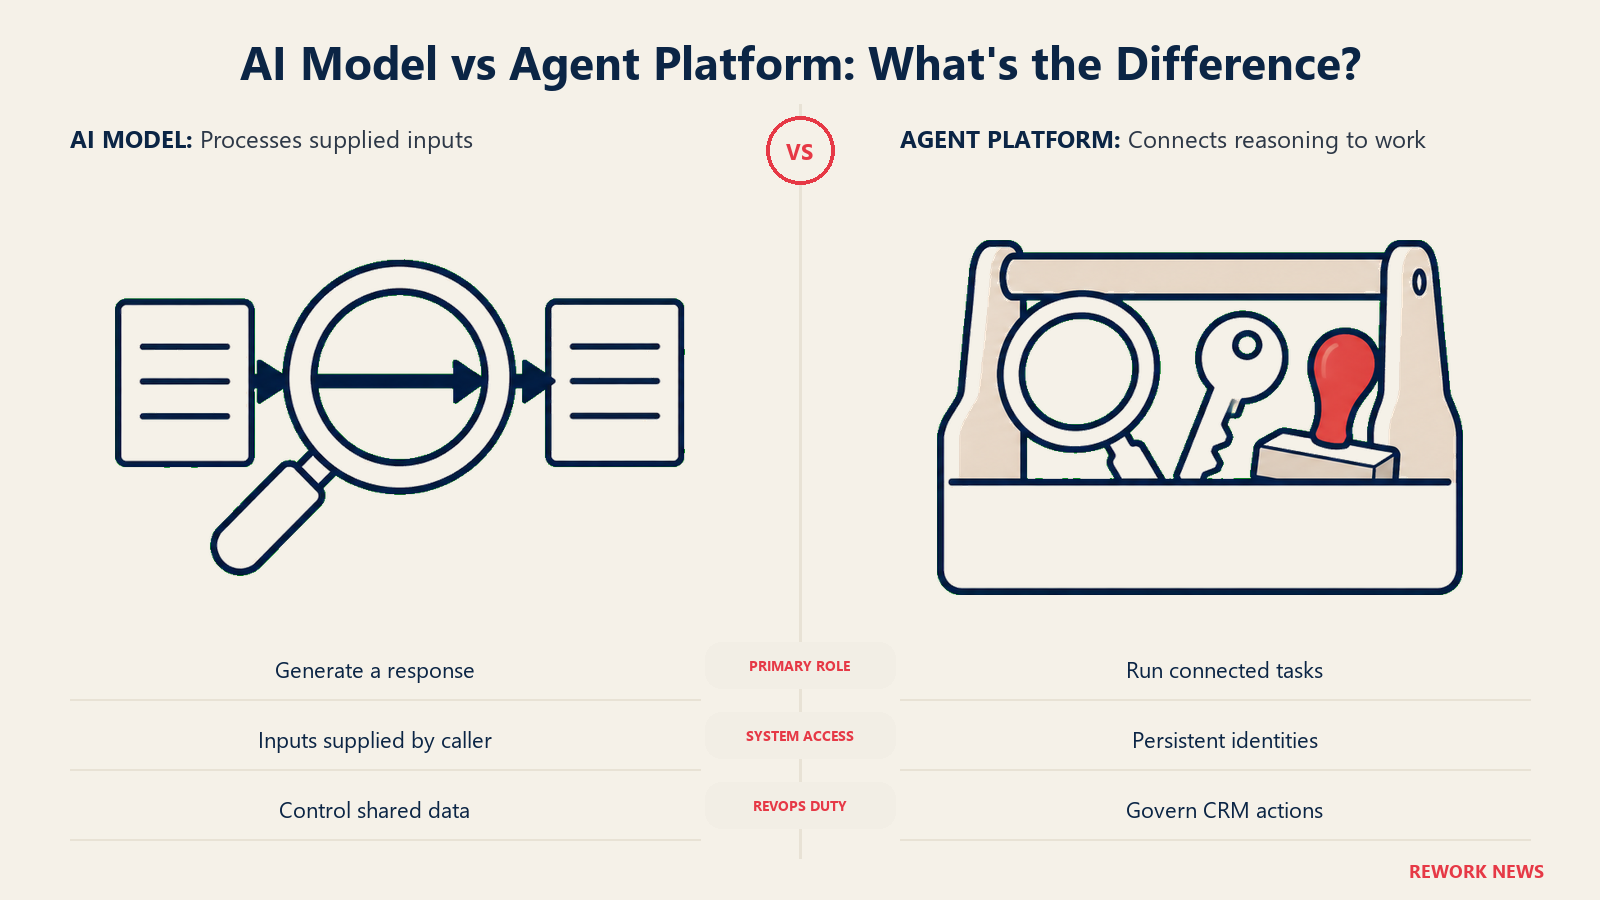
Eine Agent-Plattform ist anders. Agents sind dazu konzipiert, zu handeln – Daten zu lesen, Entscheidungen zu treffen, Aktionen auszuführen und Ergebnisse irgendwo zurückzuschreiben. Sie verbinden sich mit Systemen. Sie authentifizieren sich. Sie sind persistent. Und entscheidend: Die Daten, die sie zum Funktionieren benötigen – Pipeline-Status, Kontaktdatensätze, Deal-Verlauf, Forecast-Signale – leben im CRM, das RevOps besitzt und für das es verantwortlich ist.
Das ist nicht theoretisch. Jeder umsatzseitige Agent, der es wert ist zu bauen, wird CRM-Lesezugriff als Baseline benötigen und wahrscheinlich CRM-Schreibzugriff, um nützlich zu sein. Denken Sie darüber nach, was das bedeutet: Ein individuell gebauter Agent auf OpenAIs Frontier-Plattform, autorisiert von jemandem in Ihrem Data-Science-Team, könnte Opportunity-Phasen aktualisieren, Notizen in Kontaktdatensätze schreiben oder Forecast-Kategorien verändern. Und RevOps weiß möglicherweise nicht einmal, dass er läuft.
Das ist die Governance-Lücke, die Sie schließen müssen, bevor der erste Agent ausgeliefert wird.
Die RevOps-Daten-Bereitschafts-Checkliste
Bevor Ihre Organisation irgendetwas auf einer Enterprise-Agent-Plattform aufbaut (ob OpenAIs Frontier, NVIDIAs offene Agent-Infrastruktur oder etwas anderes), muss Ihr Datenhaushalt in Ordnung sein. Darauf kommt es tatsächlich an:
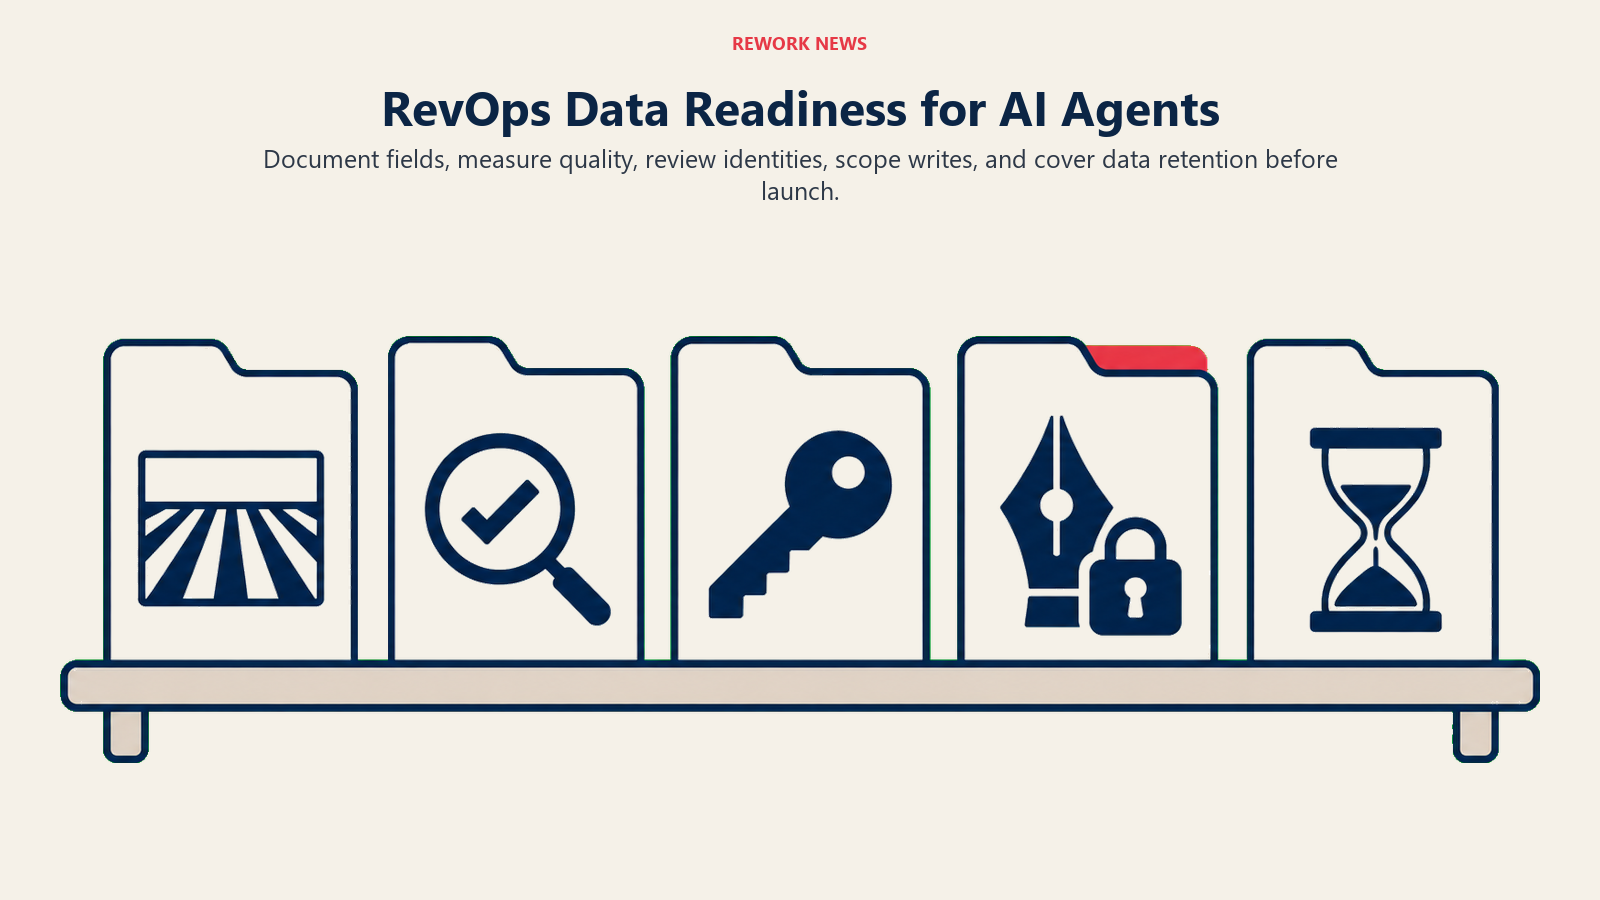
1. Schema-Dokumentation ist aktuell und zugänglich. Agents verbrauchen Felder. Wenn Ihr CRM-Schema 14 Variationen von „Deal Phase" hat, weil vier verschiedene Vertriebsteams die Dinge über drei Jahre unterschiedlich benannt haben, wird ein Agent dieses Durcheinander im Maßstab replizieren. Bevor Sie einem System programmatischen Zugriff gewähren, dokumentieren Sie Ihre kanonischen Felder und setzen Sie sie durch.
2. Datenqualitäts-Baselines sind etabliert. Wenn Ihre Win-Rate nach Segment nie zuverlässig war, weil Mitarbeiter Opportunity-Abschlussdaten nicht aktualisieren, wird ein Agent, der diese Felder für Forecasting nutzt, zuversichtlich klingende schlechte Vorhersagen produzieren. Kennen Sie Ihre Datenqualitätsuntergrenze, bevor ein System beginnt, sie als Wahrheit zu konsumieren.
3. Integrations-Authentifizierung ist überprüft. Wer hat derzeit API-Zugang zu Ihrem CRM? Wann wurde diese Liste zuletzt auditiert? Agent-Plattformen fügen eine neue Kategorie von Systemidentität hinzu – der Agent selbst, nicht nur der Mensch, der ihn konfiguriert hat. Ihr Integrations-Authentifizierungsmodell muss das berücksichtigen.
4. Schreibzugriff ist explizit abgegrenzt. Es gibt einen bedeutsamen Unterschied zwischen einem Agent, der Pipeline-Daten liest, und einem, der sie modifiziert. Read-only-Agents sind risikoärmer. Agents mit Schreibzugriff auf Kontaktdatensätze, Deal-Phasen oder benutzerdefinierte Felder brauchen explizite Genehmigung, dokumentierten Umfang und Rollback-Protokolle.
5. Ihre Datenaufbewahrung und Datenschutzrichtlinien decken automatisierte Systeme ab. Wenn Ihr Unternehmen in Europa operiert, können KI-Systeme, die personenbezogene Daten aus Kontaktdatensätzen verarbeiten, Pflichten unter DSGVO und dem EU-KI-Gesetz auslösen. Prüfen Sie das, bevor Sie live gehen.
Die Governance-Fragen, die Ihre Organisation beantworten muss
Datenbereitschaft ist die Grundvoraussetzung. Das schwierigere Gespräch betrifft die Governance: Wer ist befugt, was zu genehmigen, und was passiert, wenn etwas schiefgeht.
Diese Fragen sollte RevOps aufwerfen, bevor irgendein Agent in Produktion geht:
Wer genehmigt Agent-Zugang zu CRM-Schreibvorgängen? Das sollte nicht ausschließlich eine Data-Science-Entscheidung sein. Jeder Agent, der CRM-Datensätze modifiziert, modifiziert funktional Ihre Pipeline. Das ist eine Entscheidung für RevOps und die Vertriebsleitung. Legen Sie jetzt einen Genehmigungspfad fest, nicht erst nach dem ersten Vorfall.
Was ist der Audit-Trail? Wenn ein Agent dienstagnachts 200 Opportunity-Phasen aktualisiert, können Sie nachvollziehen, was sich geändert hat, warum und es rückgängig machen? Die meisten CRMs haben Feldebenen-Audit-Logs, aber sie sind nicht immer standardmäßig aktiviert. Schalten Sie sie ein und testen Sie den Rollback-Prozess, bevor automatisierte Schreibvorgänge stattfinden.
Wie gehen Sie mit Agent-Fehlern um? Menschliche Mitarbeiter machen Fehler im CRM und Sie haben Prozesse aufgebaut, um sie zu erkennen und zu korrigieren. Agent-Fehler sind anders – sie neigen dazu, systematisch statt zufällig zu sein. Eine einzige falsch konfigurierte Regel kann viele Datensätze schnell beschädigen. Ihr Fehlerbehandlungsprotokoll für automatisierte Systeme sollte strenger sein als das für Menschen, nicht nachsichtiger.
Was ist der Eskalationspfad, wenn ein Agent eine Aktion ausführt, die niemand beabsichtigt hat? Das wird passieren. Es passiert immer, wenn Automatisierung Live-Systeme berührt. Definieren Sie den Eskalationspfad, den Vorfallsverantwortlichen und das Kommunikationsprotokoll, bevor es geschieht.
Wer besitzt die laufende Wartung der Agent-Logik? Agents, die heute gebaut wurden, werden mit CRM-Schemas interagieren, die sich ändern, mit Pipelines, die sich entwickeln, und mit Geschäftsregeln, die aktualisiert werden. Jemand muss die Logik besitzen und sie überprüfen, wenn sich Dinge ändern. „Das Data-Science-Team hat es gebaut" ist keine tragfähige Antwort.
Die Buy-vs-Build-Frage darunter
Es lohnt sich, einen Schritt zurückzutreten und die Entscheidung zu benennen, die Frontiers Launch tatsächlich erzwingt: Ihre Organisation hat jetzt eine echte Wahl zwischen dem Kauf von KI-Agents (Salesforce Agentforce, HubSpot Breeze) und dem Aufbau auf Infrastruktur wie OpenAIs Plattform oder NVIDIAs Open-Source-Toolkit.
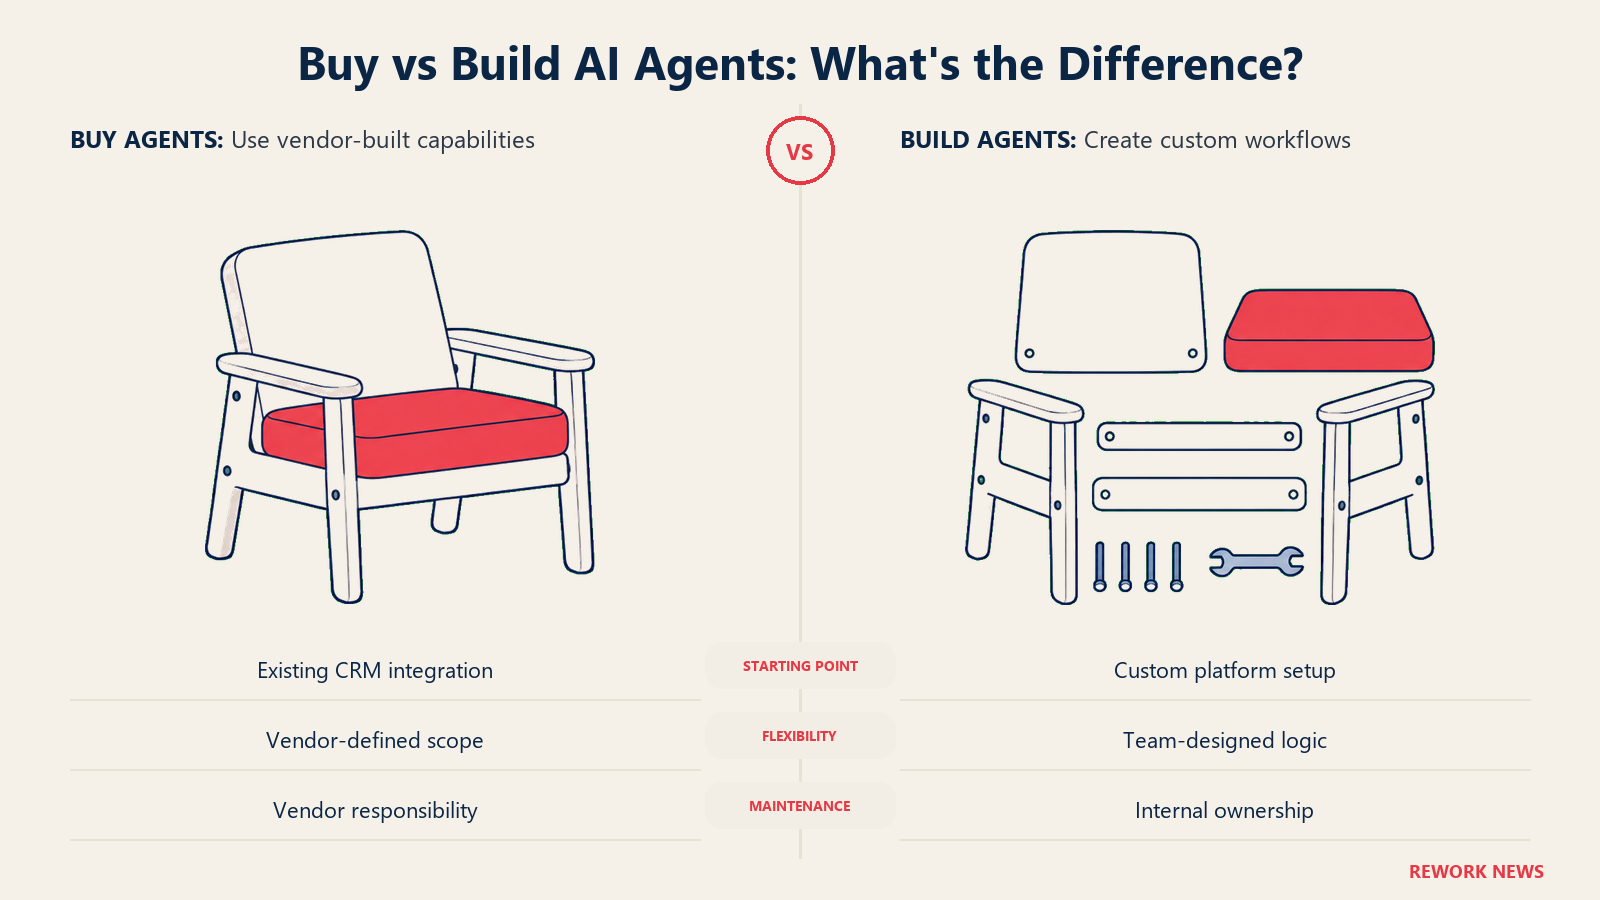
Der Kauf-Pfad ist zu Beginn risikoärmer. Agentforce und Breeze sind bereits mit ihren jeweiligen CRMs integriert. Governance-Tools existieren. Der Anbieter besitzt die Wartung. Aber Sie sind auf das beschränkt, was sie gebaut haben.
Der Build-Pfad bietet mehr Flexibilität und möglicherweise bessere Passung zu Ihren spezifischen Workflows. Aber er legt die Daten-Bereitschaftslast, das Governance-Design und die laufende Wartung direkt auf Ihr Team.
Für die meisten RevOps-Organisationen ist die richtige Antwort jetzt nicht „alles von Grund auf bauen." Es ist „die Plattform gut genug verstehen, um zu steuern, was darauf gebaut wird." Das bedeutet, dabei zu sein, wenn Data Science prototypisiert, und nicht erst vom Agent zu erfahren, nachdem er bereits sechs Wochen mit Ihrem CRM gesprochen hat.
Wenn Sie ganz allgemein über das CRM-Governance-Framework Ihrer Organisation nachdenken, gehört diese Entscheidung zu denselben Fragen, die Sie ohnehin zu jedem System mit Pipeline-Zugriff stellen sollten.
Was Sie diese Woche tun sollten
Sie können Ihr Data-Science-Team wahrscheinlich nicht vom Experimentieren abhalten – und das sollten Sie auch nicht wollen. Aber Sie können sicherstellen, dass das Experimentieren innerhalb einer Struktur stattfindet, die Ihre Pipeline-Integrität schützt.
Diese Woche:
- Fragen Sie Ihr IT- oder Data-Science-Team direkt: Prototypisiert oder skaliert jemand derzeit Agents gegen unser CRM? Die Antwort könnte Sie überraschen.
- Ziehen Sie Ihr CRM-API-Zugriffsprotokoll und identifizieren Sie Integrationen oder Systemnutzer, die Sie nicht erkennen. Schließen Sie alles, was nicht mehr aktiv ist.
- Planen Sie 30 Minuten mit wem auch immer Ihre CRM-Administration leitet, um eine einseitige Richtlinie zu entwerfen: Was muss ein Agent durchlaufen, um Schreibzugriff auf Produktions-CRM-Daten zu erhalten? Selbst ein grober erster Entwurf ist mehr, als die meisten Organisationen derzeit haben.
- Identifizieren Sie einen einzelnen risikoarmen Workflow – vielleicht das Protokollieren abgeschlossener Aktivitäten oder das Aktualisieren eines benutzerdefinierten Felds basierend auf E-Mail-Engagement –, bei dem Sie bereit wären, einen einfachen Agent in einer Sandbox-Umgebung zu pilotieren. Ein realer Testfall gibt Ihrem Governance-Prozess etwas Konkretes, woran er sich messen kann.
Die Plattform ist bereits da draußen. Ihr Data-Science-Team ist bereits neugierig. Die RevOps-Rolle hier ist nicht, die Dinge zu verlangsamen – es ist sicherzustellen, dass wenn Agents beginnen, in Ihrer Revenue-Infrastruktur zu laufen, sie innerhalb von Leitplanken laufen, die Sie entworfen haben.
Weiterführende Artikel
- Drei No-Code-Agent-Plattformen in einem Quartal: CEO-Strategie: Das übergreifende Buy-vs-Build-Entscheidungs-Framework für alle drei Enterprise-Agent-Plattform-Launches
- Governance-Checkliste für KI-Agents im RevOps: Das 5-Punkte-Governance-Framework, bevor ein Agent Ihre CRM-Daten berührt
- CRM-Datenmodell-Design: Ihr CRM so strukturieren, dass Agents saubere, konsistente Daten zum Arbeiten haben
- KI-Adoptions-ROI messen: Wie Sie die Messung aufsetzen, bevor individuelle Agents in Revenue-Workflows laufen
Quelle: TechCrunch, 5. Februar 2026
