More in
KI am Arbeitsplatz: Insights
Die Koordinationssteuer: Der versteckte Kostenfaktor, der die operative Geschwindigkeit bremst
Apr. 13, 2026
KI-ROI jenseits von 'Zeit gespart' messen
März 17, 2026 · Currently reading
Die Governance-Lücke: Was Leader bei KI am Arbeitsplatz falsch machen
März 5, 2026
KI-Agenten in der Sales-Pipeline: Hype, Realität und was wirklich funktioniert
Jan. 22, 2026
KI-Copiloten vs. KI-Agenten: Den Unterschied zu verstehen ist wichtig
Jan. 21, 2026
KI-ROI jenseits von 'Zeit gespart' messen
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Jede Fallstudie eines KI-Anbieters nennt "40% Zeit gespart" oder "3 Stunden pro Rep und Woche". Diese Zahlen sind kein ROI. Es sind Aktivitätsmetriken, und sie überstehen keine CFO-Prüfung.
Das Problem ist nicht, dass Zeitersparnis bedeutungslos wäre. Es ist, dass Zeitersparnis eine Input-Metrik ist, keine Outcome-Metrik. Freigewordene Stunden sind nur dann wertvoll, wenn sie in etwas umgelenkt werden, das Umsatz generiert, Kosten senkt oder Risiken reduziert. Ein Pilot, der drei Stunden pro Rep und Woche spart, ist wertlos, wenn diese drei Stunden in längere Mittagspausen und LinkedIn-Scrolling fließen. Und die meisten Pilotberichte erfassen nicht, wofür die gesparte Zeit tatsächlich genutzt wurde, was bedeutet, dass die ROI-Aussage bestenfalls hypothetisch ist.
Die Unternehmen, die belastbare Business Cases für KI-Investitionen aufbauen, sind über Zeit-gespart-Rechnungen hinausgegangen. Sie messen Umsatzwirkung, Qualitätsverbesserung, Capability-Erweiterung und Risikoreduktion. Keine dieser Dimensionen taucht in einem Standard-Pilotbericht auf, aber alle sind messbar, wenn man die Messung von Anfang an mitplant. KI-Performance-Messung behandelt die Instrumentierung, also wie man die Messinfrastruktur vor einem Pilot aufsetzt, statt sie nachträglich zusammenzubauen.
Warum Zeit-gespart-Metriken scheitern
Das Verführerischste an Zeit-gespart-Metriken ist, dass sie leicht zu berechnen sind und gewaltig klingen. "KI spart unserem Sales-Team 15 Stunden pro Woche" ist eine saubere, zitierfähige Zahl. Multipliziert man sie mit den durchschnittlichen Vollkosten pro Stunde, ergibt sich eine annualisierte Einsparung, die in einem Slide Deck überzeugend aussieht.
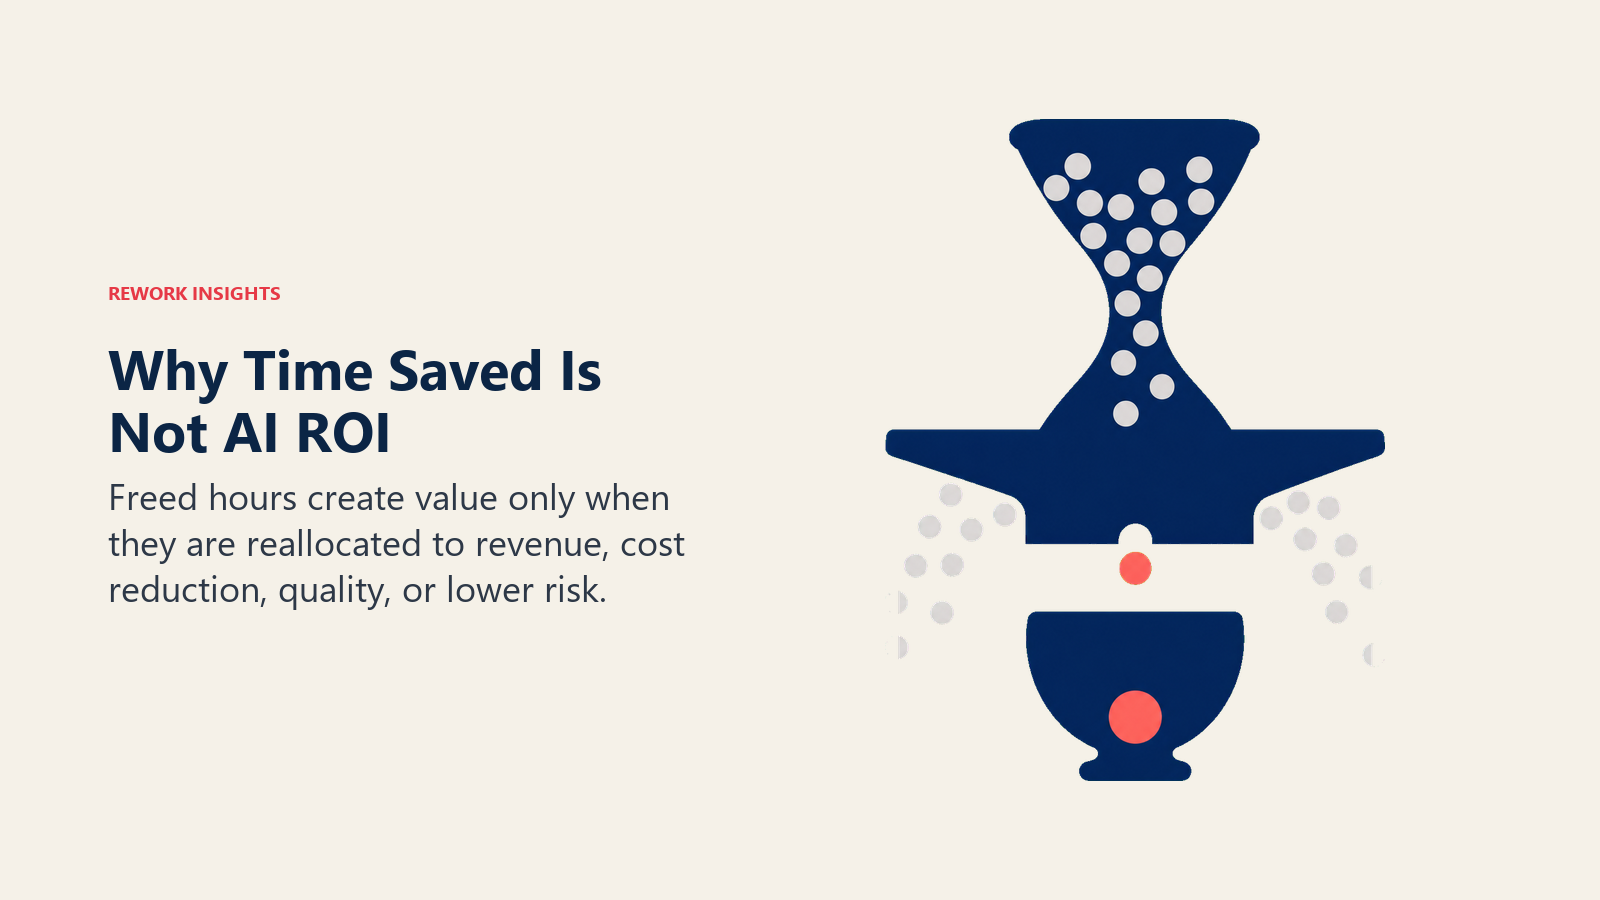
Aber die Rechnung hat drei strukturelle Probleme:
Problem 1: Sie erfassen die Umverteilung nicht. Gesparte Zeit ist nur so wertvoll wie das, wohin sie umgelenkt wird. Wenn ein Rep 15 Stunden Notizen pro Woche spart und diese Zeit in mehr Prospecting steckt, ist der Wert real. Wenn er sie in administrative Aufgaben steckt, die vorher nicht erledigt wurden, ist der Wert real, aber anders. Wenn die Zeit in unstrukturierten Aktivitäten versickert, ist der Wert null. Die meisten Piloten messen gesparte Stunden, nicht umgelenkte Stunden.
Problem 2: Sie lassen nach. Der Neuheitseffekt bei der Effizienz ist real, aber vorübergehend. Wird ein neues Produktivitäts-Tool eingeführt, ist die Nutzung hoch, die Teams sind motiviert und die Zeitersparnis erreicht ihren Höhepunkt. McKinseys Forschung zur Adoption generativer KI ergab, dass die meisten Organisationen nach der anfänglichen Deployment-Phase deutlich schrumpfende Produktivitätsgewinne sehen, das "Produktivitätsplateau" ist ein strukturelles Phänomen, kein Zeichen einer gescheiterten Implementierung. Sechs Monate später ist das Tool Teil des Basis-Workflows, die Neuheit ist verflogen, und ein Teil der anfänglichen Zeitersparnis ist vom Aufwand für die Verwaltung des Tools selbst aufgezehrt worden. ROI-Berechnungen auf Basis von Messungen aus der Spitzenphase überschätzen den langfristigen Wert durchgängig.
Problem 3: Sie lassen sich leicht manipulieren. Wird ein Pilot nach gesparten Stunden bewertet, haben die gemessenen Personen einen Anreiz, hohe Zahlen zu melden. Selbstberichtete Zeitersparnisse in Anbieter-Fallstudien haben ein Zuverlässigkeitsproblem, dem CFOs zu Recht skeptisch gegenüberstehen. Die unabhängige Messung der Zeitverteilung vorher und nachher erfordert eine Methodik, die die meisten Pilotprogramme nicht umsetzen.
Die CFO-Frage lautet nicht "Wie viel Zeit hat das gespart?" Sie lautet "Was haben Sie damit gemacht, und woher weiß ich das?" Die meisten KI-Pilotteams können den zweiten Teil dieser Frage nicht beantworten. Genau diese Lücke soll dieses Framework schließen.
Vier Dimensionen des KI-ROI
Ein vollständiges KI-ROI-Bild umfasst vier unterschiedliche Dimensionen. Die meisten Organisationen messen eine oder zwei. Ein Business Case, der auf Board-Ebene standhält, erfordert ein Messdesign über alle vier von Beginn des Deployments an.
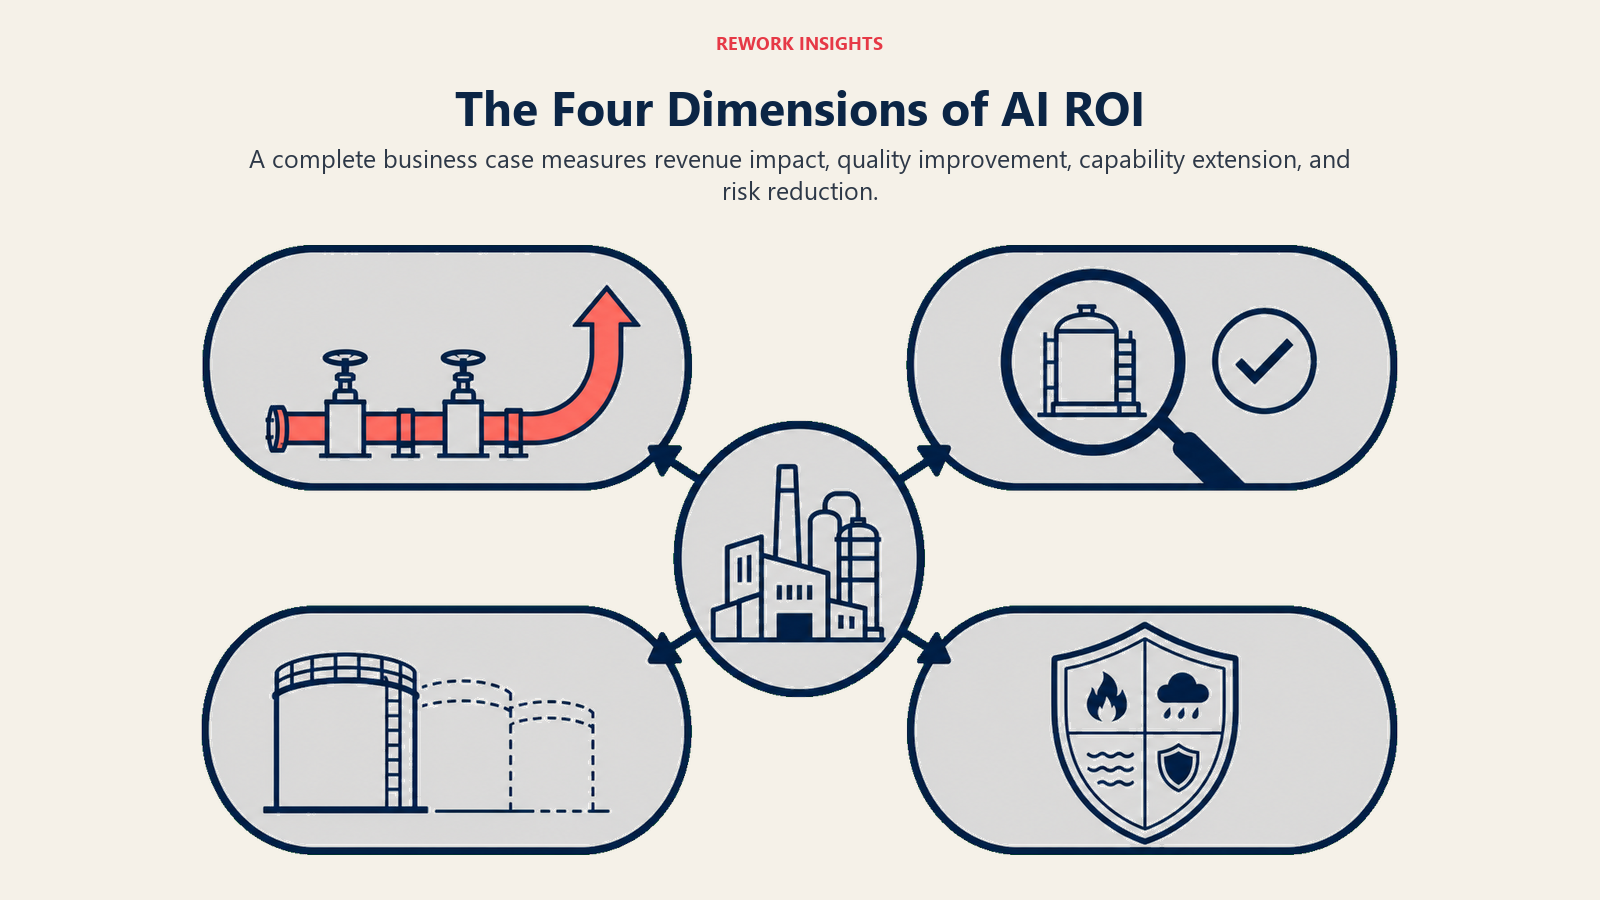
Dimension 1: Umsatzwirkung. Das direkteste Maß für KI-ROI im Sales- oder Umsatzkontext. Dazu gehören Pipeline-Velocity (bewegen sich Deals schneller, wenn KI bei Qualifizierung oder Follow-up beteiligt ist?), Veränderungen der Konversionsrate (konvertieren Leads, die mit KI-Unterstützung bearbeitet werden, häufiger?) und Effekte auf die Deal-Größe (führen KI-unterstützte Proposals oder Preisempfehlungen zu höheren anfänglichen Deal-Werten?).
Die Umsatzwirkung ist die stärkste Dimension, weil sie in der Währung beziffert wird, die der Führung am wichtigsten ist. Sie ist aber auch am schwersten sauber zuzuordnen, weil bei KI-unterstützten Deals auch menschliches Urteil, Marktbedingungen und Beziehungsfaktoren das Ergebnis beeinflussen. Umsatzattribution ist generell ein notorisch schwieriges Problem, warum Attribution in den meisten RevOps-Setups kaputt ist lohnt sich zu lesen, bevor Sie Ihre Vergleichsgruppe entwerfen, denn dieselben Attributionslücken, die den Marketing-ROI verzerren, verzerren auch Ihre KI-ROI-Aussagen, wenn Sie sie nicht berücksichtigen. Saubere Messung erfordert Vergleichsgruppen: dieselbe Rep-Population, ähnliche Lead-Qualität, unterschiedlicher Tool-Zugang. Die meisten Pilotprogramme legen das nicht von Anfang an an, weshalb sie keine Aussagen zur Umsatzwirkung treffen können, die einer Prüfung standhalten.
Dimension 2: Qualitätsverbesserung. KI verbessert die Konsistenz von Ergebnissen durchgängig, auch wenn sie die Geschwindigkeit nicht verbessert. Weniger Fehler bei der CRM-Dateneingabe, Konsistenz der Proposal-Sprache, Genauigkeit der Follow-up-Taktung, Vollständigkeit der Call-Protokolle: Das sind Qualitätsdimensionen, die die langfristige Pipeline-Gesundheit und Compliance beeinflussen. Sie sind schwerer direkt zu monetarisieren, aber leichter zu messen als die Umsatzwirkung.
Wenn die Activity-Capture-Funktionen von Salesforce Einstein die CRM-Datenvollständigkeit von 60% auf 85% verbessern, ist die Qualitätsverbesserung messbar. Eine verlässliche Baseline setzt aber voraus, dass Ihr CRM-Datenmodell zuerst sauber strukturiert ist: Sind Pflichtfelder nicht einheitlich definiert, messen Vollständigkeitsprozente vor und nach dem Deployment unterschiedliche Dinge. Wenn KI-gestützte Proposal-Erstellung die rechtlichen Prüfzyklen verkürzt, weil die Sprache konsistenter ist, ist das eine Qualitätsverbesserung mit realer Kostensenkungswirkung. Diese Dimensionen erfordern vor dem Deployment eine Baseline-Messung und nach dem Deployment eine Messung in einem festgelegten Intervall, was die meisten Piloten auslassen.
Dimension 3: Capability-Erweiterung. Manche KI-ROI hat nichts damit zu tun, Bestehendes schneller zu erledigen. Es geht darum, Dinge zu tun, die vorher in dem jetzt erreichbaren Umfang nicht möglich waren. Ein Sales-Team mit 10 Reps, das Outreach früher für 50 Prospects pro Woche personalisieren konnte, kann ihn jetzt mit derselben Headcount für 200 Prospects pro Woche personalisieren. GitHubs Forschung zum ROI von Copilot liefert eine der gründlichsten Studien zur KI-Capability-Erweiterung: Entwickler erledigten Aufgaben bis zu 55% schneller, doch der dauerhaftere Befund war, dass Engineers komplexere Aufgaben übernahmen, die sie zuvor gemieden hatten, eine echte Erweiterung der Team-Capability statt nur ein Effizienzgewinn. Diese Capability-Erweiterung taucht in Zeit-gespart-Rechnungen nicht auf, weil es nicht darum geht, bei bestehenden Aufgaben Zeit zu sparen. Es geht um Skalierung.
Capability-Erweiterung ist besonders wichtig für kleine und mittlere Unternehmen. Ein Unternehmen mit 50 Mitarbeitenden, das Notion AI oder ClickUp AI nutzt, um Dokumentation und Prozesskonsistenz aufrechtzuerhalten, die zuvor dedizierte Operations-Headcount erforderten, hat eine echte Capability-Erweiterung erreicht, nicht nur Effizienz. Diese Tools werden ohne Messplan gekauft, aber der ROI ist im Rückblick oft klarer, als er im Pilot erschien.
Dimension 4: Risikoreduktion. Die am seltensten gemessene Dimension, aber zunehmend wichtig, da KI in compliance-sensible Workflows eingebettet wird. Deloittes Report State of AI in the Enterprise ergab, dass Risikoreduktion in regulierten Branchen inzwischen der am zweithäufigsten genannte Treiber für KI-Investitionen im Unternehmen ist, vor Produktivität und nur hinter Kostensenkung. Konsistente CRM-Daten reduzieren das Audit-Risiko. KI-gestützte Vertragsprüfung verringert das Risiko, dass ungünstige Klauseln übersehen werden. Standardisierte Kundenkommunikation reduziert die Varianz dessen, was Reps in sensiblen Situationen sagen. Risikoreduktion ist in einem positiven ROI-Rahmen schwer zu monetarisieren (man misst die Kosten von Dingen, die nicht passiert sind), aber sie ist real und in regulierten Branchen von Bedeutung.
Das Problem des Messdesigns
Das grundlegende Problem der meisten KI-Piloten ist nicht, dass die Technologie nicht funktioniert. Es ist, dass die Piloten nicht von Tag eins an so instrumentiert sind, dass sie den ROI messen.
Ein Standard-KI-Pilot sieht so aus: Das Tool wird für ein Team ausgerollt, man holt subjektives Feedback zur Nützlichkeit ein, sammelt am Ende der Pilotphase selbstberichtete Zeitersparnisdaten, fügt das mit einigen Anekdoten zu einer Fallstudie zusammen und begründet damit einen größeren Kauf. Diese Methodik kann keine ROI-Aussage liefern, die einer unabhängigen Prüfung standhält.
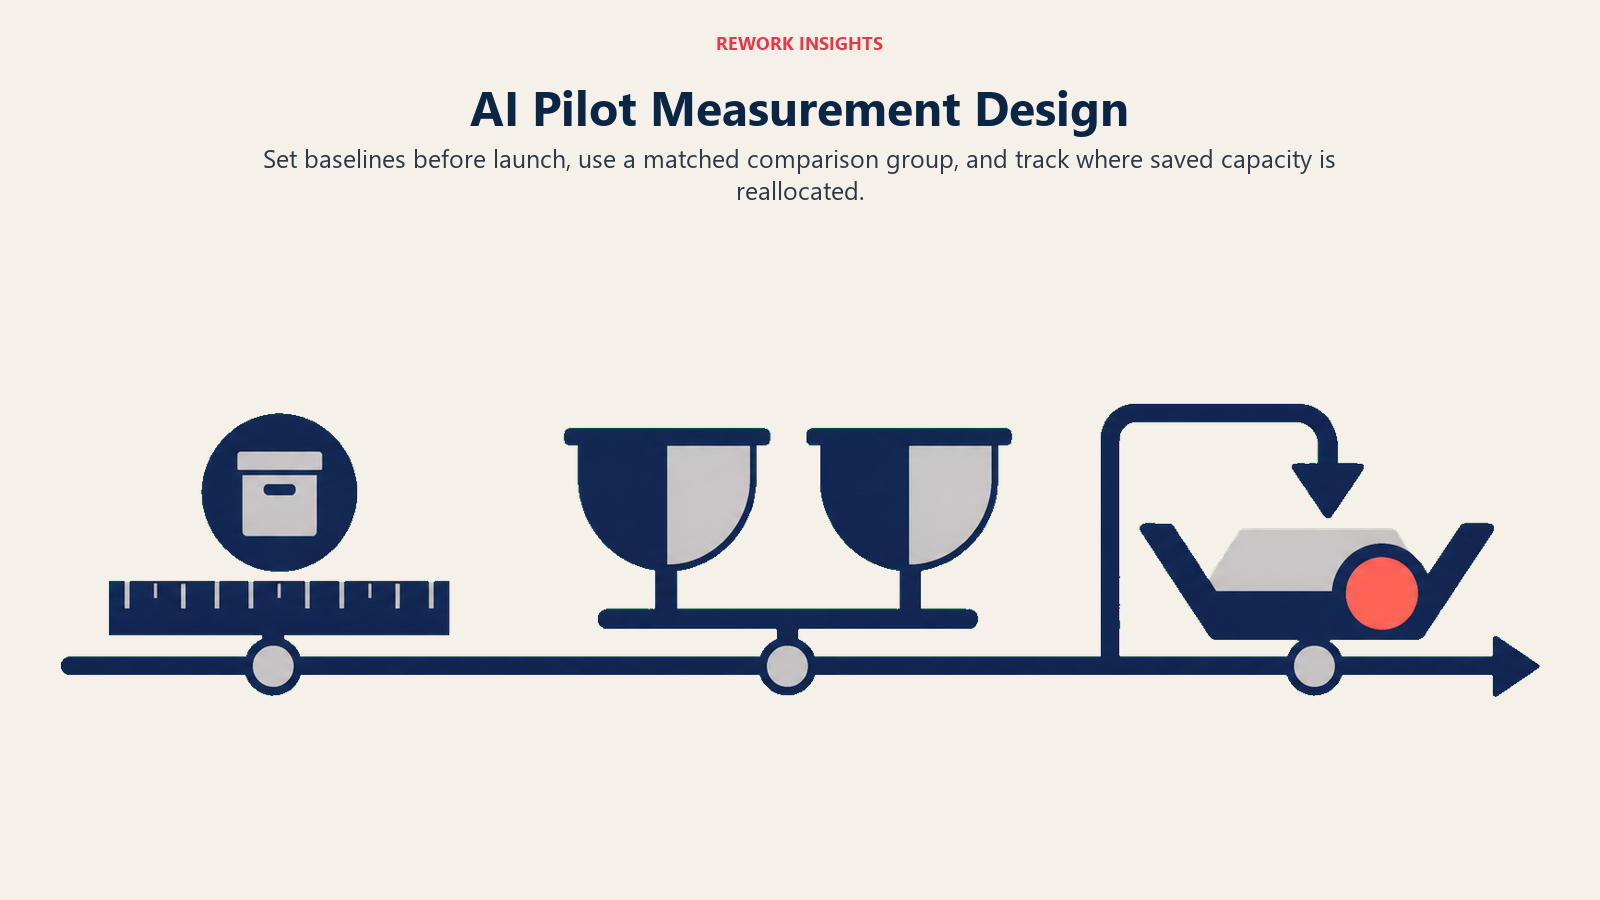
Ein richtig instrumentierter Pilot sieht anders aus. Vor dem Deployment: Etablieren Sie Baselines für die Metriken, die Sie nach dem Deployment messen werden. Wie lange brauchen Deals derzeit von Stage 2 zu Stage 3? Wie hoch ist die aktuelle Vollständigkeitsrate der CRM-Daten? Wie lang ist die durchschnittliche Zeit vom Call bis zum Proposal? Welcher Prozentsatz der eingehenden Leads konvertiert über den ersten Kontakt hinaus? Diese Baselines erfordern Arbeit, aber ohne sie messen Sie eine Veränderung von einem unbekannten Ausgangspunkt aus.
Während des Deployments: Führen Sie eine Vergleichsgruppe. Rollen Sie das KI-Tool für eine Teilmenge des Teams aus und lassen Sie die Kontrollgruppe im bisherigen Workflow. Gleichen Sie die Gruppen nach Betriebszugehörigkeit der Reps, Territory-Qualität und historischer Konversionsrate ab. Messen Sie beide Gruppen an denselben Metriken. Nur so lässt sich der KI-Effekt von anderen Variablen isolieren.
Nach dem Deployment: Messen Sie die Umverteilung, nicht nur die Einsparung. Wenn das Tool pro Rep und Woche drei Stunden spart, wofür zeigen Ihre CRM-Daten, dass diese Stunden verwendet wurden? Wenn Sie diese Frage nicht beantworten können, ist die Zeitersparnis-Aussage hypothetisch.
Diese Methodik erfordert mehr Vorab-Planung, als die meisten Piloten zulassen. Aber Organisationen, die sie auslassen, verteidigen den ROI am Ende mit Anekdoten statt mit Daten, was bedeutet, dass jeder Verlängerungszyklus eine Verhandlung auf Basis wahrgenommenen statt gemessenen Werts ist.
Before/After-Methodik: Was die meisten Unternehmen auslassen
Selbst Unternehmen, die den KI-ROI ernsthaft messen wollen, machen durchgängig zwei Baseline-Fehler.
Sie messen den falschen Ausgangspunkt. Die Baseline-Messung sollte erfolgen, bevor das Tool angekündigt wird, nicht nachdem es ausgerollt ist. Sobald Menschen wissen, dass ein KI-Tool kommt, ändert sich das Verhalten. Reps beginnen, CRM-Datensätze aufzuräumen. Manager beginnen, Protokollierungsstandards durchzusetzen. Die Baseline wird künstlich aufgebläht, was den Vergleich nach dem Deployment ungünstig macht. Die Baseline-Datenerhebung sollte unsichtbar sein oder zumindest von der Ankündigung des KI-Deployments entkoppelt.
Sie überspringen die qualitative Baseline. Zahlen allein erzählen nicht die ganze Geschichte. Befragen Sie vor dem Deployment eine Stichprobe des Teams: Wofür verwenden sie die meiste Zeit? Was ist der mühsamste Teil ihres Workflows? Welche Informationen hätten sie gern, die sie derzeit nicht haben? So entsteht eine qualitative Baseline, mit der sich beurteilen lässt, ob die KI die Schmerzpunkte tatsächlich adressiert hat, für die sie gedacht war, und nicht nur, ob sich aggregierte Metriken bewegt haben.
Bei Notion AI und ClickUp AI im Produktivitätskontext muss die Before/After-Methodik ein Audit der Team-Dokumentation umfassen: Wie viele Prozesse sind derzeit dokumentiert? Wie aktuell ist die Dokumentation? Wie oft wird sie tatsächlich genutzt? Diese Fragen etablieren die Capability-Baseline, die die KI-Dokumentationsunterstützung verbessern soll. Unternehmen, die diese Baseline auslassen, können nicht sagen, ob die KI geholfen hat oder ob das Team nur deshalb Dinge dokumentiert hat, weil ein neues Tool verfügbar war.
Das AI ROI Measurement Canvas
Ein Planungs-Tool für die Zeit vor dem Deployment, um KI-Investitionen über alle vier Dimensionen hinweg messbaren Ergebnissen zuzuordnen:
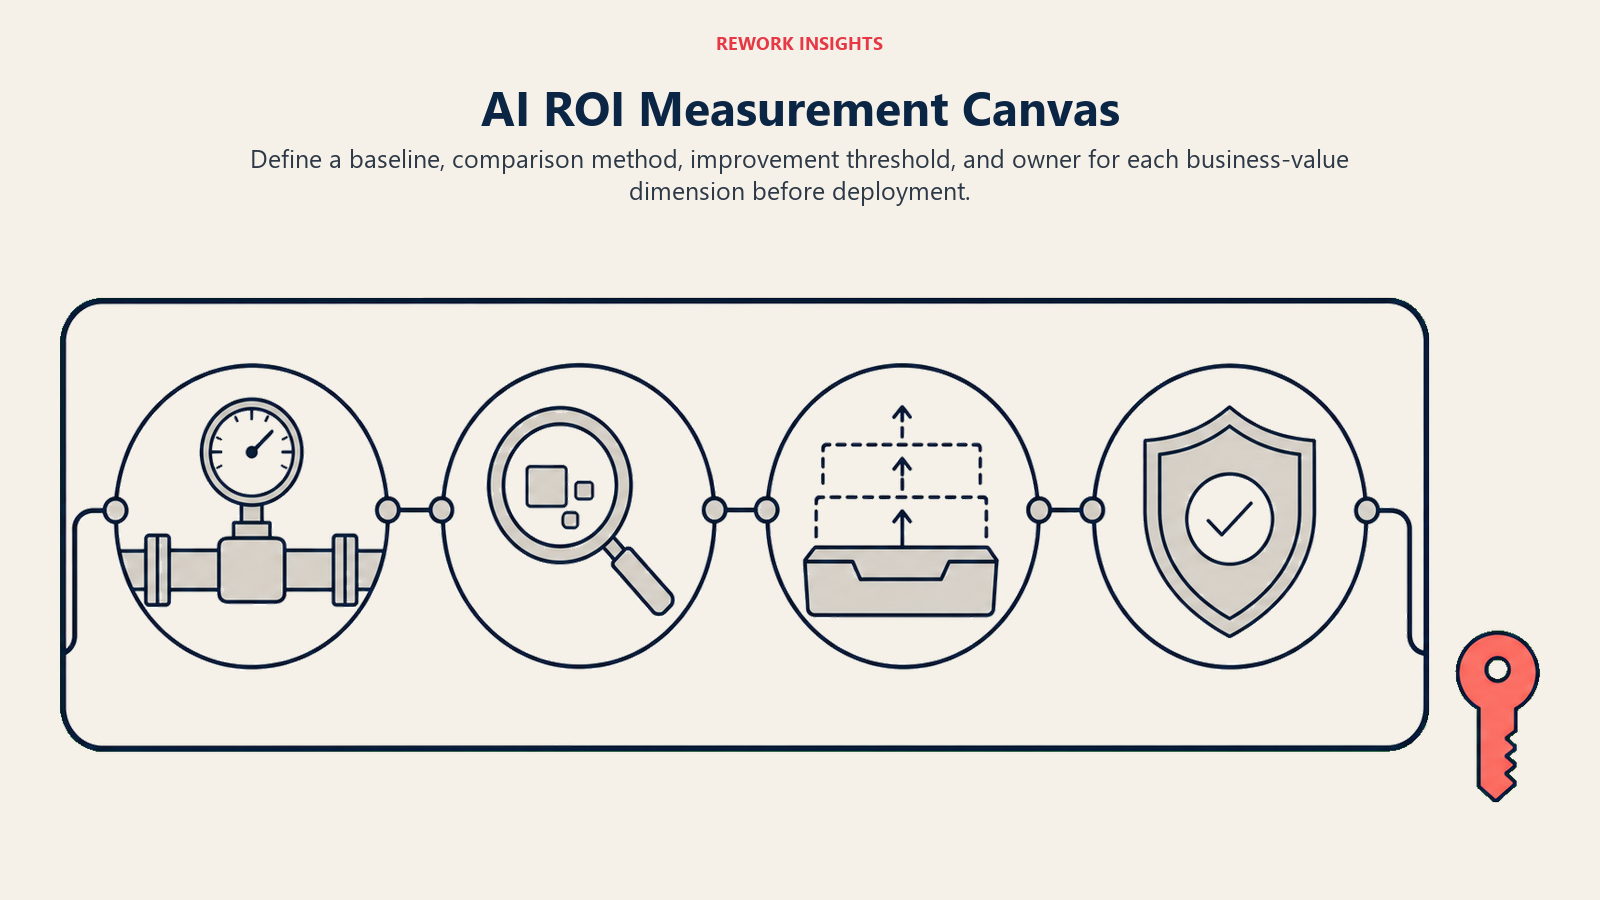
Quadrant Umsatzwirkung. Definieren Sie: In welcher Pipeline-Stage wird sich eine messbare Veränderung zeigen? Wie hoch ist die aktuelle Konversionsrate oder Velocity in dieser Stage? Welche Vergleichsgruppe nutzen Sie? Welche Verbesserungsschwelle würde die Investition rechtfertigen?
Quadrant Qualitätsverbesserung. Definieren Sie: Welche Metriken zur Output-Qualität werden derzeit erfasst? Welche ließen sich erfassen, werden es aber nicht? Wie lautet die aktuelle Baseline? Wie viel Verbesserung ist operativ signifikant?
Quadrant Capability-Erweiterung. Definieren Sie: Welche Aufgaben sind derzeit kapazitätsbeschränkt? Welche Skalierung wäre wertvoll, wenn sie erreichbar wäre? Wie hoch ist das aktuelle Volumen, und was würde ein erweitertes Volumen für Umsatz oder Kosten bedeuten?
Quadrant Risikoreduktion. Definieren Sie: Welche Compliance- oder Konsistenzrisiken bestehen im aktuellen Workflow? Welche davon adressiert dieses KI-Tool? Wie würden Sie die Risikoreduktion messen (Vorfallrate, Audit-Feststellungen, rechtliche Prüfzyklen)?
Das Canvas braucht etwa 90 Minuten, um es für ein konkretes Deployment auszufüllen. Es ist keine akademische Übung. Es ist ein Planungs-Tool fürs Deployment, das erzwingt, dass die Messinfrastruktur entworfen wird, bevor das Tool live geht. Wenn der Pilot endet, werden die Daten für den ROI-Case bereits erhoben, statt nachträglich zusammengesucht zu werden.
Fünf Metriken für die ersten 90 Tage
Wenn Sie KI ohne vollständiges Messframework deployen und einen praktischen Startpunkt brauchen, stehen diese fünf Metriken stellvertretend für den echten ROI über alle vier Dimensionen. Für eine breitere Auswahl an KI-Produktivitäts-ROI-Metriken, die über Sales-Kontexte hinausgehen, auch für Ops-, Marketing- und Support-Teams, bietet der Bibliotheksartikel zusätzliche Benchmarks und Messvorlagen.
Pipeline-Stage-Velocity. Messen Sie die durchschnittliche Verweildauer in jeder Pipeline-Stage vor und nach dem Deployment. Schnellere Bewegung durch die Stages deutet auf echte Workflow-Verbesserung hin, nicht nur auf verschobene Aktivität.
CRM-Datenvollständigkeitsrate. Messen Sie den Prozentsatz der Kontakt- und Aktivitätsdatensätze mit vollständigen Pflichtfeldern. Eine Verbesserung deutet auf Qualitätsgewinne hin, die sich zu besserem Forecasting und besserer Segmentierung aufsummieren.
Verschiebung der Rep-Zeitverteilung. Lassen Sie Reps zwei Wochen vor und zwei Wochen nach dem Deployment protokollieren (oder leiten Sie es aus CRM-Aktivitätsdaten ab), wie sie ihre Arbeitszeit verbringen. Achten Sie auf Umverteilung hin zu wertschöpfenden Aktivitäten, nicht nur auf die Reduktion von Aktivitäten mit geringem Wert.
Reaktionszeit auf eingehende Leads. Die Zeit zwischen dem Eintritt eines Leads ins System und dem ersten menschlichen Kontakt. KI-gestütztes Routing und Qualifizierung sollten sie verkürzen. Sie ist leicht zu messen und direkt mit Konversionsraten korreliert.
Ablehnungsrate von KI-Outputs. Wie oft werden KI-generierte Vorschläge (E-Mails, nächste Schritte, Zusammenfassungen) von den prüfenden Menschen ignoriert oder wesentlich geändert? Niedrige Ablehnungsraten deuten auf hohe Relevanz hin. Hohe Ablehnungsraten deuten auf ein Problem bei Modell- oder Datenqualität hin, das den langfristigen Wert begrenzt.
Diese fünf Metriken sind nicht umfassend. Aber sie sind ab Tag eins messbar, sie decken mehrere ROI-Dimensionen ab, und sie geben Ihnen etwas Reales für ein 90-Tage-Review, das nicht auf selbstberichteter Zeitersparnis beruht.
Was Sie rückwirkend tun können
Wenn Sie KI-Tools bereits ohne Messplan deployt haben, sind Sie nicht ohne Optionen. Sie können Baselines aus historischen CRM-Daten rekonstruieren: Betrachten Sie Pipeline-Velocity, Datenvollständigkeit und Aktivitätsmuster aus den 6 bis 12 Monaten vor dem Deployment. Die retrospektive Baseline ist nicht so sauber wie eine prospektive, aber sie liefert einen Vergleichspunkt.
Beginnen Sie jetzt, die vorausschauenden Metriken zu erfassen, auch wenn die rückwärtsgerichtete Baseline unvollkommen ist. Ein 12-Monats-Trend mit steigender Pipeline-Velocity und CRM-Datenqualität ist auch ohne präzise Baseline vor dem Deployment eine glaubwürdige ROI-Geschichte, solange Sie bei der Methodik transparent sind.
Die Unternehmen, die in ROI-Gesprächen am meisten zu kämpfen haben, sind jene, die Tools aufgrund wahrgenommenen Werts gekauft, ohne Messung ausgerollt haben und nun Verlängerungskosten ohne Daten verteidigen. Die Lösung ist kein besseres Slide Deck. Es ist der Aufbau der Messinfrastruktur (auch nachträglich) und die Nutzung tatsächlicher Leistungsdaten als Anker für das Gespräch.
Das ist es, was CFOs fordern, wenn sie bei "Zeit gespart" nachhaken. Sie wollen wissen, was das Unternehmen für die Investition bekommen hat, gemessen in Größen, die mit Umsatz, Qualität, Capability oder Risiko verbunden sind. Gesparte Zeit ist ein Mittel. Diese vier Dimensionen sind die Zwecke.
Mehr erfahren
