More in
KI am Arbeitsplatz: Insights
Die Koordinationssteuer: Der versteckte Kostenfaktor, der die operative Geschwindigkeit bremst
Apr. 13, 2026
KI-ROI jenseits von 'Zeit gespart' messen
März 17, 2026
Die Governance-Lücke: Was Leader bei KI am Arbeitsplatz falsch machen
März 5, 2026
KI-Agenten in der Sales-Pipeline: Hype, Realität und was wirklich funktioniert
Jan. 22, 2026
KI-Copiloten vs. KI-Agenten: Den Unterschied zu verstehen ist wichtig
Jan. 21, 2026 · Currently reading
KI-Copiloten vs. KI-Agenten: Den Unterschied zu verstehen ist wichtig
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Anbieter verwenden "Copilot" und "Agent" synonym. Das ist eine der teureren Verwechslungen in Enterprise-Software gerade. Den falschen zu kaufen, wenn man den anderen braucht (oder umgekehrt), ist keine geringfügige Fehlausrichtung. Es gestaltet das Betriebsmodell, die menschlichen Rollen rund um die Technologie und die Risikobereitschaft, die für ein erfolgreiches Deployment erforderlich ist. Leader, die diesen Unterschied nicht verstehen, treffen KI-Investitionsentscheidungen basierend auf Marketing-Sprache.
Das spielt praktisch eine Rolle, nicht theoretisch. Die operativen Implikationen dieser zwei Kategorien sind grundlegend verschieden, und der CRM-Markt (wo KI-Features jetzt Standard sind) ist eine nützliche Linse, um zu verstehen, warum.
Die definitorische Spaltung
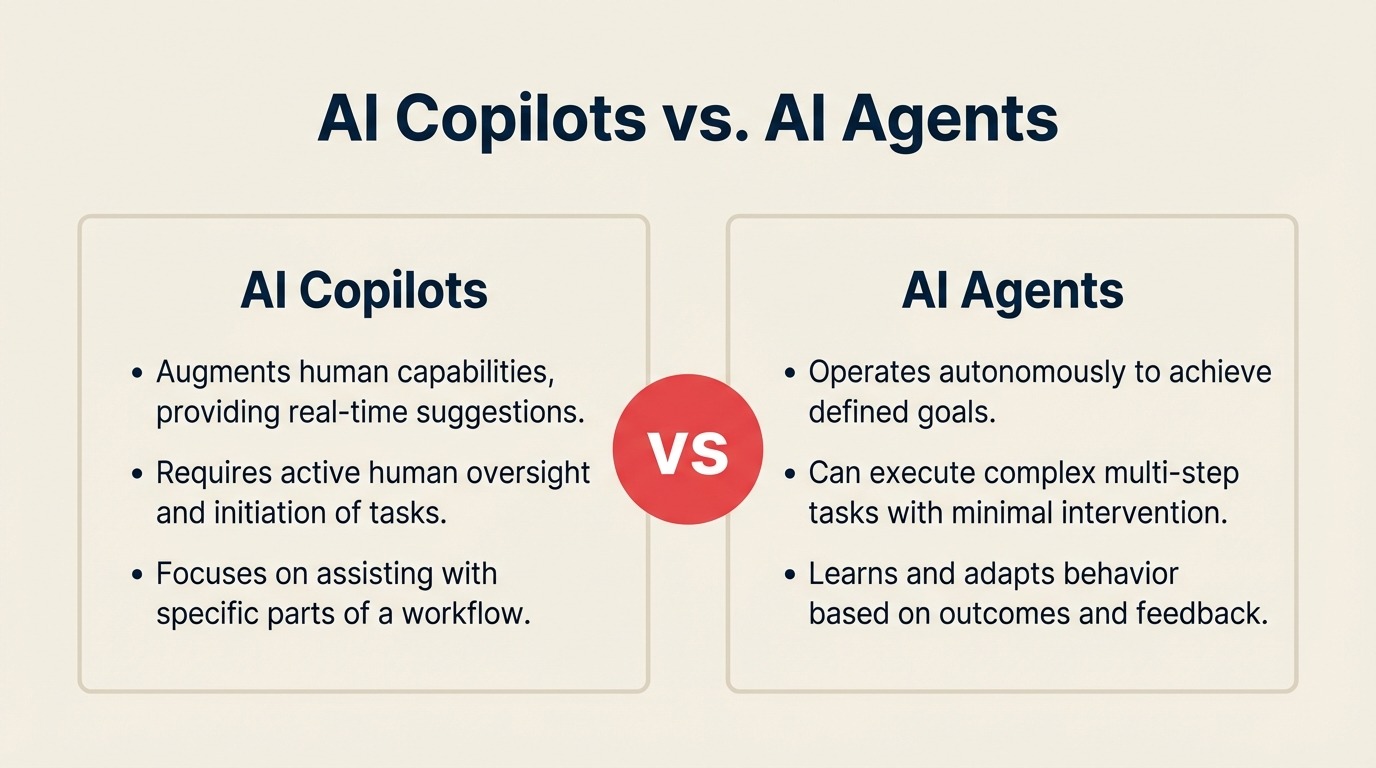
Ein Copilot verstärkt die Entscheidung eines Menschen. Er liefert Informationen, generiert Entwürfe, zeigt Empfehlungen auf und kennzeichnet Muster. Aber ein Mensch überprüft den Output und ergreift die Aktion. Die KI ist im Empfehlungsgeschäft, nicht im Aktionsgeschäft.
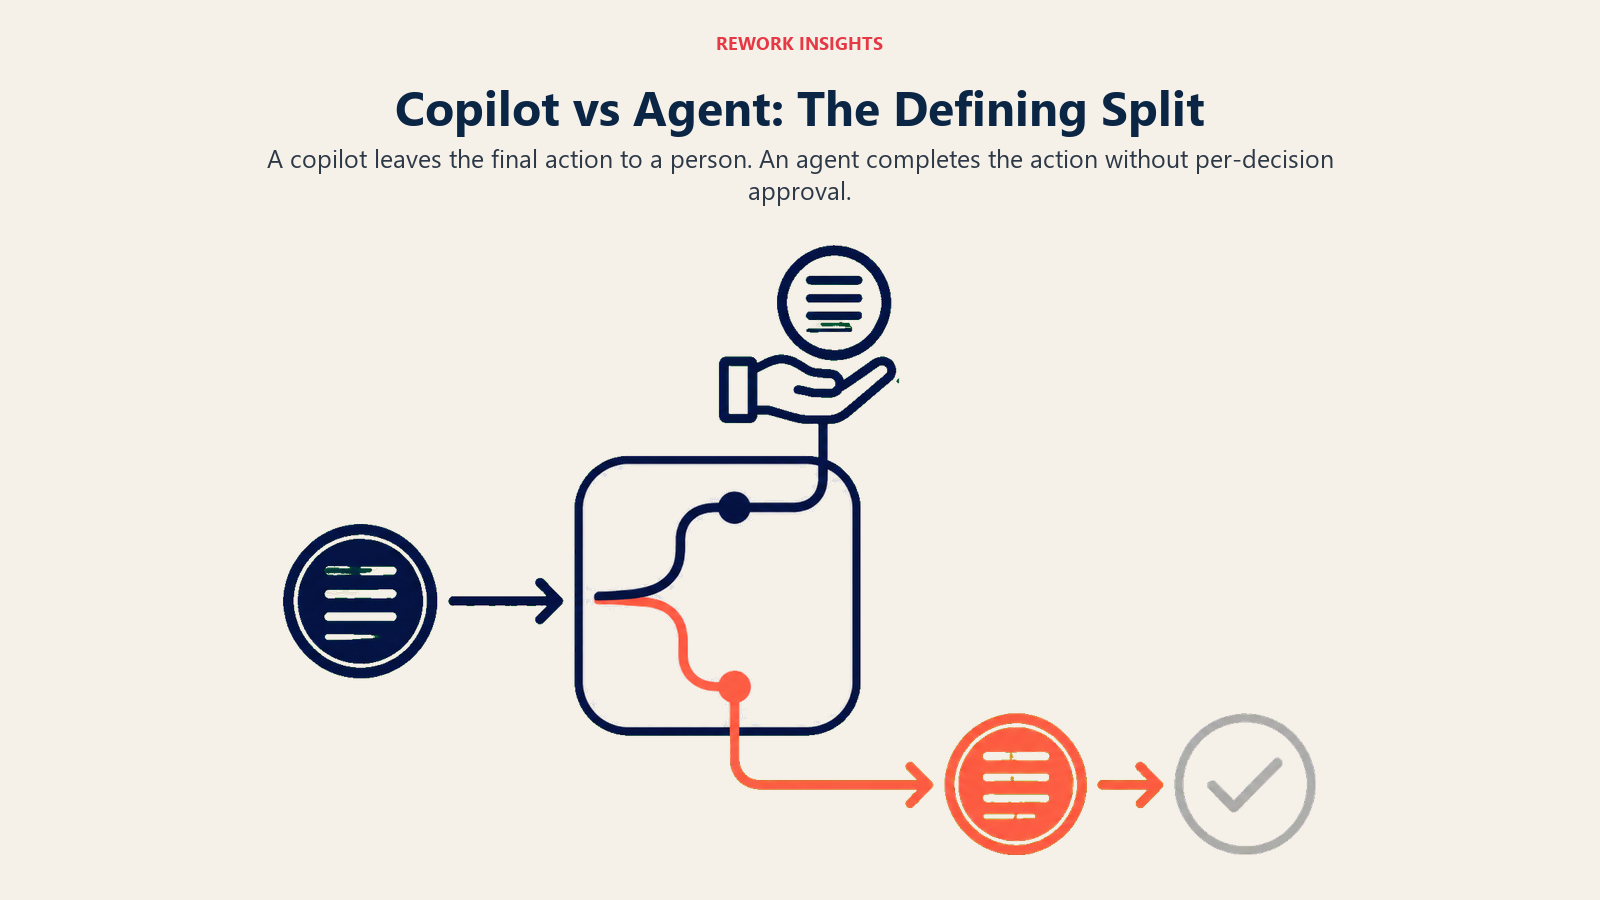
Ein Agent handelt innerhalb definierter Grenzen ohne Genehmigung pro Entscheidung. Er führt Aufgaben aus, löst Workflows aus, sendet Kommunikationen und aktualisiert Datensätze basierend auf seinen eigenen Outputs. Ein Mensch definiert die Parameter und überprüft die Ergebnisse, genehmigt aber nicht jede Aktion in Echtzeit. OpenAIs Forschung zu agentischen KI-Systemen unterscheidet zwischen Einzel-Schritt-KI-Unterstützung und Multi-Step-autonomer Ausführung – eine Unterscheidung, die sich direkt auf die Copilot-Agent-Spaltung abbildet, auf die Käufer in Enterprise-Software stoßen. Hilfreich ist hier auch, KI-Workflow-Automatisierung als Kategorie zu verstehen: Die Linie zwischen "automatisiertem Workflow" und "KI-Agent" ist dünner, als die meisten Käufer realisieren.
Die Unterscheidung klingt sauber, bis man sie auf echte Produkte anwendet. HubSpots KI-E-Mail-Kompositionsfunktion, die einen Sales-E-Mail-Entwurf für einen Rep zur Überprüfung und zum Senden erstellt, ist ein Copilot. Ein Tool, das High-Intent-Leads identifiziert und sie automatisch ohne Rep-Beteiligung in eine spezifische Sequence einschreibt, ist ein Agent. Aber wenn HubSpots KI einen Kontakt bewertet und diese Bewertung automatisch einen Workflow auslöst, der den Kontakt in eine andere Warteschlange weiterleitet, ist das ein Copilot oder ein Agent?
Das ist ein Agent. Die Aktion passiert ohne menschliche Genehmigung am Entscheidungspunkt. Aber die meisten Käufer denken nicht so darüber nach, wenn sie durch eine Produktdemo klicken.
Warum diese Unterscheidung kaufkritisch ist
Wenn Sie einen Copiloten kaufen, kaufen Sie ein Produktivitäts-Tool. Change Management geht um Adoption: Menschen dazu zu bringen, den Vorschlag zu verwenden statt ihn zu ignorieren. Fehlermodi sind begrenzt, weil immer ein Mensch zwischen dem KI-Output und der realen Konsequenz steht.
Wenn Sie einen Agenten kaufen, kaufen Sie ein Prozess-Redesign. Change Management geht um die Neugestaltung des Betriebsmodells: Welche Entscheidungen trifft jetzt die KI, welche Rollen ändern sich dadurch, wie sieht menschliche Überprüfung im neuen Flow aus, und wie behandeln Sie die Fehler des Agenten, bevor sie nachgelagerten Schaden verursachen?
Unternehmen, die Agenten kaufen und Copiloten-Niveau-Deployment-Aufwand erwarten, bekommen typischerweise eines von zwei Ergebnissen. Entweder wird der Agent ohne adäquates Oversight-Design deployed, und Fehler häufen sich bis jemand den Output überprüft und ein Problem entdeckt. Oder der Agent wird post-Deployment auf Copiloten-Verhalten eingeschränkt, die Parameter so stark gestrafft, dass er für jede Aktion menschliche Genehmigung benötigt, was bedeutet, dass man Agenten-Preise für Copiloten-Funktionalität bezahlt hat.
Die Integrationsanforderungen unterscheiden sich ebenfalls erheblich. Salesforce Einsteins Opportunity-Scoring-Feature (ein Copilot) kann nützliche Outputs generieren, auch wenn Ihre CRM-Daten Lücken haben, weil ein Sales Manager die Bewertung überprüft und sein eigenes Urteil anwendet. Ein Agent, der Leads basierend auf KI-Scoring in verschiedene Sequences weiterleitet, benötigt saubere, konsistente Daten, um korrekt zu funktionieren, weil es kein menschliches Review-Gate zwischen dem KI-Output und der Aktion gibt. CRM-Workflow-Automatisierung richtig zu machen, bevor man KI-Agenten darauf aufbaut, ist einer der praktischsten Wege, das Deployment-Risiko zu reduzieren. Dasselbe Produkt, agentisch statt als Copilot genutzt, erfordert eine deutlich höhere Untergrenze bei der Datenqualität.
Die mittlere Kategorie, über die niemand spricht: überwachte Agenten
Die meisten Enterprise-KI-Deployments passen nicht sauber in eine der Kategorien. Sie operieren als überwachte Agenten: Systeme, die autonom handeln, aber innerhalb einer Review-Architektur, bei der Menschen sehen, was der Agent getan hat, und es rückgängig machen können.
Ein überwachter Agent könnte automatisch eine Follow-up-E-Mail an einen Prospect senden, aber jede gesendete E-Mail in einem Dashboard protokollieren, das ein Manager täglich überprüft. Oder er könnte die Bewertung eines Leads aktualisieren und eine Routing-Änderung auslösen, aber die Änderung für menschliche Bestätigung kennzeichnen, bevor sie vollständig ausgeführt wird. Die Automatisierung existiert, aber ebenso die Aufsichtsschicht.
Hier leben die meisten CRM-KI-Features tatsächlich in der Produktion. Zoho Zias Vertriebsprognosen fließen in Pipeline-Berichte ein, die Sales Manager überprüfen. HubSpots prädiktive Lead-Scores informieren die Priorisierung durch Reps, ohne das menschliche Urteil darüber, welche Leads angerufen werden, vollständig zu ersetzen. Salesforce Einsteins Next-Step-Empfehlungen werden manchmal befolgt, von manchen Reps, in manchen Situationen.
Die Kategorie überwachter Agenten ist nützlich, weil sie anerkennt, dass die Copilot-Agent-Unterscheidung ein Spektrum ist, keine Binäre. Aber sie wirft auch die operative Frage auf, die die meisten Käufer nicht stellen: Wie sieht die Review-Architektur aus? Wer überprüft die Aktionen des Agenten, mit welcher Frequenz, und wie leicht ist es, das zu überschreiben oder rückgängig zu machen, was der Agent getan hat?
Unternehmen, die überwachte Agenten deployen, ohne diese Fragen zu beantworten, bekommen ein Ghost-Governance-Problem: Der Agent ist technisch überwacht, aber niemand schaut tatsächlich das Dashboard an, also ist die Aufsicht nominal. Die Governance-Lücke, die agentische KI für CEOs schafft, ist hier eine nützliche Ergänzung; sie zeigt, wie das Aufsichtsversagen aus Sicht der Führungsebene aussieht, wenn überwachte Agenten unbeobachtet bleiben.
Rollen-Design-Implikationen
Die am meisten unterschätzte Konsequenz dieser Unterscheidung ist, was sie mit menschlichen Rollen macht. MIT Sloan Management Reviews Forschung zu KI und der Zukunft der Arbeit stellt konsistent fest, dass Organisationen den erforderlichen Rollen-Redesign unterschätzen, wenn KI von assistiv zu autonom wechselt, der Kompetenzwandel besteht nicht nur darin, "das Tool nutzen zu lernen", sondern darin, "neu zu definieren, für welche Urteilsentscheidungen der Mensch verantwortlich ist".
Wenn Copiloten der Standard sind, ändern sich menschliche Rollen auf Aufgabenebene. Ein Rep, der früher 20 Minuten damit verbrachte, Prospecting-E-Mails zu schreiben, verbringt jetzt 5 Minuten damit, KI-Entwürfe zu bearbeiten. Der Job-Titel bleibt gleich. Die Kompetenzanforderung verschiebt sich leicht in Richtung Urteilsvermögen und Redigieren, weg vom Formulieren. Die Kernstruktur der Rolle bleibt jedoch intakt.
Wenn Agenten autonom im Workflow operieren, ändern sich Rollen auf struktureller Ebene. Wenn ein Agent Lead-Qualifizierung und erste Outreach handhabt, verschwindet die SDR-Rolle nicht. Ihr Umfang verengt sich auf die Aufgaben, die der Agent nicht handhaben kann: komplexe Gespräche, Beziehungsaufbau, den Umgang mit Einwänden, Kontext lesen, der nicht im CRM ist. Manager verbringen weniger Zeit mit dem Monitoring von Aktivitäten und mehr Zeit mit der Überprüfung der Agenten-Output-Qualität und der Bearbeitung von Ausnahmen. Die relevante Skill-Mischung ändert sich erheblich.
Das ist der Grund, warum Agenten ohne ein Rollen-Design-Gespräch zu kaufen ein Fehler ist. Die Technologie funktioniert anders als sie vorher genutzt wurde, was bedeutet, das Team muss auch anders arbeiten. Das Gespräch zu überspringen eliminiert die Rollenänderung nicht. Es macht sie nur unordentlich und unbeabsichtigt. KI-Change-Management-Strategien deckt ab, wie man dieses Gespräch so führt, dass es keinen Widerstand vor Deployment-Start generiert.
Ein praktischer Ansatz: Bevor Sie ein KI-Tool der Agenten-Kategorie deployen, bilden Sie den Workflow ab, in den es eintritt, und identifizieren Sie, welche menschlichen Aufgaben es verändert oder entfernt. Entscheiden Sie dann explizit, was diese Menschen stattdessen tun. Nicht als Drohung, sondern als Designfrage. Die Antwort zeigt oft, dass der Agent Kapazität für höherwertige Arbeit schafft, aber nur, wenn diese Arbeit definiert und ermöglicht wird.
Das Autonomy-Stakes Grid
Ein nützliches Framework für die Zuordnung von KI-Kategorien zu Geschäftsprozessen ist ein einfaches 2×2: Autonomie auf einer Achse (wie viel kann die KI handeln ohne menschliche Genehmigung pro Entscheidung), Stakes auf der anderen (was geht schief, wenn die KI falsch liegt).
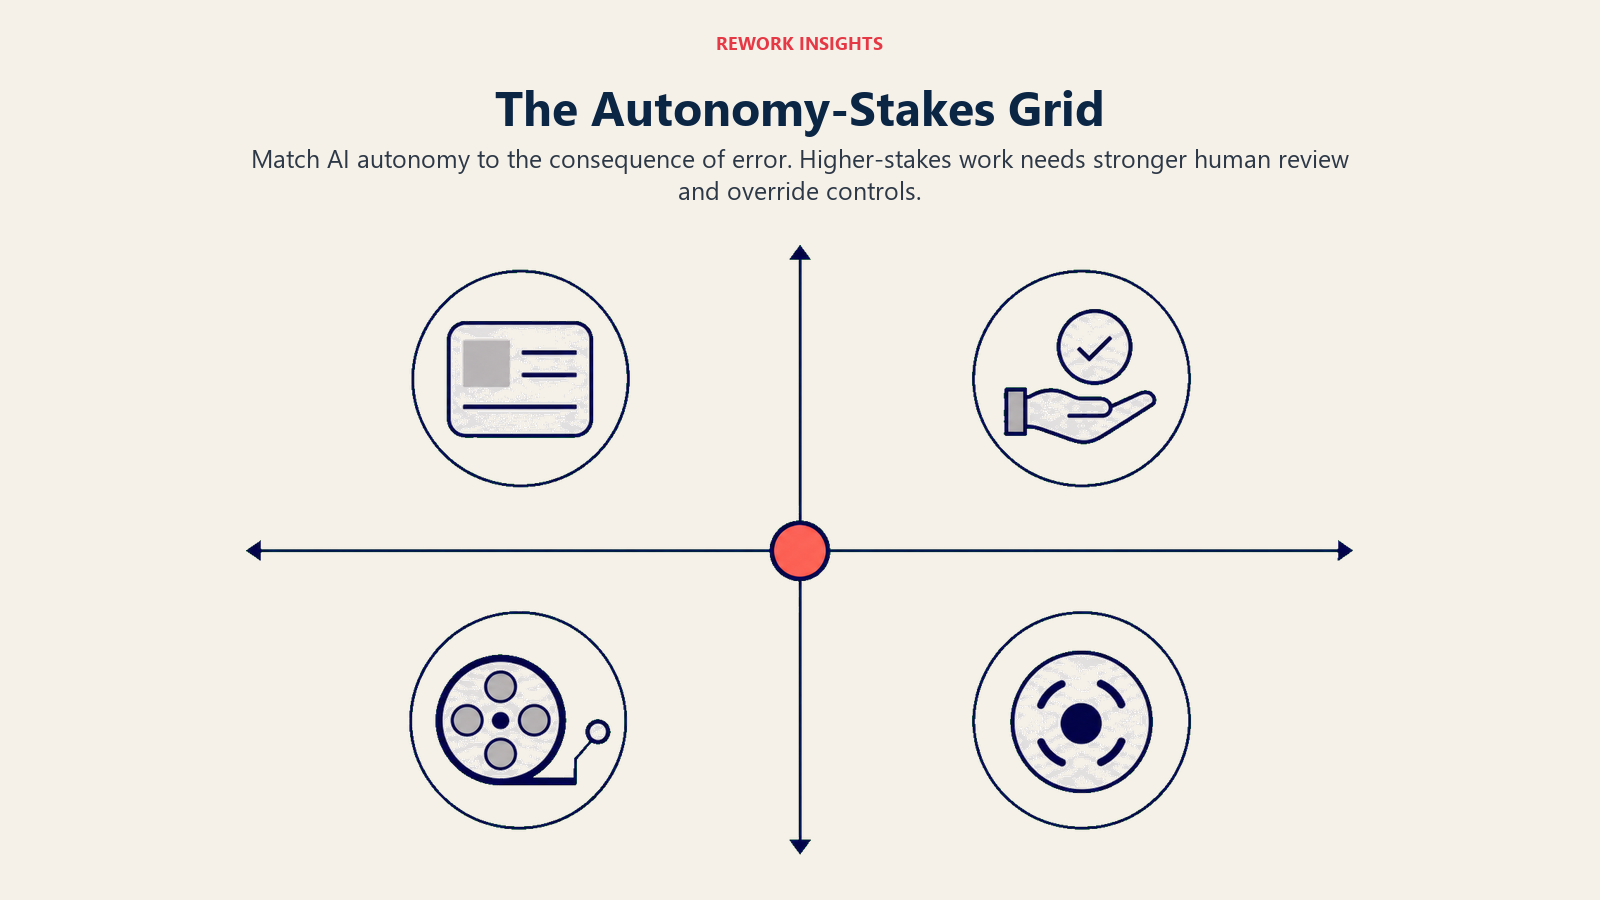
Hohe Autonomie, niedrige Stakes: Gut für vollständige Agenten. Eine Routine-Follow-up-E-Mail an einen warmen Lead senden, Kontaktdatensätze mit angereicherten Daten aktualisieren, Post-Call-Zusammenfassungen generieren. Wenn die KI falsch liegt, ist die Konsequenz gering und leicht zu korrigieren. Vollständige Autonomie ist angemessen.
Hohe Autonomie, hohe Stakes: Erfordert überwachte Agenten mindestens. Eingehende Leads in verschiedene Sales-Tiers weiterleiten, Deal-Wahrscheinlichkeits-Scores anpassen, die Sales-Forecasts informieren, Vertragsverneuerungskommunikationen auslösen. Die Aktion hat materielle Konsequenzen, aber der Umfang des Problems macht vollständige menschliche Überprüfung unpraktisch. Supervised-Agent-Design mit geeigneter Review-Architektur ist die richtige Kategorie.
Niedrige Autonomie, niedrige Stakes: Gut für Copiloten. E-Mails entwerfen, nächste Schritte vorschlagen, Kontakthistorie vor einem Call aufzeigen. Die Stakes sind niedrig genug, dass menschliche Überprüfung nicht belastend ist, und die KI unterstützt, statt zu handeln.
Niedrige Autonomie, hohe Stakes: Copiloten oder stark eingeschränkte überwachte Agenten. Performance-Evaluierungs-KI, rechtliche Dokumentenprüfung, Preisempfehlungen für große Deals. Die Stakes erfordern, dass menschliches Urteil am Entscheidungspunkt in der Schleife ist. KI unterstützt; Menschen entscheiden.
Die meisten KI-Kaufentscheidungen überspringen dieses Mapping-Übung vollständig. Das Ergebnis sind Agenten, die in High-Stakes-, Low-Review-Umgebungen deployed werden, oder Copiloten, die deployed werden, wo Agenten tatsächlich effektiver wären. Gartners Forschung zum KI-Hype-Zyklus platziert autonome KI-Agenten nahe dem Gipfel der überzogenen Erwartungen, und die Anbieter, die volle Autonomie versprechen, verkaufen typischerweise an Käufer, die ihre tatsächliche Risikobereitschaft nicht am Autonomy-Stakes Grid gemessen haben. Das 2×2 dauert etwa 30 Minuten, um für einen spezifischen Workflow zu vervollständigen, und spart Monate von Implementierungsproblemen.
Wie CRM-KI-Features auf das Spektrum abgebildet werden
Es ist wert, spezifisch darüber zu sein, wo die wichtigsten CRM-KI-Features liegen, weil die Marketing-Sprache nicht immer der operativen Realität entspricht.
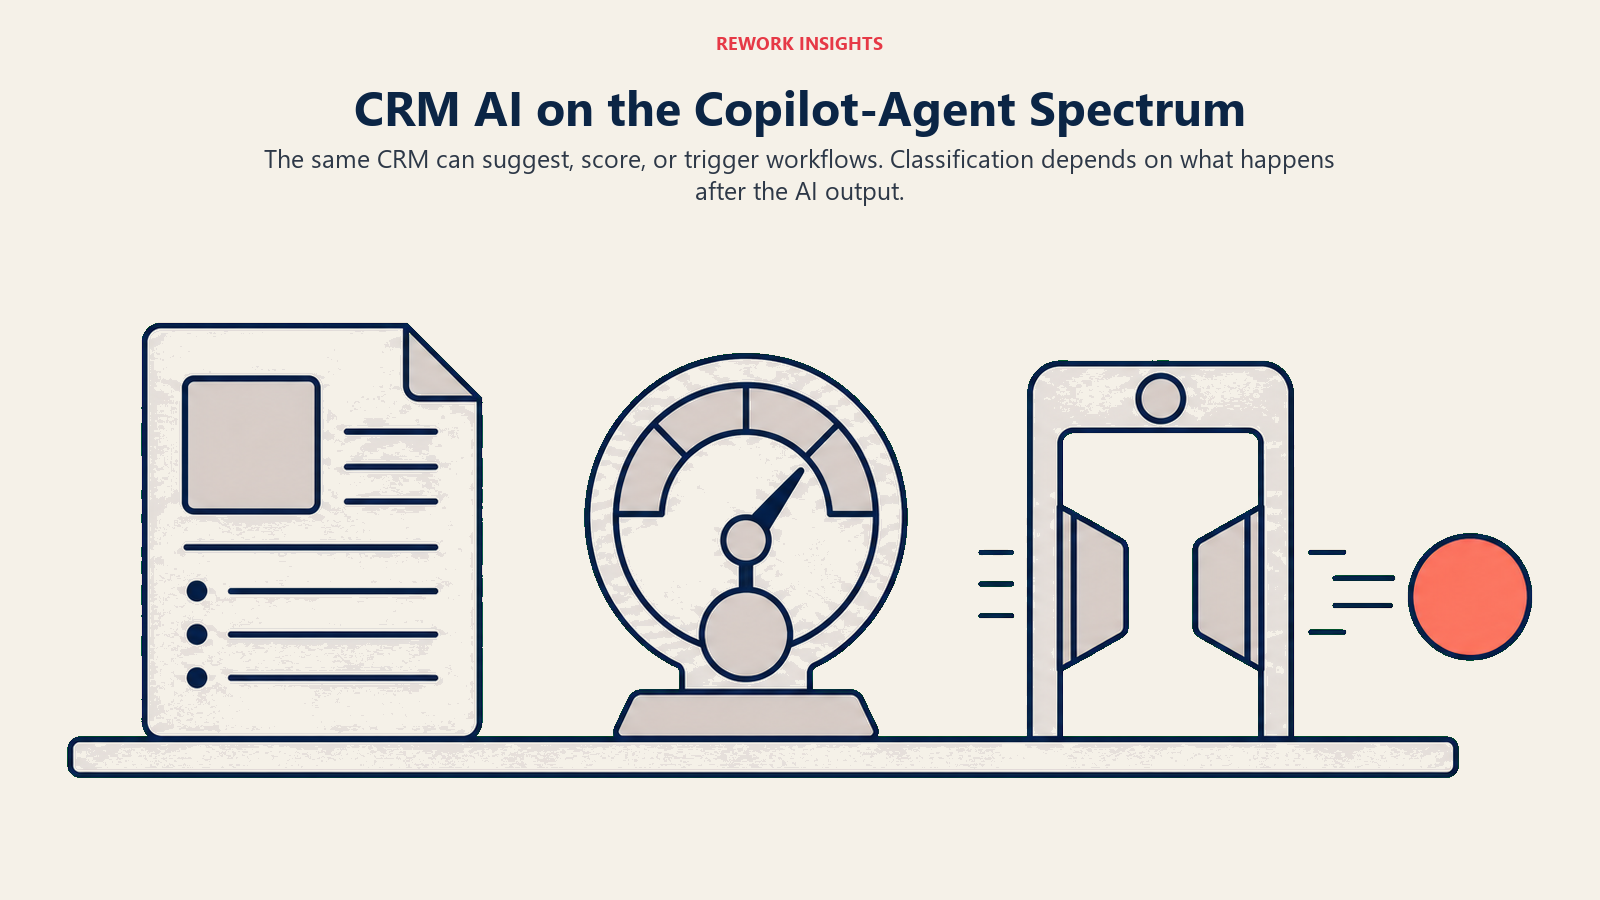
Salesforce Einstein umfasst Features über das gesamte Spektrum. Einstein Conversation Insights (das Call-Transkripte zusammenfasst) ist ein Copilot. Einstein Lead Scoring (das eine Bewertung zuweist, aber nicht darauf handelt) ist auch ein Copilot. Einstein Prediction Builder, konfiguriert zum Auslösen von Workflow-Aktionen, ist ein Agent. Dieselbe Plattform vereint mehrere Kategorien von KI-Verhalten, und Käufer sollten identifizieren, welche Features sie deployen und in welche Kategorie jedes fällt.
HubSpot KI überspannt das Spektrum ähnlich. KI-unterstützte E-Mail-Komposition und Meeting-Planungsempfehlungen sind Copiloten. Automatisierte Sequence-Einschreibung basierend auf Lead-Score, der einen Schwellenwert überschreitet, ist ein Agent. Der Unterschied liegt darin, ob zwischen dem KI-Output und der realen Konsequenz eine menschliche Aktion erforderlich ist.
Zoho Zias Fähigkeiten bilden ähnlich ab: Ihre Vorhersagen sind Copiloten, aber ihre Automatisierungsauslöser (wo Zias Analyse direkt einen CRM-Workflow initiiert) sind Agenten.
Das ist keine Kritik an einer Plattform. Es ist eine Beschreibung, wie KI-Features operativ funktionieren, und warum es analytisch falsch ist, alle KI-Features in einem CRM als eine einzige Kategorie zu behandeln.
Drei Fragen an jeden KI-Anbieter
Bevor ein Gespräch mit einem KI-Anbieter endet, lassen Sie sich diese drei Fragen beantworten:
"Führen Sie mich durch, was die KI nach dem Generieren eines Outputs tut. Konkret, was löst die nächste Aktion aus und wer muss sie genehmigen." Diese Frage trennt Copiloten von Agenten in der Praxis. Wenn die Antwort "der Benutzer überprüft und handelt" ist, ist das ein Copilot. Wenn die Antwort "das System tut automatisch..." ist, ist das ein Agent. Anbieter beschreiben Agenten manchmal als Copiloten, um die Sorgen der Käufer zu verringern. Diese Frage macht die operative Realität sichtbar.
"Wie sieht Ihre Überprüfungs- und Override-Oberfläche aus?" Bitten Sie, es zu sehen, nicht davon zu hören. Jeder überwachte Agent, der sich lohnt deployed zu werden, hat einen funktionalen, sichtbaren Audit-Trail und Override-Mechanismus. Wenn der Anbieter Mühe hat, Ihnen das zu zeigen, ist die Review-Architektur unterentwickelt.
"Was ist Ihre empfohlene Implementierungssequenz für ein Unternehmen, das noch keine KI-Agenten deployed hat?" Erfahrene Anbieter beschreiben einen phasenweisen Ansatz: mit Copiloten-Features beginnen, organisatorische Vertrautheit mit KI-Outputs aufbauen, dann überwachte Agenten mit Oversight einführen, dann zur vollständigen Agenten-Autonomie bei Low-Stakes-Workflows übergehen. Anbieter, die empfehlen, mit vollständiger Autonomie in komplexen Workflows zu beginnen, optimieren für ihre Deployment-Metriken, nicht Ihre Ergebnisse.
Die Copilot-Agent-Unterscheidung wird nicht statisch bleiben. Mit wachsendem Vertrauen in KI-Systeme und reifenden Oversight-Architekturen wird die überwachte Agenten-Kategorie expandieren. Mehr Entscheidungen, die derzeit menschliche Überprüfung erfordern, werden zu überwachter Autonomie wechseln. Aber diese Verschiebung sollte bewusst und durch operative Erfahrung mit jeder Kategorie informiert sein, nicht durch Anbieter-Roadmaps oder Wettbewerbsdruck.
Die Unternehmen, die jetzt echte Kompetenz im Umgang mit KI aufbauen, sind diejenigen, die verstehen, welche Kategorie von Technologie sie tatsächlich deployen, was sie zum Funktionieren braucht und welche Rolle Menschen im System spielen, das sie bauen. Das beginnt damit, den Unterschied zwischen Copiloten und Agenten präzise zu fassen.
Mehr erfahren
