More in
リードキャプチャ自動化
チャットからCRMへの自動化:Respond.ioとHubSpotの連携(2026年版Playbook)
4月 18, 2026
LinkedIn Lead Gen FormsからCRMへ:確実に機能する自動ルーティング
4月 18, 2026
チャットでキャプチャしたリードのスコアリング:フォームリードとは異なるモデル
4月 18, 2026
Webhookベースのリードキャプチャ:カスタム統合のための実践ガイド
4月 18, 2026
チャット会話のコンテキストに基づいたリードの担当者ルーティング
4月 18, 2026
キャプチャ後のナーチャリングシーケンス自動化:ファーストタッチからセールスレディまで
4月 18, 2026
EUマーケット向けGDPR準拠のリードキャプチャ:実践的なオペレーションガイド
4月 18, 2026
フォームなしリードキャプチャスタックの構築:フォームを一切使わずにリードを獲得する方法
4月 18, 2026
チャット・広告・フォームリード全体のソースアトリビューション追跡:Opsチームのためのオペレーションガイド
4月 18, 2026
プレミアムコネクタなしでCMSフォームをSalesforceに接続する方法
4月 18, 2026
リードエンリッチメント自動化:レコードあたりの費用なしにギャップを埋める
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
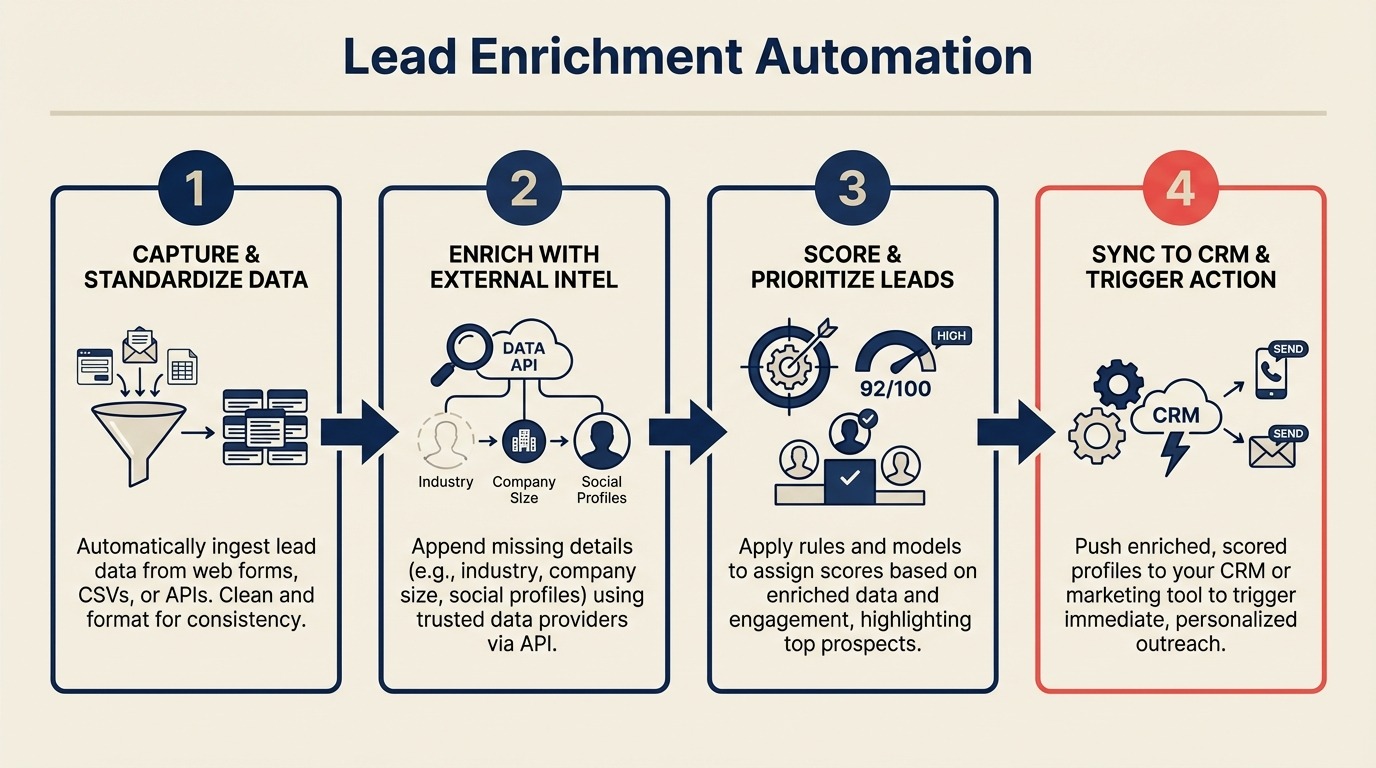
名前とメールだけを要求するリード獲得フォームは、担当者が優先できないCRMレコードを作成します。フォーム送信から30秒以内に発火するリードエンリッチメントワークフローは、会社、役割、業種、従業員数を自動的に追加します。担当者が開くのは、正体不明のレコードではなく情報の揃ったレコードです。
データエンリッチメントとは、社内外のソースから追加のコンテキストを加えて、生データを強化、精緻化、改善するプロセスです。B2Bのリードジェネレーションでは、通常、メールドメインや会社名をもとにコンタクトレコードへファーモグラフィックデータやテクノグラフィックデータを付加することを指します。
あるRevOpsチームは月に4,000件のリードに対してレコードあたりのエンリッチメントに毎月3,200ドルを費やしていました。カバレッジは良く、レコードの約85%がエンリッチされました。しかし実際にリードスコアリングとルーティングに影響したエンリッチされたフィールドを分析すると、支出の80%がスコアリングモデルが使用しなかったフィールドに使われていたことが分かりました。マスターデータ管理に関するGartnerのガイダンスも同じ点を指摘しています。エンリッチメントの価値は、下流のプロセスがエンリッチされたフィールドを取り込んで活用するよう設計されている場合にのみ実現します。リード品質に対してエンリッチメント投資を合わせた段階的なアプローチに切り替えた後、同じカバレッジで月400ドルになりました。
その段階的なアプローチの構築方法を紹介します。
ステップ1:実際に重要な6つのフィールド
エンリッチする前に、何のためにエンリッチするかを知ってください。全てのCRMフィールドが同等ではありません。これらの6つはリードスコアリングとルーティングの決定に最も高い影響を持ちます:
- 企業規模(従業員数):最も一般的なICPフィルター。ほとんどのB2Bルーティングルールは企業規模を使用してエンタープライズ対SMBの担当者を割り当てます。
- 業種:2番目に一般的なICPフィルター。どの製品メッセージとユースケースが適用されるかを決定します。
- シニオリティレベル:C-LevelとVPのリードは個人の貢献者とは異なる扱いを受けます。これはスコアリングとルーティングの両方に供給します。
- LinkedIn URL:担当者コールの前の手動リサーチを可能にし、ソーシャルセリングワークフローを強化します。
- テクノロジースタック:プロスペクトがSalesforceまたはHubSpotを使用しているかを知ることでピッチが変わります。ClearbitとApolloはこれを公開データから取得します。
- 資金調達ステージ:スタートアップに売るB2B SaaSにとって、企業が過去6ヶ月にシリーズBを調達したことを知るのは高インテントシグナルです。
この6つから先にエンリッチします。それ以降のフィールドは、下流の実際の決定に影響することを確認できた後にのみ追加します。これらのフィールドをクリーンに受け取るようにCRMデータモデルが設定されていない場合、CRMデータモデルデザインはスケールでエンリッチメントを実行する前のカスタムプロパティの構造化方法をカバーしています。カスタムフィールドガイドでは、エンリッチメントの書き戻しに影響する命名規則とフィールドタイプの選択をさらに掘り下げています。
ステップ2:無料のエンリッチメントソース
何かにお金をかける前に、少量には正当な無料のエンリッチメントオプションがあります:
Clearbit Reveal(IPベースの会社データ、無料ティア): Clearbit RevealはIPアドレスに基づいて匿名のウェブサイト訪問の背後にある会社を特定します。誰かがサイトのフォームを送信したとき、そのIPをRevealに渡して個人メールのみを提供した場合でも会社名、規模、業種を取得できます。無料ティアは月100リビールまでカバーします。メールベースのAPIを呼び出す前の最初の段階エンリッチメントレイヤーとして便利です。
Hunter.io ドメイン検索(無料ティア): 会社名があるがメールがない場合、Hunter.ioのドメイン検索はそのドメインのメールパターンを見つけます。会社名を提供したがGmailアドレスを使用したフォーム送信のエンリッチメントに便利です。無料ティアは月25検索までです。
LinkedIn Sales Navigator(リサーチ、APIではない): LinkedInアカウントを持つ誰でも無料。スケールでの自動化はできませんが、担当者コールの前の高価値リードの手動エンリッチメントに便利です。企業規模のしきい値を超えるリードに対してLinkedInを確認するよう担当者に促すワークフローステップを含めます。
無料エンリッチメント決定テーブル:
| シナリオ | 無料ツール | 取得できるもの |
|---|---|---|
| ビジネスメール付きフォーム送信 | Apollo.io無料ティア | 会社、規模、業種、LinkedIn |
| Gmail/Yahoo付きフォーム送信 | Clearbit Reveal(IP) | IPアドレスからの会社 |
| 会社名は分かる、メールは不明 | Hunter.ioドメイン検索 | ドメインのメールパターン |
| 高価値リード、手動リサーチ | LinkedIn(手動) | 役割、在職期間、最近のアクティビティ |
ステップ3:フリーミアムから有料のエンリッチメントツール
月数百件以上のリードを処理したら、APIアクセス可能なエンリッチメントサービスが必要です。重要なボリューム階層での価格比較を紹介します:
Apollo.io エンリッチメントAPI: Apollo.ioのエンリッチメントAPIは主要なエンリッチメントツールの中で最も寛大な無料ティアを持ちます:無料プランで月60件のメールエクスポートが可能です。有料プランは個人使用で月49ドルから始まり、チーム向けでは月99ドルまで上がります(2026年初頭時点)。米国と西ヨーロッパでのカバレッジは強く、東南アジアとLATAMでは弱いです。
Clearbit エンリッチメントAPI: メールベースのルックアップで個人とその会社に関する85以上のデータポイントを返します。価格は使用量ベースで、低量ではレコードあたり約0.10〜0.15ドル、規模が大きくなるにつれて下がります。テクノロジー企業とSaaS企業のカバレッジが最も優れています。伝統的な業種では強くありません。
People Data Labs(PDL): People Data LabsはバルクエンリッチメントとAPIアクセスを提供します。レコードあたりの価格:スケール(10k以上のレコード)で約0.05〜0.08ドルです。リアルタイムエンリッチメントより既存レコードのバッチエンリッチメントに適しています。グローバルカバレッジが強いです。
ボリューム階層での価格比較:
| ツール | 月1,000リード | 月5,000リード | 月10,000リード |
|---|---|---|---|
| Apollo.io | 〜$49/月(チームプラン) | 〜$99/月 | 〜$99〜149/月 |
| Clearbit | 〜$150/月 | 〜$500/月 | 〜$900/月 |
| People Data Labs | 〜$50/月 | 〜$200/月 | 〜$400/月 |
| Clearbit Reveal(IP) | 無料(100/月) | $199/月 | $499/月 |
Apolloは月5,000件未満のほとんどのチームにとって適切なデフォルトです。一度に数万件を処理する必要がある既存のレコードのバルクエンリッチメントにはPDLに切り替えます。エンリッチメント自動化そのもののミドルウェアをまだ選んでいるチームには、Zapier vs n8n vs Make比較が、各ボリューム帯で条件付きエンリッチメントロジックを最もうまく扱えるツールをカバーしています。
ステップ4:エンリッチメント自動化の構築
エンリッチメント自動化は新しいCRMコンタクトが作成された直後に発火します。フローを紹介します:
トリガー:CRMで新しいコンタクトが作成された
  → 確認:メールはビジネスドメインか?(GmailやYahooではない)
    → はい:メール付きのエンリッチメントAPIを呼び出す
      → APIがデータを返す
        → CRMフィールドを更新(空の場合のみ、上書きしない)
        → エンリッチメントソースと信頼スコアをログ
        → エンリッチメントがデータを返さなかった場合はフラグ
    → いいえ:送信IPアドレスでClearbit Revealを呼び出す
      → 信頼度 > 70%の場合、会社フィールドを更新
Makeでの構築:
- トリガーモジュール:「HubSpot(またはSalesforce)で新しいコンタクトを監視」
- フィルターモジュール:メールが一般的な個人ドメインではないことを確認
- HTTPモジュール:パラメータとしてメールを含むApollo.io People EnrichmentエンドポイントにPOST
- ルーターモジュール:エンリッチメントデータが返ったかどうかで分岐
- HubSpotモジュール:コンタクトを更新(「空の場合に更新」フィールドロジックを使用)
- ログモジュール:結果をGoogleスプレッドシートまたはデータストアに書き込みます
N8nでの構築: 同じフローはHTTP RequestノードでエンリッチメントAPIを呼び出してIFノードでデータの利用可能性で分岐するN8nでも機能します。N8nのここでの利点は、Makeのモジュール制限に引っかからずにより高度なフィールドマッピングロジックと信頼スコアロジックを書けるネイティブのPython/JavaScriptコードノードです。
Zapierでの構築: ZapierはApolloとClearbitを名前付き統合として持ち、初期セットアップが速いです。しかし条件付きロジック(空の場合のみ更新、信頼スコアで分岐)については、Zapierの制限に素早く到達します。シンプルな単一ステップエンリッチメントにZapierを使用し、分岐が必要になったらMakeまたはN8nに移行します。
ステップ5:チャット経由で獲得したリードのエンリッチメント
WhatsAppまたはRespond.ioからのチャットリードは電話優先です。電話番号はありますが、必ずしもメールがあるわけではありません。これはメールベースのリードとは異なるエンリッチメントパスが必要です。
電話優先のエンリッチメントオプション:
- リバース電話ルックアップサービス(NumLookup、AbstractAPI Phone Validation):番号が実在することを確認してキャリア/地域を取得
- フローを閉じる前にチャットでメールをリクエスト:「詳細を送るためのメールも教えていただけますか?」
- メールを収集した後に、フォームリードと同様にエンリッチ
チャット経由で獲得したほとんどのリードに対する実践的なアプローチ:会話コンテキスト(チャット自体に会社名、役割、ユースケースが含まれていることがよくあります)からエンリッチできるものをエンリッチし、その後フォローアップメッセージでメールを促して標準のメールエンリッチメントを実行できるようにします。
CRMへのチャットリードの接続に関する完全なガイドはスケールするフォームからCRMへの自動化パターンを参照してください。Respond.ioを使用しているチームはフィールドマッピングの詳細についてはRespond.ioとHubSpotの統合ガイドも確認してください。また、電話番号優先のリードは重複排除に十分なデータがないまま届くことが多いため、マルチチャネルリードの重複排除では、エンリッチメントの実行前にそれらを既存のコンタクトと照合する方法をカバーしています。
ステップ6:エンリッチメント信頼スコア
全てのエンリッチメントデータが同様に信頼できるわけではありません。ApolloはデータマッチングをConfidenceスコアで評価します。ClearbitはIPから導出された会社マッチングにfuzzyフラグを含みます。People Data Labsはフィールド精度の尤度スコアを提供します。
信頼スコアを実際にどう使うか:
- 信頼度 > 85%: CRMフィールドに書き込み、フィールドが空の場合のみ上書き
- 信頼度 60〜85%: 別の「enrichment_suggested」フィールドに書き込み、レビューのためにフラグを立てます
- 信頼度 < 60%: 試みをログし、CRMには書き込みません
これにより低信頼度のエンリッチメントがリードスコアリングを汚染するのを防ぎます。「51〜200名」の企業規模に40%の信頼度でリードをエンタープライズとスコアリングしてエンタープライズの担当者割り当てをトリガーするのは、全く企業規模がないよりも悪いです。
Makeでは、APIレスポンスの信頼スコアフィールドを確認して異なる更新ロジックに分岐するルーターモジュールとしてこれを実装します。
ステップ7:コスト最適化
全てをエンリッチするのではなく、よりスマートにエンリッチします:
最低品質しきい値以上のみエンリッチします: プレースホルダーメール、既知のスパムドメイン、または欠損名前のリードをエンリッチしません。これらのレコードはエンリッチメントデータに関係なくコンバートしません。エンリッチメントAPI呼び出しの前にそれらをフィルタリングします。
リードソースでエンリッチメントを段階化する: Meta Lead Adの送信は軽いエンリッチメントを受けます(Clearbit RevealからIPで会社規模、業種)。インバウンドのデモリクエストは完全なエンリッチメントを受けます(6つの優先フィールドすべてとテクノロジースタック)。コストの差は大きく、ROIの差はさらに大きいです。
歴史的レコードのバッチエンリッチメント: エンリッチメントワークフローが設置される前に作成された既存のCRMレコードにはPeople Data Labsのバッチエンリッチメントを使用します。リアルタイムフローを経由せず、バルク価格で一度に実行します。
ICPフィットによるエンリッチメント: エンリッチメントの前に基本的なICPフィルターを構築します:メールドメインがサービスを提供していない国からのものであれば、またはフォームの回答がICPの外(最低限以下の企業規模、ターゲットリストにない業種)を明確に示していれば、エンリッチメントを完全にスキップします。EUで事業を行うチームは、エンリッチメントの設定をデータ処理に関するGDPRの要件に照らして見直すべきです。サードパーティのソースから個人データを付加するエンリッチメントには、第6条に基づく適法な根拠が必要になります。フィルター基準を経時的に見直せるようにスキップをログに残します。
よくある落とし穴
手動入力されたデータの上書き。 担当者が会社名を「Acme Corp」から「Acme Corporation Ltd.」に修正しました。エンリッチメント自動化が発火して元に戻してしまいます。エンリッチメントフィールドには常に「空の場合のみ更新」ロジックを使用します。
品質に関係なく全てのリードをエンリッチします。 これが3,200ドル/月の問題の原因です。品質しきい値はエンリッチメントコールの後ではなく前に設定します。
CRMに書き込む前に信頼スコアチェックなし。 低信頼度のデータはしばしば間違っています。CRMにエンリッチメントデータを書き込む前に信頼度の分岐ロジックを実装します。
レコード作成の失敗を引き起こすエンリッチメントAPIのタイムアウト。 エンリッチメントが同期的(CRMレコード作成がエンリッチメント完了を待つ)であれば、遅いAPIレスポンスがフロー全体の失敗を引き起こす可能性があります。エンリッチメントを非同期にします:最初にCRMレコードを作成し、その後別のステップでエンリッチします。
フォームリードと同じようにチャットリードを扱います。 電話優先のリードは異なるエンリッチメントパスが必要です。標準のメールエンリッチメントフローがそれらをカバーすると仮定しないでください。
次のステップ
リードスコアリングとルーティングルールに最も高い影響を持つCRMフィールドの3つを特定します。ほとんどのB2Bチームにとって、それは企業規模、業種、シニオリティです。現在受信リードのその中のフィールドが入力されている割合を確認します。60%を下回っている場合、そのギャップはリード品質にコストをかけており、エンリッチメントが直接の修正です。フィールドカバレッジが低いことはまたRevOpsチームで帰属が壊れる主要な理由の一つでもあります。エンリッチメントを修正すると直接レポートの精度が改善します。エンリッチメントデータをクリーンに反映させるためのフィールドマッピングの判断については、フィールドマッピングガイドがこのワークフローを実践的に補完します。
Apollo.io無料ティアとシンプルなMakeシナリオから始めます。完全な6つに拡張する前にその3つのフィールドのカバレッジを取得します。前後のスコアリングとルーティング精度を測定します。改善は通常2週間以内に見えてきます。
関連リンク