Alertes de suivi d'usage : un système d'alerte précoce pour prévenir le churn
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
En croissance SaaS B2B, les alertes de suivi d'usage sont des déclencheurs automatisés qui signalent les comptes dont l'activité dans le produit passe sous un seuil sain, afin que le Customer Success puisse intervenir avant le churn. Comme les comptes fidélisés et en expansion génèrent l'essentiel du revenu récurrent, repérer tôt le désengagement protège la net revenue retention à moindre coût que la conquête de nouveaux logos. La suite de ce guide présente les signaux à suivre, la façon de fixer les seuils et les réponses à y apporter.
La plupart des départs de clients sont prévisibles. Les clients qui résilieront le mois prochain envoient dès maintenant des signaux, à travers la manière dont ils utilisent votre produit. Pourtant, la majorité des entreprises SaaS ne les remarquent qu'après coup, quand il est trop tard pour agir.
Les alertes de suivi d'usage font passer le Customer Success d'une posture réactive à une posture proactive. Au lieu de découvrir le churn à la réception de l'avis de résiliation, vous détectez le risque des semaines, voire des mois plus tôt, quand il reste encore du temps pour intervenir efficacement grâce aux méthodes de détection du risque de churn.
Ce guide vous montre comment bâtir des systèmes de suivi d'usage complets, qui servent de dispositif d'alerte précoce sur la santé de vos clients. Vous verrez quelles métriques surveiller, comment fixer des seuils pertinents et comment intégrer les alertes à des workflows d'intervention efficaces.
Pourquoi les signaux d'usage comptent le plus
Les enquêtes de satisfaction vous disent ce que pensent les clients. Les tickets de support vous disent où ils bloquent. Les données d'usage, elles, vous disent ce qu'ils font réellement, et les données comportementales sont le meilleur prédicteur du churn à venir.
Quand les clients cessent de se connecter, quand ils abandonnent les fonctionnalités clés, quand leur activité tombe sous leurs normes historiques, ces comportements révèlent le désengagement plus fidèlement que n'importe quelle réponse à une enquête. Les signaux d'usage sont objectifs, continus, et ce sont des indicateurs avancés plutôt que retardés.
La corrélation entre usage et rétention est remarquablement constante d'un produit SaaS à l'autre. Les entreprises qui suivent l'usage de près et interviennent de façon proactive réduisent généralement leur churn de 20 à 40 % par rapport à celles qui se contentent d'un support réactif. L'effet se répercute directement sur la net revenue retention, que les investisseurs surveillent de près.
Mais les données d'usage brutes sont écrasantes. Une entreprise SaaS de taille moyenne peut suivre des centaines de métriques sur des milliers de comptes. L'enjeu est d'identifier les signaux qui comptent le plus et de bâtir des alertes qui font remonter les risques sans créer de bruit. Cela suppose à la fois de la rigueur analytique pour définir des seuils pertinents et de la discipline opérationnelle pour réagir de façon constante quand une alerte se déclenche.
Votre objectif n'est pas de tout surveiller : il est de surveiller les bonnes choses et de réagir efficacement quand les schémas laissent entrevoir un risque. Cela passe par la maîtrise des méthodes de scoring de la santé client, qui replacent l'usage dans une évaluation plus large de la santé du compte.
Les métriques d'usage essentielles à suivre
Toutes les métriques d'usage ne se valent pas. Celles qui comptent le plus dépendent de votre produit, mais certaines catégories se révèlent prédictives de façon constante, quel que soit le modèle SaaS.
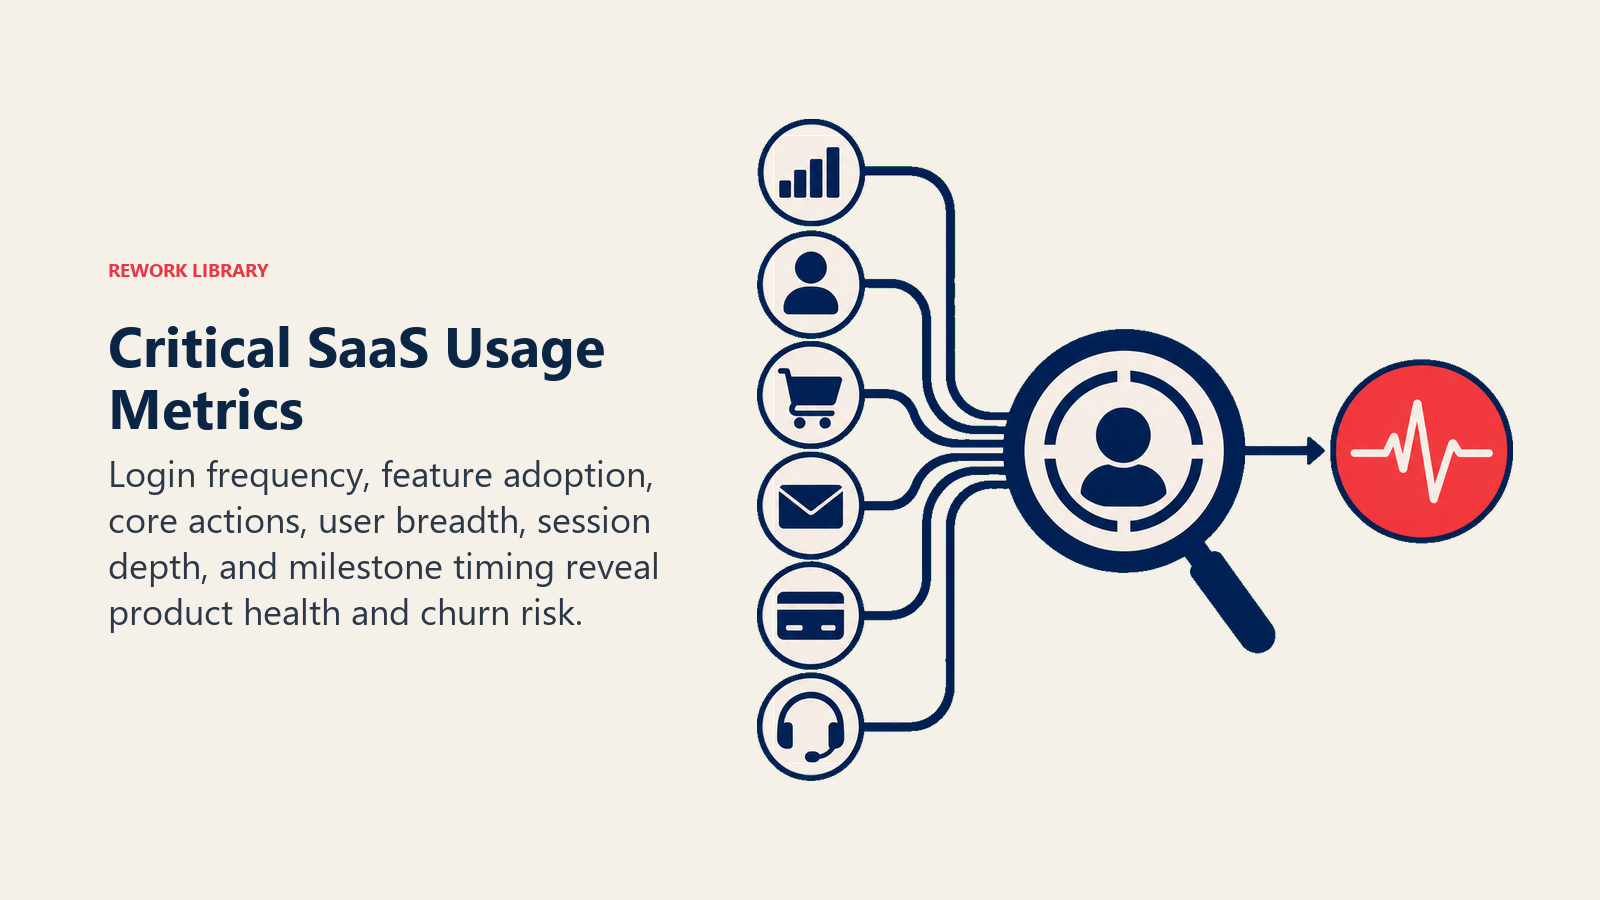
La fréquence de connexion est la base. La régularité avec laquelle les utilisateurs accèdent à votre produit révèle leur engagement de fond. Pour la plupart des produits SaaS, il existe un seuil minimal de connexions en dessous duquel la rétention chute brutalement. Un produit à usage quotidien peut exiger plus de 15 connexions par mois pour un engagement sain, contre 8 à 12 connexions mensuelles pour un produit à usage hebdomadaire.
La profondeur d'adoption des fonctionnalités mesure combien de fonctionnalités clés les clients utilisent régulièrement. Les produits dont l'adoption fonctionnelle est plus élevée affichent systématiquement une meilleure rétention. Si un client n'utilise qu'une ou deux fonctionnalités alors que votre produit en propose dix, il est exposé à un concurrent ou à une coupe budgétaire.
L'accomplissement des actions clés indique si les clients atteignent leurs objectifs importants dans votre produit. Pour un outil de gestion de projet, ce peut être terminer des tâches ou clôturer des projets. Pour un logiciel d'analyse, lancer des rapports ou partager des enseignements. Quand les clients cessent d'accomplir ces actions, c'est qu'ils ne tirent plus de valeur du produit.
L'étendue des utilisateurs au sein d'un compte compte pour les produits d'équipe. Si une seule personne utilise votre outil dans une organisation, vous êtes vulnérable. Quand l'usage se diffuse entre équipes et départements, vous vous intégrez aux processus de travail et devenez beaucoup plus difficile à remplacer.
La durée et la profondeur des sessions renseignent sur la qualité de l'engagement. Les utilisateurs passent-ils un temps significatif dans le produit, ou ne font-ils que passer brièvement ? Parcourent-ils plusieurs rubriques, ou ne visitent-ils qu'une seule page ? La dégradation de la qualité des sessions précède souvent l'abandon pur et simple.
Les métriques de time-to-value révèlent la réussite de l'onboarding. En combien de temps après l'inscription les clients obtiennent-ils leur premier résultat significatif ? Ceux qui atteignent plus vite les jalons de valeur affichent une rétention nettement meilleure. Quand de nouveaux clients n'atteignent pas ces jalons dans les délais prévus, cela signale des problèmes de mise en œuvre qui appellent une optimisation de l'onboarding et du time-to-value.
Pour les modèles de tarification à l'usage, les tendances de consommation sont déterminantes. Une consommation en hausse indique des cas d'usage qui s'élargissent et une valeur qui s'approfondit. Une consommation stable ou en baisse annonce souvent un churn ou un downgrade. Ces schémas se relient directement aux alertes de suivi d'usage qui déclenchent des conversations d'expansion ou de rétention.
Cadres de définition des seuils d'alerte
Pour fixer des seuils d'alerte efficaces, il faut arbitrer entre sensibilité et spécificité. Des seuils trop larges vous font manquer de vrais risques. Des seuils trop serrés créent une lassitude face aux alertes, à cause des faux positifs.
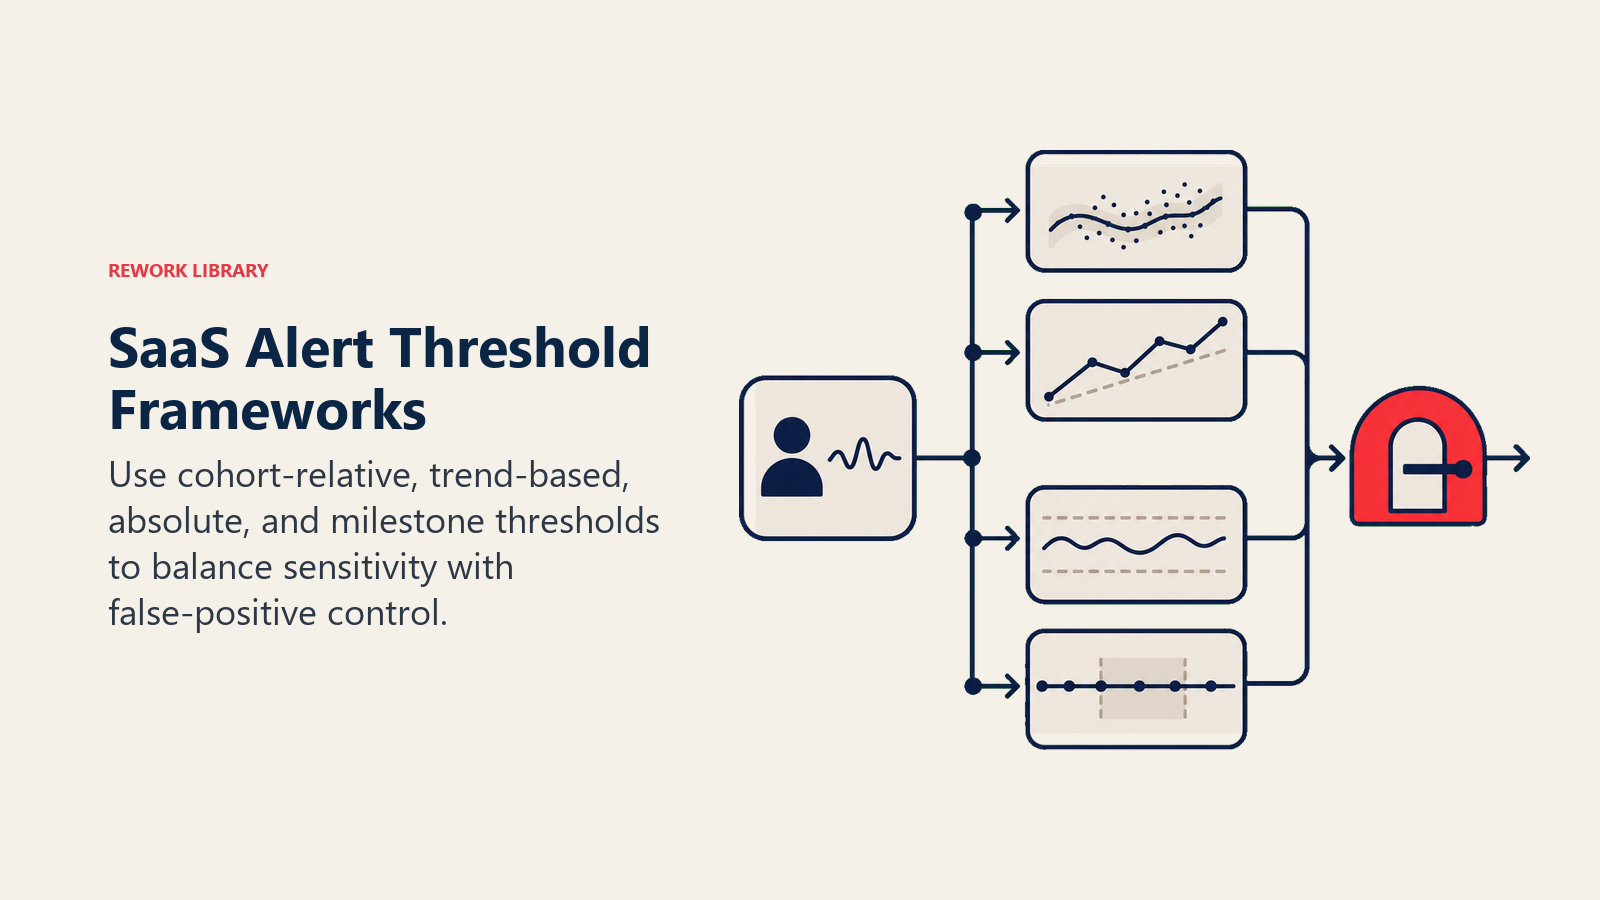
L'approche relative à la cohorte compare le comportement d'un compte aux moyennes de cohortes similaires. Au lieu de seuils absolus, vous signalez les comptes dont les performances sont nettement inférieures à la médiane de leur cohorte. Cela corrige automatiquement les écarts entre segments de clientèle, offres produit ou effets saisonniers.
Par exemple, si le client médian du segment « Mid-Market annuel » se connecte 18 fois par mois, vous pouvez déclencher une alerte lorsqu'un compte tombe sous 60 % de cette médiane (moins de 11 connexions). Cette approche reste valable à mesure que votre produit et votre base clients évoluent.
L'approche par tendance surveille les variations plutôt que les niveaux absolus. Vous suivez si l'usage baisse, à quelle vitesse et depuis combien de temps. Un compte qui passe de 30 à 20 connexions mensuelles ne déclenchera peut-être pas d'alerte sur seuil absolu, mais devrait en déclencher une sur la tendance, car un recul de 33 % trahit un changement de comportement.
Mettez en place des fenêtres de temps glissantes qui comparent l'activité récente à la référence historique de chaque compte. Si l'activité des 30 derniers jours d'un compte est nettement inférieure à sa moyenne des 90 jours précédents, cet écart est significatif, quels que soient les niveaux absolus.
L'approche combinée utilise à la fois des seuils absolus et des tendances relatives. Un compte doit passer sous un minimum absolu et afficher une tendance à la baisse pour déclencher une alerte. Cela réduit les faux positifs liés aux comptes qui ont toujours été peu actifs mais stables, par opposition à ceux qui se désengagent réellement.
Pour les métriques de jalons clés, utilisez un suivi binaire d'accomplissement assorti de seuils de délai. Les nouveaux clients devraient terminer l'onboarding sous 14 jours, atteindre leur première valeur sous 30 jours et adopter une deuxième fonctionnalité sous 60 jours. Quand ces jalons ne sont pas atteints dans les temps, des alertes immédiates permettent d'intervenir tôt. Ces principes s'appuient sur des méthodes de suivi de l'engagement qui mesurent les interactions significatives.
Niveaux de gravité des alertes
Toutes les alertes n'appellent pas la même urgence. Définir des niveaux de gravité aide les équipes à prioriser leurs réponses et évite la lassitude face aux alertes.
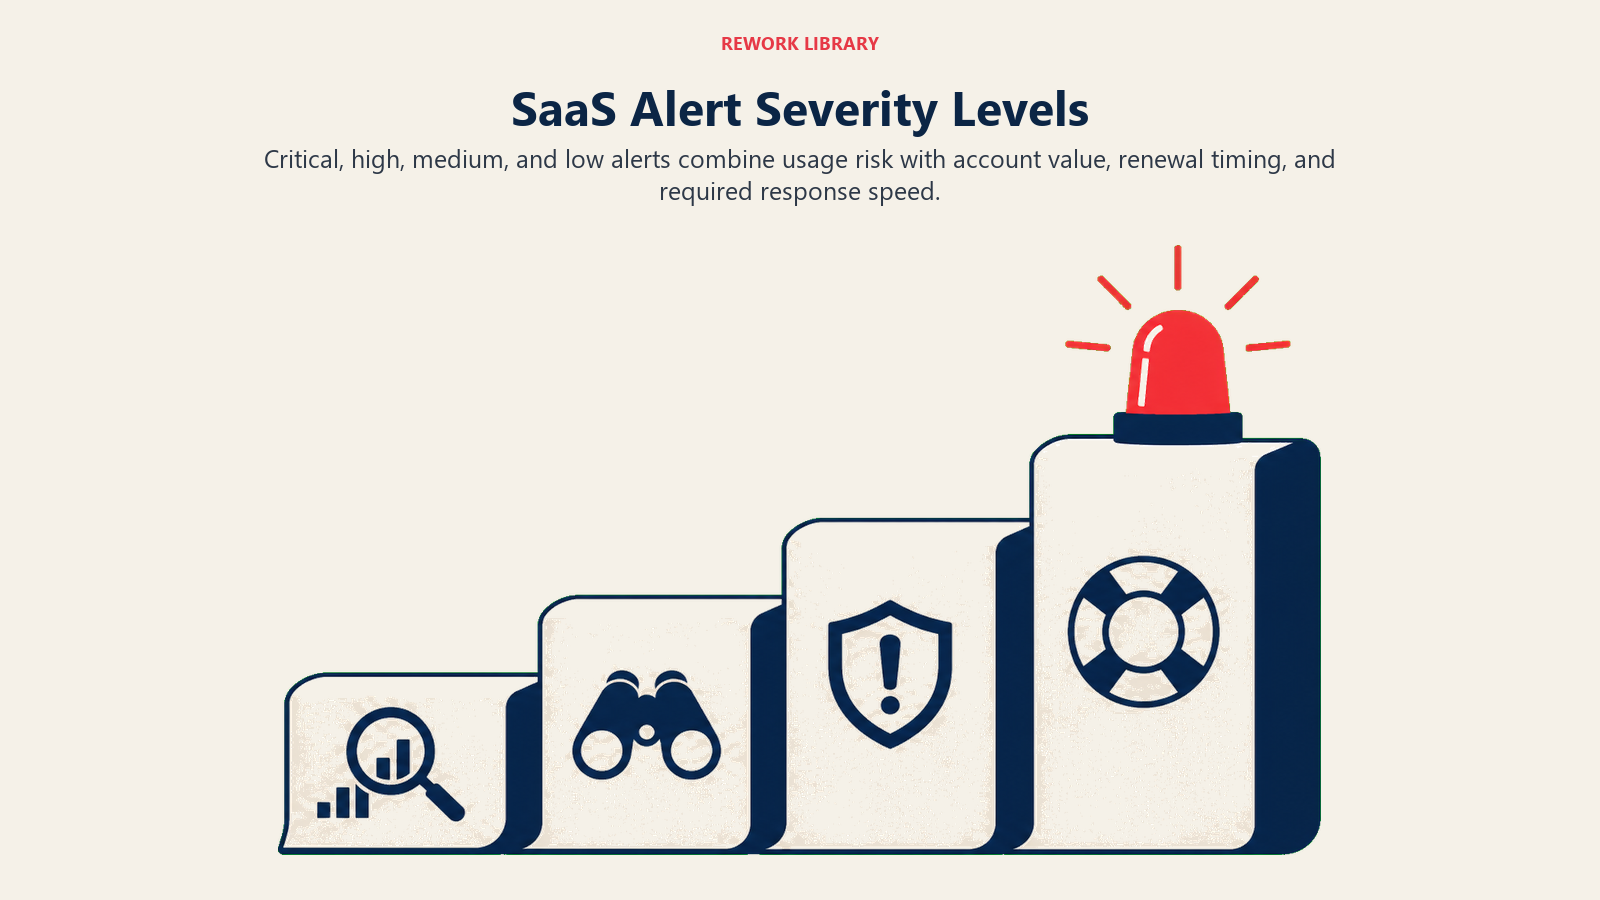
Les alertes critiques signalent un risque de churn immédiat qui exige une intervention le jour même. Elles se déclenchent quand plusieurs facteurs de risque se cumulent : un usage en forte baisse associé à une date de renouvellement proche, ou un abandon complet du produit sur des comptes à forte valeur contractuelle. Une alerte critique doit notifier immédiatement le responsable du compte et peut remonter jusqu'à la direction.
Les alertes de priorité haute révèlent un risque important qui demande une intervention sous 48 heures. Par exemple : une baisse d'usage régulière sur plusieurs semaines, des jalons d'onboarding clés non atteints, ou une dépendance à un seul utilisateur dans des comptes d'équipe. Ces comptes nécessitent une prise de contact proactive, sans être en danger immédiat.
Les alertes de priorité moyenne signalent des signes avant-coureurs qui méritent un suivi et, le cas échéant, une prise de contact proactive : un compte légèrement en dessous des moyennes de sa cohorte, ou une baisse progressive de l'adoption des fonctionnalités. Elles n'exigent pas forcément d'intervention immédiate, mais doivent être signalées pour le prochain point régulier ou intégrées à des parcours de nurturing.
Les alertes de priorité basse servent d'information plutôt que de déclencheur d'action. Elles peuvent alimenter des séquences d'e-mails automatisées ou le calcul d'un score de santé global, sans intervention humaine. Ce sont des schémas à suivre, mais pas assez urgents pour mobiliser immédiatement l'attention d'un CSM.
La gravité de vos alertes doit tenir compte à la fois de l'intensité du schéma d'usage et des caractéristiques du compte. Un petit compte dont l'usage baisse modérément peut relever d'une priorité basse, alors qu'un grand compte présentant le même schéma peut être critique. La valeur du contrat, la date de renouvellement, le potentiel d'expansion et l'importance stratégique modulent tous la gravité de base.
Documentez des protocoles de réponse clairs pour chaque niveau de gravité. Qui est notifié ? Quel délai de réponse est attendu ? Quelles interventions sont standard ? Cette clarté évite que les alertes soient ignorées et garantit des opérations de Customer Success cohérentes. Ces workflows s'intègrent aux approches de Customer Success proactif, qui anticipent les besoins des clients.
Protocoles de réponse selon le type d'alerte
Un suivi efficace ne se limite pas à détecter les problèmes : il faut aussi y répondre de façon cohérente. Élaborez des playbooks standardisés pour chaque type d'alerte, qui précisent qui répond, dans quel délai et quelles interventions sont appropriées.
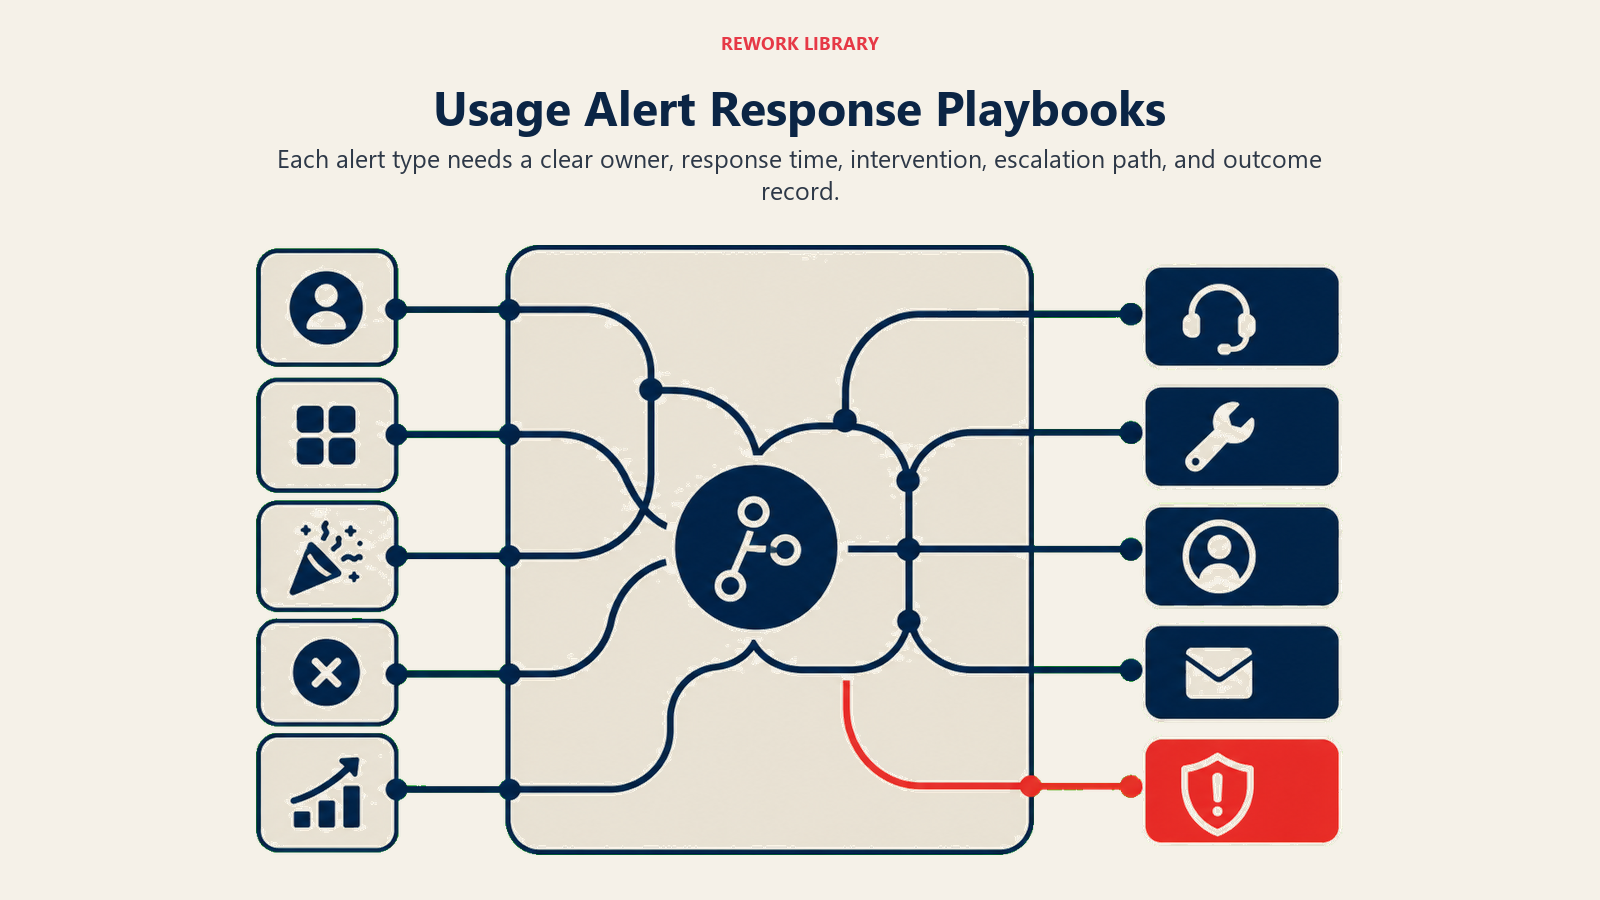
Pour les alertes de fréquence de connexion, commencez par une réactivation peu intrusive : des e-mails déclenchés qui demandent au client s'il a besoin d'aide, mettent en avant de nouvelles fonctionnalités ou partagent un contenu pertinent. Si l'e-mail ne relance pas l'usage en une semaine, passez à un contact direct du CSM. L'objectif est de comprendre ce qui a changé et de lever les obstacles à la reprise d'usage.
Les alertes d'adoption des fonctionnalités appellent une intervention pédagogique. Les clients qui n'utilisent pas les fonctionnalités clés n'en saisissent probablement pas la valeur ou ne savent pas bien s'en servir. Les protocoles de réponse devraient inclure des offres de formation ciblées, des démonstrations vidéo personnalisées ou des sessions d'onboarding dédiées. Présentez-les comme un plus, pas comme un « vous vous y prenez mal ».
Les alertes de jalons d'onboarding demandent une attention immédiate, car les clients en début de parcours sont les plus vulnérables. Quand de nouveaux clients n'avancent pas dans la mise en œuvre, affectez des ressources dédiées pour accélérer leur réussite : accompagnement concret à la mise en place, gestion de compte temporaire ou assistance technique.
Les alertes de baisse d'usage se prêtent à une approche de conseil. Ne vous contentez pas de demander « pourquoi ne vous connectez-vous plus ? ». Ouvrez plutôt une discussion de type revue d'activité : « Nous avons remarqué que votre usage a changé. Quelque chose a-t-il évolué dans votre organisation ou vos priorités ? Comment mieux répondre à vos besoins actuels ? »
Cela place la conversation sur leur réussite plutôt que sur vos métriques. Souvent, une baisse d'usage reflète une évolution des besoins de l'entreprise, qui ouvre des possibilités d'expansion vers d'autres cas d'usage ou d'autres départements.
Les alertes d'adoption multi-utilisateurs exigent une cartographie stratégique des relations. Si une seule personne utilise votre produit, il faut comprendre le contexte de l'organisation. D'autres équipes devraient-elles s'impliquer ? Quels freins empêchent une adoption plus large ? Pouvez-vous obtenir d'être présenté aux parties prenantes concernées ?
Pour les alertes critiques proches du renouvellement, combinez plusieurs leviers : contact direct au niveau de la direction, ressources de réussite dédiées, éventuelle souplesse contractuelle et démonstration claire de la valeur. Ces situations à fort enjeu justifient un engagement multi-interlocuteurs.
Chaque protocole de réponse doit prévoir des exigences de documentation. Consignez les déclencheurs d'alerte, les tentatives de contact, les retours du client et les résultats. Ces données améliorent les seuils d'alerte et les stratégies de réponse futurs, tout en garantissant la continuité quand le responsable du compte change. Ces protocoles de réponse reposent sur les principes d'un cadre de réduction du churn complet, qui identifie les clients à risque.
Prévenir les faux positifs
Un système d'alerte perd sa crédibilité quand il sonne le faux départ à répétition. Les faux positifs érodent la confiance dans les dispositifs de suivi et conduisent à une lassitude où les équipes ignorent les avertissements.
La prise en compte du contexte réduit nettement les faux positifs. Les activités saisonnières peuvent présenter des schémas d'usage qui semblent inquiétants alors qu'ils sont normaux. Les périodes de congés influencent l'usage de nombreux produits. Intégrez ces schémas à la logique de vos seuils plutôt que de traiter toutes les périodes de la même façon.
Des références propres à chaque segment évitent de comparer des choses qui n'ont rien à voir. Les schémas d'usage diffèrent fortement selon les segments de clientèle, la taille des entreprises et les secteurs. Ce qui est sain pour une petite équipe peut être préoccupant pour un grand compte. Construisez des cadres de seuils distincts pour chaque segment de clientèle.
La confirmation multifactorielle exige plusieurs signaux avant de déclencher une alerte. Le recul d'une seule métrique peut n'être que du bruit, mais quand la fréquence de connexion, l'usage des fonctionnalités et la durée des sessions baissent simultanément, la confiance dans l'alerte augmente. Un score composite réduit les faux positifs tout en préservant la sensibilité aux risques réels.
Les périodes de grâce pour les baisses temporaires évitent d'alerter sur des fluctuations de court terme. Un client parti deux semaines en vacances peut afficher zéro usage, sans que cela traduise un risque de churn. Exigez des schémas durables plutôt qu'un instantané ponctuel avant de déclencher une alerte.
Des règles de suppression évitent les alertes en double. Dès qu'une alerte se déclenche et qu'un CSM prend le relais, supprimez les alertes liées pour ce compte pendant une durée définie. Inutile que plusieurs collaborateurs réagissent au même schéma d'usage, ni d'alerter sur des comptes qui font déjà l'objet d'une intervention.
Autorisez le rejet manuel d'une alerte, avec un code motif obligatoire. Les CSM qui connaissent le contexte du compte doivent pouvoir écarter les faux positifs en documentant la raison. Ce retour d'information affine les seuils au fil du temps.
Il est indispensable de recalibrer régulièrement les seuils à partir des résultats historiques des alertes. Suivez quelles alertes ont mené à des interventions réussies, lesquelles étaient des faux positifs et lesquelles ont laissé passer un vrai churn. Servez-vous de ces données pour affiner en continu la logique de vos seuils. L'objectif est de maximiser les vrais positifs tout en minimisant les faux, ce qui demande une optimisation permanente.
Intégration aux workflows de Customer Success
Les alertes d'usage ne vivent pas en vase clos. Elles doivent s'intégrer sans friction à l'ensemble des opérations de Customer Success, aux systèmes CRM et aux workflows de communication.
L'intégration au CRM garantit que les alertes créent automatiquement des tâches, mettent à jour les scores de santé et déclenchent des règles de workflow. Quand une alerte critique se déclenche, elle doit créer une tâche prioritaire attribuée au responsable du compte, avec le contexte utile et des protocoles de réponse suggérés. Cela supprime la surveillance manuelle et garantit qu'aucune alerte ne passe entre les mailles du filet.
Les plateformes de Customer Success devraient intégrer les alertes d'usage à leurs algorithmes de score de santé. Les alertes deviennent alors une donnée parmi d'autres dans une évaluation globale, aux côtés du volume de tickets de support, des retours produit, du statut de paiement et de la qualité de la relation. Cette vision d'ensemble évite de surpondérer une seule métrique.
L'intégration aux workflows de communication permet d'automatiser le premier contact pour les alertes de faible gravité. Quand un compte montre des signes avant-coureurs, des séquences d'e-mails automatisées peuvent fournir des ressources utiles, mettre en avant les fonctionnalités inutilisées ou inviter aux prochaines formations. Ne passez à l'intervention humaine que si l'automatisation ne relance pas l'usage.
Les dashboards de reporting doivent faire ressortir les tendances des alertes et les indicateurs de réactivité des équipes. Combien d'alertes se déclenchent, par type et par niveau de gravité ? Quel est le délai de réponse moyen par niveau d'alerte ? Quelle part des comptes alertés retrouve un usage normal, et quelle part continue de décliner ? Ces indicateurs donnent de la visibilité au management et nourrissent l'amélioration continue.
Suspendre les alertes pendant un ticket de support actif évite les efforts en double. Si un client a des demandes de support ouvertes, il est déjà en contact avec votre équipe. Les alertes d'usage deviennent moins critiques pendant une relation de support active, même si elles doivent continuer d'alimenter le score de santé.
L'intégration aux outils de plan de réussite garantit que les alertes éclairent les revues trimestrielles (QBR) et les plans de réussite. Pour préparer des échanges stratégiques avec les comptes clés, l'historique récent des alertes apporte un contexte précieux sur les schémas d'usage et les points de vigilance à traiter de façon proactive.
L'objectif est de rendre les alertes exploitables au sein des workflows existants plutôt que de créer des processus de suivi parallèles. Plus il est simple pour les CSM de voir, de comprendre et de traiter les alertes dans leurs outils du quotidien, plus votre dispositif de suivi est efficace. Cette intégration opérationnelle suppose de bien mettre en œuvre votre stack technologique SaaS, capable de passer à l'échelle une relation client personnalisée.
Conception du dashboard de suivi
Un bon dashboard rend des données d'usage complexes accessibles et exploitables par les équipes de Customer Success. Un dashboard mal conçu produit soit une surcharge d'information, soit un manque de détail pour décider en connaissance de cause.
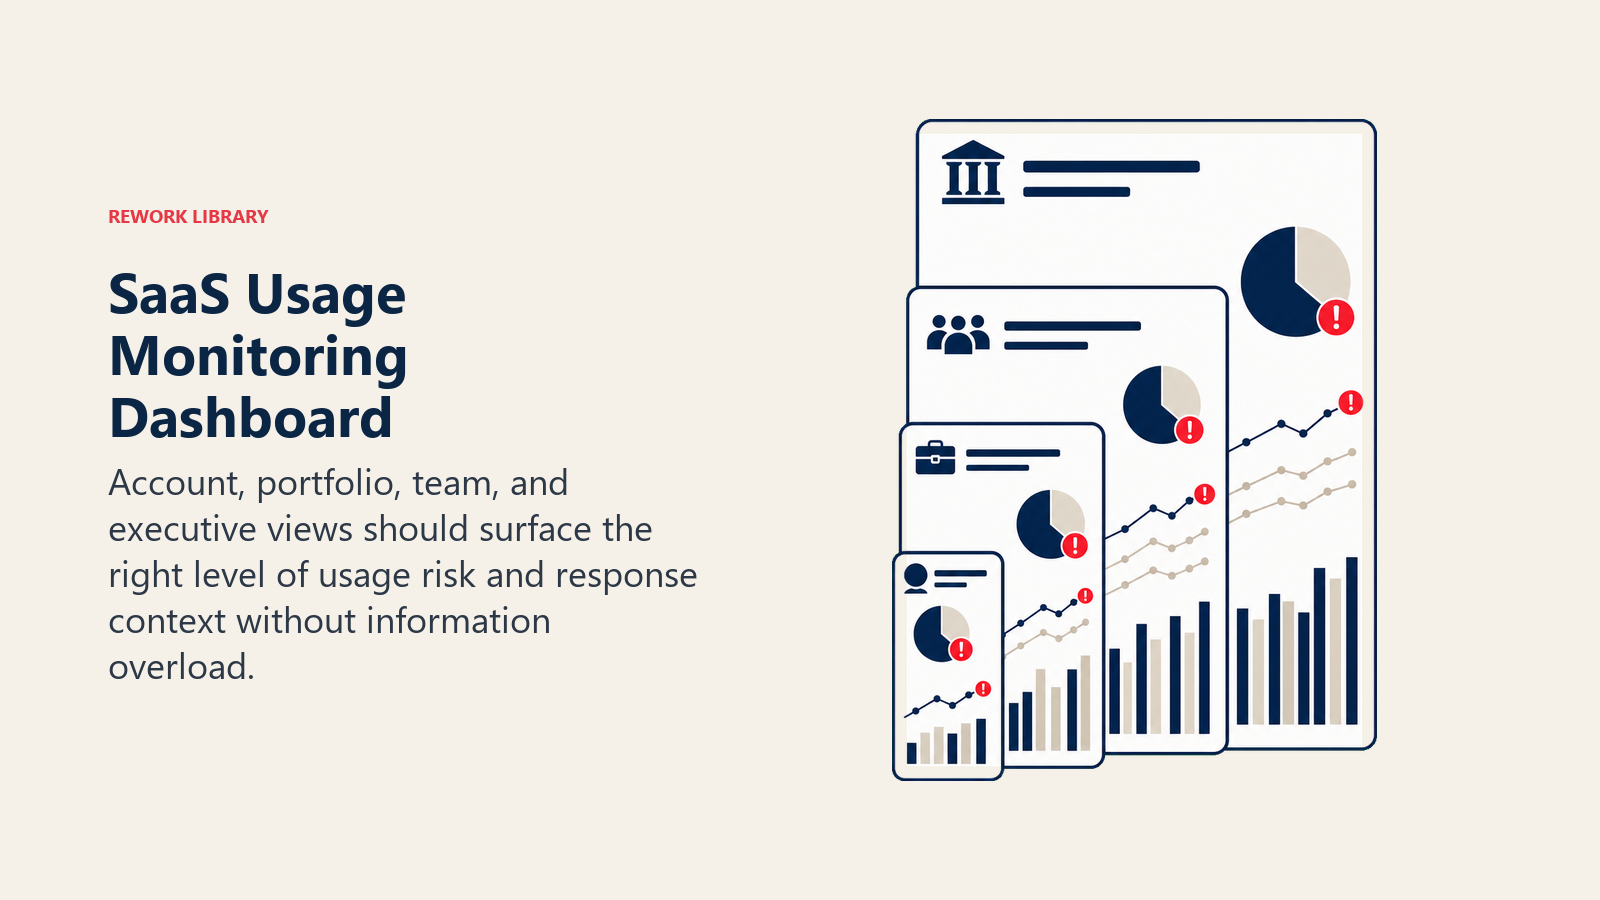
Les dashboards au niveau du compte offrent une vue détaillée de chaque compte. Incluez les tendances d'usage historiques, le statut actuel des alertes, la performance comparée à la cohorte, la progression de l'adoption des fonctionnalités et l'atteinte des jalons clés. Un CSM qui examine un compte précis a besoin de contexte en profondeur, pas seulement de métriques de haut niveau.
Les dashboards au niveau du portefeuille aident les CSM à piloter leur portefeuille de comptes. Affichez tous les comptes attribués, classés selon leur santé et la gravité des alertes. Mettez en évidence ceux qui exigent une attention immédiate et donnez un accès en un clic au détail du compte. Ajoutez des statistiques de synthèse : nombre total de comptes à risque, évolution du score de santé moyen et renouvellements à venir à surveiller.
Les dashboards au niveau de l'équipe permettent le pilotage par le management. Présentez des métriques agrégées : total des alertes par type et par gravité, délais de réponse moyens, taux de réussite des interventions et répartition des scores de santé dans la base clients. Montrez les tendances dans le temps pour savoir si la santé globale s'améliore ou se dégrade.
Les dashboards pour la direction se concentrent sur les métriques stratégiques : nombre de clients à risque, impact projeté du churn, tendances de rétention par cohorte et premiers indicateurs de problèmes émergents. Les dirigeants n'ont pas besoin du détail fin, mais doivent avoir la certitude que le suivi d'usage nourrit une rétention proactive. Envisagez de mettre en place des dashboards de métriques SaaS complets, qui centralisent les indicateurs de performance clés.
Les dashboards efficaces privilégient la clarté visuelle plutôt que la densité de données. Utilisez des codes couleur pour la gravité des alertes, des flèches pour les tendances et une architecture de l'information hiérarchisée et lisible. L'information la plus importante doit sauter aux yeux, le détail supplémentaire étant révélé progressivement.
L'accès mobile compte, car les CSM travaillent souvent hors du bureau. Les dashboards doivent fonctionner sur tablette et smartphone, pour consulter rapidement un statut ou des alertes où que l'on soit.
La mise à jour en temps réel évite que des données périmées ne conduisent à de mauvaises décisions. Les dashboards doivent s'actualiser automatiquement et indiquer clairement la fraîcheur des données. Rien n'entame plus vite la confiance dans un système de suivi que de découvrir que l'on consultait les chiffres de la veille.
La personnalisation permet à chacun de configurer ses vues selon ses méthodes de travail. Certains CSM veulent voir tous leurs comptes par ordre alphabétique, d'autres préfèrent un tri par santé ou par date de renouvellement. Une configuration souple du dashboard favorise l'adoption et l'utilité.
Erreurs courantes de suivi
Même les entreprises qui investissent dans le suivi d'usage le mettent souvent en œuvre de façon peu efficace, ce qui réduit la valeur de leurs systèmes.
Surveiller trop de métriques crée du bruit sans apporter d'éclairage. Quand vous suivez 50 signaux d'usage différents, il devient impossible de distinguer les schémas significatifs des variations aléatoires. Concentrez-vous sur les 5 à 10 métriques les plus corrélées à la rétention dans votre produit.
Fixer des seuils statiques qui ne sont jamais mis à jour produit des alertes sans pertinence à mesure que votre produit et votre base clients évoluent. Ce qui indiquait un usage sain il y a deux ans peut être tout autre aujourd'hui. Prévoyez des revues et des cycles de calibration réguliers des seuils.
Alerter sans protocole de réponse fait perdre du temps à tout le monde. Si des alertes se déclenchent sans que personne ne sache qui doit réagir ni quelle intervention convient, le système de suivi devient un bruit de fond. Documentez clairement les responsabilités et les playbooks avant de déployer les alertes à grande échelle.
Multiplier les alertes sur des problèmes de faible gravité apprend aux équipes à les ignorer. Si les CSM reçoivent 20 alertes par jour, dont la plupart ne sont pas vraiment urgentes, ils finiront par n'en regarder aucune, y compris les critiques. Mieux vaut faire remonter moins d'alertes, mais plus fiables, que de tout signaler.
Ignorer le contexte du compte conduit à des interventions inadaptées. Une baisse d'usage inquiétante pour un client peut être parfaitement normale pour un autre, selon son modèle économique, sa saisonnalité ou son cas d'usage. Intégrez le contexte à votre logique d'alerte et à vos protocoles de réponse.
Ne pas boucler la boucle de rétroaction empêche de progresser. Suivez ce qui se passe après le déclenchement des alertes. L'intervention a-t-elle fonctionné ? L'alerte était-elle un faux positif ? Quels résultats a-t-on obtenus ? Ces données sont indispensables pour affiner les seuils et améliorer l'efficacité des réponses.
Traiter le suivi d'usage comme un projet technique plutôt que comme une capacité opérationnelle, c'est passer à côté de l'essentiel. La technologie est simple ; le défi consiste à instaurer des pratiques d'organisation qui répondent de façon constante aux signaux. Le succès exige à la fois de bonnes données et une exécution rigoureuse.
Construire votre système d'alerte
Démarrez par un pilote ciblé plutôt que de viser un suivi exhaustif dès le premier jour. Choisissez vos trois métriques d'usage à plus forte valeur, selon leur corrélation avec la rétention. Mettez en place des alertes à seuil simples sur ces métriques, pour un sous-ensemble de comptes ou le portefeuille d'un seul CSM.
Menez le pilote pendant 60 à 90 jours en documentant la fréquence des alertes, le taux de faux positifs, les protocoles de réponse et les résultats. Servez-vous de cette période d'apprentissage pour affiner les seuils, améliorer les playbooks de réponse et renforcer la confiance de l'équipe dans le système.
Une fois le pilote concluant, étendez le dispositif de façon méthodique. Ajoutez les métriques une par une plutôt que toutes d'un coup. Cette extension maîtrisée évite de submerger les équipes et préserve la qualité des réponses.
Investissez tôt dans une bonne intégration au CRM. Les systèmes d'alerte manuels, qui obligent quelqu'un à consulter des dashboards chaque jour, fonctionnent rarement sur la durée. Une diffusion automatique des alertes par e-mail, Slack ou tâches CRM garantit une visibilité constante. Une configuration solide de l'analytics produit fournit la base d'un suivi fiable.
Construisez une collaboration transverse avec les équipes produit et ingénierie. Elles peuvent apporter leur appui pour l'instrumentation, aider à identifier les schémas d'usage les plus prédictifs et garantir la qualité des données. Le suivi d'usage est le plus efficace quand il constitue une responsabilité partagée plutôt qu'une initiative réservée au CS.
Documentez tout : logique des seuils, protocoles de réponse, circuits d'escalade et suivi des résultats. Cette documentation accélère l'intégration des nouveaux collaborateurs, garantit la cohérence et pose les bases de l'amélioration continue.
Les alertes de suivi d'usage font passer le Customer Success de la gestion de crise réactive à une gestion proactive des risques. Quand vous voyez venir le churn des semaines à l'avance, vous avez le temps d'intervenir utilement. Cette capacité d'alerte précoce fait la différence entre des taux de rétention qui s'améliorent d'année en année et des batailles toujours à recommencer.
Les entreprises qui excellent dans la réduction du churn ne se contentent pas de suivre l'usage : elles bâtissent des processus systématiques pour réagir quand les schémas d'usage laissent entrevoir un risque. Cette alliance de bonnes données et d'une exécution rigoureuse distingue les organisations de Customer Success réellement proactives de celles qui se contentent d'en parler.
Questions fréquentes
Que sont les alertes de suivi d'usage en SaaS B2B ? Ce sont des notifications automatisées qui se déclenchent quand l'usage du produit par un compte tombe sous un seuil sain défini ou affiche une baisse durable. L'alerte est transmise à un customer success manager, qui peut enquêter et intervenir avant que le compte ne parte ou ne rétrograde son offre.
Quelles métriques d'usage prédisent le mieux le churn ? La fréquence de connexion, la profondeur d'adoption des fonctionnalités, l'accomplissement des actions clés et l'étendue des utilisateurs au sein d'un compte sont les prédicteurs les plus constants. Le recul simultané de plusieurs d'entre elles est un signal plus fort que celui d'une seule métrique.
En quoi les alertes d'usage soutiennent-elles la croissance en SaaS B2B ? L'expansion et la rétention des comptes existants génèrent l'essentiel du revenu récurrent, et conserver ce revenu coûte bien moins cher qu'en acquérir de nouveau. Repérer tôt le désengagement protège la net revenue retention et ouvre des conversations d'expansion plutôt que des appels de dernière chance.
Comment éviter la lassitude face aux alertes ? Utilisez des seuils relatifs à la cohorte et fondés sur la tendance, exigez une confirmation multifactorielle avant qu'une alerte de gravité élevée ne se déclenche, et prévoyez des périodes de grâce pour les baisses de courte durée. Associez chaque niveau de gravité à un protocole de réponse clair, pour que les équipes fassent confiance aux alertes reçues.
En savoir plus
Approfondissez votre compréhension de la rétention client et du suivi d'usage grâce à ces ressources complémentaires :
- Scoring de la santé client - Construisez des grilles d'évaluation complètes qui replacent l'usage dans un ensemble plus large de métriques du compte
- Détection du risque de churn - Identifiez les clients à risque avant qu'ils ne résilient, grâce à l'analyse prédictive et aux signaux comportementaux
- Cadre d'activation des utilisateurs - Optimisez les premiers schémas d'engagement qui prédisent la rétention à long terme et l'adoption du produit
- Campagnes de reconquête - Récupérez les clients perdus grâce à des stratégies de réengagement ciblées et des séquences de reconquête
Co-Founder & COO
On this page
- Pourquoi les signaux d'usage comptent le plus
- Les métriques d'usage essentielles à suivre
- Cadres de définition des seuils d'alerte
- Niveaux de gravité des alertes
- Protocoles de réponse selon le type d'alerte
- Prévenir les faux positifs
- Intégration aux workflows de Customer Success
- Conception du dashboard de suivi
- Erreurs courantes de suivi
- Construire votre système d'alerte
- Questions fréquentes
- En savoir plus