Die besten KI-Tools für die wissenschaftliche Forschung 2026: 13 Tools von der Hypothese bis zur Reproduzierbarkeit
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Der KI-Stack eines Wissenschaftlers muss weit mehr abdecken als eine Literaturrecherche. Sie brauchen etwas, das hilft, eine Hypothese zu generieren und zu testen, bevor Sie überhaupt an die Laborbank gehen, einen Ort, an dem Sie das eigentliche Laborprotokoll schreiben und versionieren können, ein Tool, das unübersichtliche CSV-Dateien in echte Statistiken verwandelt, ohne dass Sie ein Statistikpaket neu lernen müssen, ein System, das jeden Experimentlauf nachverfolgt, damit Ihre Ergebnisse ein Audit überstehen, und einen Workflow, der am Ende das Paper fertigstellt und die zugrunde liegenden Daten archiviert. Dieser Leitfaden deckt den gesamten Lebenszyklus ab, nicht die Phase der Literaturrecherche. Wenn Sie speziell Papers für ein systematisches Review sichten, lesen Sie unseren Leitfaden Die besten KI-Tools für Literaturrecherchen, und wenn Sie den breiteren Stack von der Entdeckung bis zum Schreiben für jede akademische Disziplin suchen, deckt unser Leitfaden Die besten KI-Tools für die akademische Forschung diesen Bereich ab. Dieser Leitfaden hier ist für die Teile der Wissenschaft gemacht, die nach dem Lesen der Papers passieren: das Experiment entwerfen, es durchführen, analysieren und sicherstellen, dass jemand anderes es reproduzieren kann.
Aktualisiert im Juli 2026. Jedes Tool unten wurde anhand echter Labor- und computergestützter Forschungs-Workflows bewertet, nicht anhand einer Anbieter-Demo, mit Preisen, die im Juli 2026 gegen die öffentliche Preisseite jedes Anbieters geprüft wurden. Die Gesamtliste über alle KI-Kategorien hinweg finden Sie unter Die besten KI-Tools 2026.
Wichtige Fakten
- Mehr als 70% der Forschenden haben versucht, das Experiment eines anderen Wissenschaftlers zu reproduzieren, und sind gescheitert, und über die Hälfte ist sogar an der eigenen Reproduktion gescheitert, laut Natures Umfrage von 2016 unter 1.576 Forschenden. 52% stimmten zu, dass eine bedeutende Reproduzierbarkeitskrise existiert.
- FutureHouses PaperQA2 ist der erste KI-Agent, der bei Aufgaben zur Literaturrecherche (dem LitQA2-Benchmark) mit Biologie-Forschenden auf Promotions- und Postdoc-Niveau gleichzieht oder sie übertrifft, laut dem arXiv-Paper "Language agents achieve superhuman synthesis of scientific knowledge".
- Nur 27% der infrage kommenden Ökologie-Artikel wurden von nutzbarem Code begleitet, laut einem in PMC veröffentlichten Reproduzierbarkeits-Audit, was zeigt, wie viel computergestützte Forschung noch immer von niemand außer der ursprünglichen Autorin oder dem ursprünglichen Autor erneut ausgeführt werden kann.
- 84% der Entwicklerinnen und Entwickler nutzen inzwischen KI-Coding-Tools oder planen dies, gegenüber 76% im Jahr zuvor, wobei nur 51% sie täglich nutzen und das Vertrauen in die Genauigkeit von KI-generiertem Code auf 29% gesunken ist, laut Stack Overflows Developer Survey 2025.
- In einer randomisierten kontrollierten Studie, die GitHub mit Microsoft Research durchführte, erledigten Entwicklerinnen und Entwickler mit GitHub Copilot eine Programmieraufgabe 55% schneller als ohne, laut GitHubs eigener veröffentlichter Forschung.
- Das Acceleration Consortium der University of Toronto setzt KI-gesteuerte, selbstfahrende Labore ein, um die Kosten und die Zeit für die Entdeckung eines neuen Materials von rund 20 Jahren und 100 Millionen US-Dollar auf 1 Jahr und 1 Million US-Dollar zu senken, unterstützt durch einen 200-Millionen-Dollar-Zuschuss der kanadischen Regierung.
- Der globale Markt für Laborautomatisierung soll von 6,60 Milliarden US-Dollar im Jahr 2026 auf 8,62 Milliarden US-Dollar bis 2031 wachsen, eine CAGR von 6,6%, laut MarketsandMarkets.
Was sich 2026 geändert hat
Die wissenschaftliche KI hat sich 2026 auf Produkt-, Preis- und Betriebsmodellebene verändert, wobei vernetzte Workbenches und autonome Experimente näher an den Forschungsalltag heranrücken.
- GitHub Copilot wechselte am 1. Juni 2026 zur nutzungsbasierten Abrechnung über AI Credits und ersetzte feste Pro-Sitz-Limits durch abgerechnete Credits in den Stufen Pro, Pro+, Business und Enterprise.
- Google teilte sein AI-Ultra-Abonnement auf der I/O 2026 in eine Einstiegsstufe für 99,99 US-Dollar und eine High-Limit-Stufe für 200 US-Dollar auf, die nun die höheren Nutzungslimits für Gemini-gestützte Tools einschließlich des KI-Assistenten von Colab bestimmt.
- Anthropic brachte am 30. Juni 2026 Claude Science auf den Markt, eine wissenschaftliche Workbench, die Claude mit Forschungsdatenbanken, Codeausführung, HPC-Rechenleistung und dem Verfassen von Manuskripten in einer einzigen Umgebung verbindet. Sie konkurriert eher mit den universellen Assistenten in unserem Vergleich Claude vs ChatGPT vs Gemini als mit den unten aufgeführten spezialisierten Labortools.
- Ginkgo Bioworks hat sich öffentlich verpflichtet, seine gesamte Forschung und Entwicklung bis Ende 2026 auf autonome, selbstfahrende Infrastruktur umzustellen, eines der bislang deutlichsten Signale, dass KI-gesteuerte Experimente in der Biotechnologie vom Pilotprojekt zum Standard werden.
Der Lebenszyklus der wissenschaftlichen Forschung: Wo jedes Tool ansetzt
Ein Forschungsprojekt scheitert selten daran, dass niemand das richtige Paper finden konnte. Es scheitert daran, dass eine Hypothese nicht testbar war, ein Protokoll nicht ausreichend dokumentiert wurde, damit es jemand anderes wiederholen kann, der Analysecode nur auf einem Laptop existierte, oder das Paper nie an den Gutachtenden vorbeikam, die fragten: "Können Sie Ihre Daten teilen?" Die Tools unten sind sechs Phasen dieses Lebenszyklus zugeordnet, und die meisten Labore werden am Ende zwei oder drei davon gleichzeitig nutzen, statt sich auf einen einzigen Gewinner festzulegen.
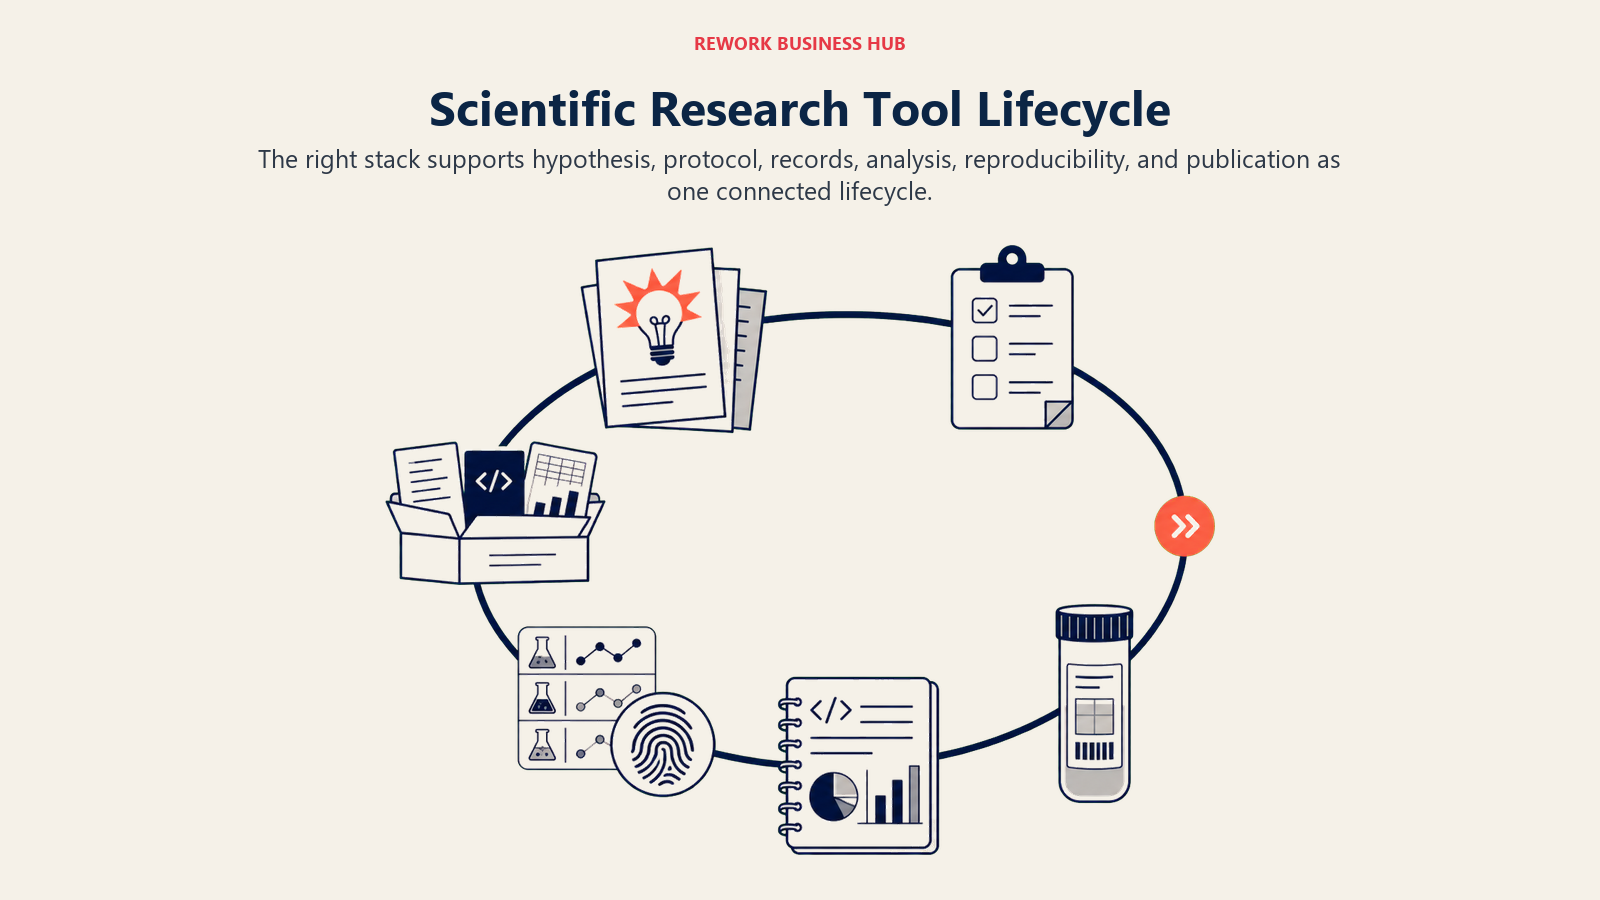
- Hypothesen- und Ideengenerierung. Bevor Sie Laborzeit investieren, wollen Sie ein KI-System, das über die bestehende Literatur hinweg schlussfolgern und testbare Richtungen vorschlagen kann, statt nur zusammenzufassen, was bereits bekannt ist.
- Experimentelles Design und Laborprotokolle. Sobald Sie wissen, was Sie testen, muss das Protokoll selbst geschrieben, versioniert und teilbar sein, damit eine Laborkollegin oder ein Gutachter es exakt nachvollziehen kann.
- Datenerfassung und Laboraufzeichnungen. Rohdaten, Proben und Instrumentenausgaben brauchen ein Ablagesystem, das dauerhafter ist als ein gemeinsames Laufwerk voller Tabellenkalkulationen.
- Datenanalyse und Programmierung. Hier fließt der Großteil der eigentlichen Forschungszeit hinein: Daten bereinigen, Statistiken berechnen, Analyseskripte schreiben, Modelle bauen.
- Experiment-Tracking und Reproduzierbarkeit. Jeder Lauf, jeder Hyperparameter, jede Codeversion muss protokolliert werden, damit das Ergebnis zurückverfolgt und erneut ausgeführt werden kann.
- Schreiben und offenes Archivieren. Das Paper wird entworfen, das Manuskript formatiert, und die zugrunde liegenden Daten und der Code werden mit einer dauerhaften Kennung irgendwo hinterlegt.
Schnellvergleichstabelle
| Tool | Am besten für | Einstiegspreis | Wichtigste Stärke | Wichtigste Einschränkung |
|---|---|---|---|---|
| FutureHouse Platform | KI-generierte, literaturgestützte Forschungshypothesen | Kostenlose Plattform (Credit-basierte API für Agenten) | PaperQA2 übertrifft PhD-Forschende bei der Literaturrecherche | Edison-Agent-API benötigt gekaufte Credits, kein festes Abonnement |
| Julius AI | Statistik und Datenanalyse in natürlicher Sprache | Kostenlos (15 Nachrichten/Monat), Plus 35 $/Monat | Führt echte Statistiken aus und erstellt Diagramme aus einfachen englischsprachigen Prompts | Kostenlose Stufe ist nur eine Vorschau, nicht für echte Projekte nutzbar |
| Google Colab | Kostenlose Cloud-Notebooks für computergestützte Forschung | Kostenlos (Pro 11,99 $/Monat) | Gemini-gestütztes Coding, kostenloser GPU-Zugriff, kein Setup nötig | Kostenloser GPU-Zugriff ist begrenzt und kann jederzeit entzogen werden |
| GitHub Copilot | KI-Pair-Programming für Forschungscodebasen | Kostenlos (Pro 10 $/Monat) | Schnellster, am weitesten verbreiteter KI-Coding-Assistent | Nutzungsbasierte Credits seit Juni 2026 erhöhen die Abrechnungskomplexität |
| Weights & Biases | Experiment-Tracking für computergestützte und ML-Forschung | Kostenlos (persönlich), Teams ab 50 $/Nutzer/Monat | Protokolliert jeden Lauf, Hyperparameter und jedes Ergebnis für Reproduzierbarkeit | Nutzungsbasierte Preise für erfasste Stunden werden im großen Maßstab teuer |
| Code Ocean | Reproduzierbare Compute-Kapseln, verknüpft mit einer Publikation | Kostenlos (akademisch, 25 Nutzer) | Verpackt Code, Daten und Umgebung in eine erneut ausführbare Kapsel | Enterprise und höherer Rechenbedarf benötigen individuelle Preise |
| Benchling AI | ELN, LIMS und Laborworkflow-Management für Life Sciences | Individuell (keine kostenlose Stufe) | Vereint Notizbuch, Registry, Inventar und KI-Copilot in einer Plattform | Keine öffentlichen Preise, in der Regel eine Verpflichtung im Enterprise-Maßstab |
| protocols.io | Versioniertes, teilbares Repository für Laborprotokolle | Kostenlos (öffentliche Protokolle) | Schrittweise Protokolle mit Versionshistorie und Forking | Institutionelle Preise sind seit 2025 stark gestiegen |
| LabArchives | Allgemeines elektronisches Laborbuch | Kostenlos (2 Notizbücher, 1 GB) | Breite Fachbereichsunterstützung, compliance-fertige Protokollführung | Speicherbegrenzung der kostenlosen Stufe ist über ein Pilotprojekt hinaus unpraktisch |
| Scholarcy | Schnelle KI-Zusammenfassungen und Karteikarten für umfangreiche Papers | Kostenlos (10 Zusammenfassungen), 9,99 $/Monat | Erstellt automatisch Karteikarten-Zusammenfassungen und Literaturlisten | Kostenlose Stufe auf 1 Zusammenfassung pro Tag begrenzt |
| Overleaf (+ Writefull) | Gemeinsames LaTeX-Schreiben mit KI-Sprachhilfe | Kostenlos, Standard ~21 $/Monat | Echtzeit-Zusammenarbeit plus KI-Grammatik- und Formulierungsprüfung | KI-Funktionen sind bei Standard begrenzt, voller Zugriff erfordert Professional |
| OSF | Präregistrierung und projektweite Reproduzierbarkeit | Kostenlos, keine Gebühren | Hypothesen präregistrieren, Daten, Code und Materialien gemeinsam archivieren | 5-GB-Limit pro Komponente bei privaten Projekten |
| Zenodo | Dauerhafte, DOI-gestützte Archivierung von Datensätzen und Code | Kostenlos, keine Obergrenze | CERN-betrieben, Integration mit GitHub für Ein-Klick-Codearchivierung | 50-GB-Obergrenze pro einzelnem Datensatz |
Workflow-Passungsmatrix
| Tool | Hypothese | Protokolle/ELN | Datenanalyse | Reproduzierbarkeit | Schreiben/Archivierung |
|---|---|---|---|---|---|
| FutureHouse Platform | Stark | - | Möglich | Möglich | Möglich |
| Julius AI | - | - | Stark | - | - |
| Google Colab | - | - | Stark | Möglich | - |
| GitHub Copilot | - | - | Stark | Möglich | - |
| Weights & Biases | - | - | Möglich | Stark | - |
| Code Ocean | - | - | Möglich | Stark | Möglich |
| Benchling AI | Möglich | Stark | Möglich | Möglich | - |
| protocols.io | - | Stark | - | Möglich | - |
| LabArchives | - | Stark | - | Möglich | - |
| Scholarcy | Möglich | - | - | - | Möglich |
| Overleaf (+ Writefull) | - | - | - | - | Stark |
| OSF | - | Möglich | - | Stark | Stark |
| Zenodo | - | - | - | Stark | Stark |
Größen- und Zielgruppentabelle
| Tool | Ideale Nutzerin/idealer Nutzer | Primärer Anwendungsfall |
|---|---|---|
| FutureHouse Platform | Biologie- und Life-Sciences-Forschende, die neue Richtungen erkunden | KI-Agenten, die Hypothesen aus der Literatur vorschlagen und evidenzbasiert prüfen |
| Julius AI | Forschende, die Statistiken brauchen, ohne selbst Code zu schreiben | Datenanalyse, Diagramme und Regressionsmodelle in natürlicher Sprache |
| Google Colab | Alle, die Python-basiertes wissenschaftliches Rechnen betreiben | Kostenlose oder günstige Cloud-Notebooks mit GPU-Zugriff und KI-Codehilfe |
| GitHub Copilot | Research Software Engineers und computergestützte Wissenschaftler:innen | KI-gestütztes Programmieren innerhalb bestehender Pipelines und Codebasen |
| Weights & Biases | Teams, die viele computergestützte oder ML-Experimente durchführen | Protokollieren, Vergleichen und Reproduzieren jedes Experimentlaufs |
| Code Ocean | Autor:innen, die Code zusammen mit einer Publikation einreichen | Verpacken einer reproduzierbaren, mit einem Klick erneut ausführbaren Compute-Kapsel |
| Benchling AI | Biotech- und Pharma-F&E-Teams | Einheitliches ELN, LIMS, Registry und KI-Copilot für Laborabläufe |
| protocols.io | Labore, die Methoden über ein Paper oder eine Multi-Standort-Studie hinweg teilen | Versionierte, forkbare, schrittweise Protokolldokumentation |
| LabArchives | Labore jeder Fachrichtung, die compliance-fertige Aufzeichnungen brauchen | Allgemeines elektronisches Laborbuch mit Audit-Trail |
| Scholarcy | Alle, die einen großen Stapel Papers schnell durcharbeiten müssen | KI-Karteikarten-Zusammenfassungen und automatisch generierte Literaturverzeichnisse |
| Overleaf (+ Writefull) | Alle, die gemeinsam an einem Manuskript in LaTeX schreiben | Gemeinsames Schreiben in Echtzeit mit KI-Sprachpolitur |
| OSF | Teams, die Studien präregistrieren oder ein ganzes Projekt archivieren | Präregistrierung plus reproduzierbares Projekt- und Dateimanagement |
| Zenodo | Alle, die ein dauerhaftes, zitierfähiges Archiv für Daten oder Code brauchen | DOI-gestützte, kostenlose, GitHub-integrierte Archivierung von Datensätzen und Code |
1. FutureHouse Platform: KI-Agenten für literaturgestützte Hypothesengenerierung
FutureHouse ist ein gemeinnütziges KI-Forschungslabor, und seine Plattform ist der Ort, an dem die Hypothesenphase tatsächlich automatisiert wird, statt nur beschleunigt zu werden. PaperQA2, der Open-Source-Kernagent, ist das erste dokumentierte KI-System, das bei der Literaturrecherche mit Biologie-Forschenden auf Promotions- und Postdoc-Niveau gleichzieht oder sie übertrifft, laut dem zugrunde liegenden arXiv-Paper. Auf der Produktionsseite orchestriert das Robin-System der Plattform drei spezialisierte Agenten (Crow für die Literatursuche, Falcon für tiefere Synthese, Finch für die Datenanalyse) zu einem Workflow, der eine Hypothese vorschlagen, ein Experiment entwerfen und Ergebnisse mit minimaler menschlicher Steuerung analysieren kann. In einer öffentlichen Demonstration brachte Robin eine Hypothese in rund 2,5 Monaten vom Konzept bis zu einem entworfenen Paper, das Ripasudil als Kandidat für eine Therapie bei trockener altersbedingter Makuladegeneration identifizierte.
Die Plattform selbst ist kostenlos nutzbar, und der Code von PaperQA2 ist auf GitHub quelloffen. Um die Produktions-Edison-Agenten (Crow und Falcon) über die API zu nutzen, erstellen Sie ein Profil und kaufen Credits, statt ein festes Abonnement zu zahlen, was die Kosten proportional zur tatsächlichen Nutzung hält, die Budgetierung aber weniger vorhersehbar macht als ein Pro-Sitz-Plan.
| Das bekommen Sie | Das bekommen Sie nicht |
|---|---|
| PaperQA2 erreicht oder übertrifft die Genauigkeit der Literaturrecherche auf PhD-Niveau | Die Edison-Agent-API ist credit-basiert, kein festes monatliches Abonnement |
| Open-Source-Kern (PaperQA2), kein Vendor-Lock-in beim Code selbst | Robins vollständiger Workflow von der Hypothese zum Paper ähnelt eher einer Forschungskollaboration als einem Self-Service-Tool |
| Crow- und Falcon-Agenten speziell für wissenschaftliches Schlussfolgern gebaut | Neuere Plattform mit weniger Enterprise-Support-Infrastruktur als etablierte ELN-Anbieter |
| Kostenloser Plattformzugang, gemeinnützig betrieben | Am besten geeignet für Biologie und Life Sciences, außerhalb dieser Domäne weniger erprobt |
Preise: Kostenloser Plattformzugang; PaperQA2 Open Source; Edison-Agent-API im Pay-as-you-go-Credit-Modell, laut FutureHouses Plattform-Ankündigung
Am besten für: Life-Sciences-Forschende, die ein KI-System wollen, das Hypothesen vorschlägt und evidenzbasiert prüft, bevor Laborzeit investiert wird
2. Julius AI: Statistik und Datenanalyse in natürlicher Sprache
Julius AI existiert, um den Engpass "pandas lernen oder eine Statistikerin einstellen" zwischen Rohdaten und einer Antwort zu beseitigen. Laden Sie eine CSV-Datei hoch, beschreiben Sie in einfachem Englisch, was Sie wollen (ein t-Test, eine Regression, eine Clusteranalyse, ein bestimmter Diagrammtyp), und Julius schreibt und führt den zugrunde liegenden Code aus und erklärt Ihnen das Ergebnis anschließend in normaler Sprache. Für Forschende, die ihre Daten und ihre Fragestellung verstehen, aber nicht die Syntax eines Statistikpakets, verwandelt das einen früher mehrtägigen Austausch mit einer Kollegin in wenige Minuten.
Der kostenlose Plan ist bei 15 Nachrichten pro Monat gedeckelt, was ausreicht, um die Oberfläche zu testen, aber nicht, um ein echtes Projekt durchzuführen. Plus (35 $/Monat, oder rund 29 $/Monat bei jährlicher Abrechnung) ist der Einstiegspunkt für die regelmäßige individuelle Nutzung. Pro (45 $/Monat, rund 37 $/Monat jährlich) hebt das Nachrichtenlimit vollständig auf. Business springt deutlich auf 375 $/Monat (rund 318 $/Monat jährlich) für gemeinsame Workspaces und Integrationen, und Enterprise wird direkt verhandelt. Studierende und Lehrkräfte erhalten 50% Rabatt auf jede Stufe.
| Das bekommen Sie | Das bekommen Sie nicht |
|---|---|
| Echte statistische Analysen und Diagrammerstellung aus einfachen englischsprachigen Prompts | Kostenloser Plan (15 Nachrichten/Monat) ist eine Vorschau, nicht für echte Forschung nutzbar |
| Kein Programmieren nötig, um einen t-Test, eine Regression oder eine Clusteranalyse durchzuführen | Sprung von Pro (45 $/Monat) zu Business (375 $/Monat) hat keine Zwischenstufe |
| Rabatt von 50% für Studierende und Lehrkräfte auf allen kostenpflichtigen Plänen | Gemeinsame Workspaces erfordern speziell die Business-Stufe |
| 14-tägiges Rückerstattungsfenster bei kostenpflichtigen Plänen | Komplexe, mehrstufige statistische Pipelines profitieren weiterhin von menschlicher Überprüfung |
Preise: Kostenlos (15 Nachrichten/Monat); Plus 35 $/Monat; Pro 45 $/Monat; Business 375 $/Monat; Enterprise individuell, laut Julius AIs Preisseite
Am besten für: Forschende, die echte Statistiken und Visualisierungen brauchen, ohne selbst Analysecode zu schreiben
3. Google Colab: Kostenlose Cloud-Notebooks mit Gemini-gestütztem Coding
Colab ist seit Jahren der Standardausgangspunkt für computergestützte Forschung in Python, hauptsächlich weil die kostenlose Stufe GPU-Zugriff ohne lokales Setup bietet. 2026 kommt diese kostenlose Stufe mit Gemini direkt in der Notebook-Fußzeile: Klicken Sie auf das Funken-Symbol, und Sie erhalten inline Codegenerierung, Fehlererklärungen und zellweise Vorschläge, ohne das Notizbuch zu verlassen. Für Forschende, die eine explorative Datenanalyse durchführen, ein kleines Modell trainieren oder das veröffentlichte Notebook einer anderen Person reproduzieren, ist diese Kombination aus kostenloser Rechenleistung und integrierter KI-Unterstützung schwer zu schlagen.
Der GPU-Zugriff der kostenlosen Stufe (in der Regel eine T4) ist begrenzt und kann während Zeiten hoher Nachfrage gedrosselt oder entzogen werden, was der Hauptgrund ist, warum Labore upgraden. Colab Pro kostet 11,99 $/Monat mit mehr Compute-Einheiten und priorisiertem Zugriff auf schnellere GPUs; Colab Pro+ kostet 49,99 $/Monat für schwerere, länger laufende Jobs. Pay-as-you-go-Compute-Einheiten sind außerhalb eines Abonnements ebenfalls für 9,99 $ für 100 Einheiten verfügbar, nützlich für einen einzelnen aufwendigen Analyselauf statt für ein laufendes Abonnement.
| Das bekommen Sie | Das bekommen Sie nicht |
|---|---|
| Kostenlose GPU-gestützte Notebooks ohne lokale Umgebungseinrichtung | GPU-Zugriff der kostenlosen Stufe ist begrenzt und kann ohne Vorwarnung entzogen werden |
| Standardmäßig in die Notebook-Oberfläche integrierte Gemini-KI-Unterstützung | Höhere Nutzungslimits erfordern ein Google-AI-Pro- oder -Ultra-Abonnement |
| Pay-as-you-go-Compute-Einheiten für einmalige aufwendige Jobs (9,99 $/100 Einheiten) | Lang laufende Jobs passen weiterhin besser zu einem dedizierten Compute-Anbieter |
| Vertraute, Jupyter-basierte Oberfläche, die die meisten Forschenden bereits kennen | Pro+ (49,99 $/Monat) ist ein deutlicher Sprung für individuelle Budgets |
Preise: Kostenlos; Colab Pro 11,99 $/Monat; Colab Pro+ 49,99 $/Monat; Pay-as-you-go ab 9,99 $ pro 100 Compute-Einheiten, laut Colabs Preisseite
Am besten für: Forschende, die Python-basierte Datenanalysen oder Modellierung betreiben und kostenlose oder günstige Rechenleistung mit integrierter KI-Codehilfe wollen
4. GitHub Copilot: KI-Pair-Programming für Forschungscodebasen
Die meisten publizierten wissenschaftlichen Arbeiten hängen inzwischen irgendwo in der Pipeline von Code ab, sei es ein maßgeschneidertes Analyseskript, eine Simulation oder ein vollständiges Modellierungsframework, und Copilot ist der KI-Coding-Assistent mit der breitesten Erfolgsbilanz innerhalb und außerhalb der Wissenschaft. In einer randomisierten kontrollierten Studie, die GitHub mit Microsoft Research durchführte, erledigten Entwicklerinnen und Entwickler mit Copilot eine definierte Programmieraufgabe 55% schneller als ohne, und separate Umfragedaten ergaben, dass 88% der Nutzenden angaben, sich im täglichen Einsatz produktiver zu fühlen. Für Research Software Engineers, die eine Analyse-Pipeline pflegen, oder Promovierende, die ihre erste echte Datenpipeline schreiben, bedeutet das weniger verlorene Stunden für Boilerplate und Syntaxsuche.
Copilot wechselte am 1. Juni 2026 zur nutzungsbasierten Abrechnung über AI Credits. Die kostenlose Stufe umfasst begrenzte Vervollständigungen und Chat. Pro (10 $/Monat) enthält 15 \(an monatlichen Credits; Pro+ (39\)/Monat) enthält 70 \(an Credits; Max (100\)/Monat) richtet sich an intensive Tagesnutzer:innen mit 200 \(an Credits. Teams erhalten Business (19\)/Nutzer/Monat, 1.900 Credits) oder Enterprise (39 $/Nutzer/Monat, 3.900 Credits, nur GitHub Enterprise Cloud). Codevervollständigungen selbst bleiben auf allen kostenpflichtigen Plänen unbegrenzt, unabhängig von der Credit-Nutzung.
| Das bekommen Sie | Das bekommen Sie nicht |
|---|---|
| 55% schnellere Aufgabenerledigung in GitHubs eigener RCT mit Microsoft Research | Nutzungsbasierte AI Credits (seit Juni 2026) fügen eine zusätzliche Abrechnungsebene hinzu |
| Unbegrenzte Codevervollständigungen bei jeder kostenpflichtigen Stufe, Credits messen nur Chat-/Agent-Nutzung | Vervollständigungen und Chat-Zugriff der kostenlosen Stufe sind spürbar begrenzt |
| Tiefe Integration mit bestehenden, auf GitHub gehosteten Forschungs-Repositories | Der beste Wert erfordert, das eigene Nutzungsmuster zu kennen, bevor man eine Stufe wählt |
| Weiteste Verbreitung aller KI-Coding-Assistenten, starke Community und Dokumentation | Nicht speziell für wissenschaftliches Rechnen gebaut, universell konzipiert |
Preise: Kostenlos; Pro 10 $/Monat; Pro+ 39 $/Monat; Max 100 $/Monat; Business 19 $/Nutzer/Monat; Enterprise 39 $/Nutzer/Monat, laut GitHub Copilots Seite zu den Plänen
Am besten für: Research Software Engineers und computergestützte Wissenschaftler:innen, die echte Codebasen pflegen, nicht nur einmalige Notebooks
5. Weights & Biases: Experiment-Tracking für reproduzierbare computergestützte Forschung
Weights & Biases (W&B) löst eine bestimmte Reproduzierbarkeitslücke: Sobald Sie Dutzende oder Hunderte computergestützter Experimente durchführen, wird es von Hand unmöglich, sich zu merken, welche Hyperparameter, welche Datensatzversion und welcher Code-Commit welches Ergebnis produziert haben. W&B protokolliert automatisch jeden Lauf, lässt Sie Ergebnisse nebeneinander vergleichen und verknüpft jeden protokollierten Lauf zurück mit exakt dem Code und der Konfiguration, die ihn erzeugt haben, genau die Art von Nachweiskette, die bei den 27% der Ökologie-Papers und den unter 6% der KI-Papers fehlt, die ohne nutzbaren Code veröffentlicht werden, laut den oben zitierten Reproduzierbarkeits-Audits.
Der kostenlose Plan deckt unbegrenzte Projekte und Teams mit 200 GB Cloud-Speicher ab, genug, damit eine einzelne Forscherin oder ein kleines Labor ihn vollständig evaluieren kann. Kostenpflichtige Stufen werden nach erfassten Stunden abgerechnet: Stufe 1 kostet 50 $/Nutzer/Monat (250 bis 5.000 kumulierte erfasste Stunden), Stufe 2 100 $/Nutzer/Monat (5.000 bis 10.000 Stunden), und Stufe 3 150 $/Nutzer/Monat (10.000 bis 15.000 Stunden). Enterprise-Pläne sind individuell, in der Regel 315 bis 400 $ pro Sitz und Monat, und ergänzen HIPAA-Compliance, SSO und dedizierten Support.
| Das bekommen Sie | Das bekommen Sie nicht |
|---|---|
| Automatische Protokollierung jedes Experimentlaufs, Hyperparameters und Ergebnisses | Nutzungsbasierte Preise für erfasste Stunden bedeuten, dass die Kosten mit der tatsächlichen Nutzung skalieren |
| Kostenlose Stufe mit 200 GB Speicher und unbegrenzten Projekten | Rechenintensive Labore durchlaufen die Stufen schneller als erwartet |
| Direkte Verknüpfung zwischen einem protokollierten Ergebnis und dem Code/der Konfiguration, die es erzeugt haben | Am besten geeignet für computergestützte und ML-nahe Forschung, weniger relevant für Nasslabore |
| Enterprise-Stufe ergänzt HIPAA, SSO und Audit-Logs für regulierte Forschung | Enterprise-Preise (315-400 $/Sitz/Monat) sind eine echte Verpflichtung |
Preise: Kostenlos (persönlich); Teams ab 50 $/Nutzer/Monat (gestaffelt nach erfassten Stunden); Enterprise individuell, laut Weights & Bias' Preisseite
Am besten für: Labore, die viele computergestützte oder ML-Experimente durchführen und einen belastbaren Nachweis brauchen, was genau jedes Ergebnis erzeugt hat
6. Code Ocean: Reproduzierbare Compute-Kapseln für Publikationen
Code Ocean geht Reproduzierbarkeit von der Publikationsseite an: Es verpackt Ihren Code, Ihre Daten und die vollständige Softwareumgebung in eine einzige "Compute-Kapsel", die jede:r (ein Gutachter, eine Leserin, eine zukünftige Version von Ihnen selbst) öffnen und mit einem Klick erneut ausführen kann, ohne Ihr Abhängigkeits-Setup von Grund auf neu zu erstellen. Die Plattform verfolgt automatisch die Herkunft und Abstammung von Ergebnissen, sodass Sie jede Ausgabe durch genau die Pipeline zurückverfolgen können, die sie erzeugt hat, und sie wird zunehmend von Fachzeitschriften gefordert oder empfohlen, die eine funktionierende Reproduktion computergestützter Ergebnisse verlangen, nicht nur eine Erklärung zur Datenverfügbarkeit.
Akademische Labore erhalten eine wirklich nutzbare kostenlose Stufe: bis zu 25 Nutzende, 10 Rechenstunden pro Monat und 20 GB Speicher, genug, um eine Kapsel im Zusammenhang mit einem Paper zu veröffentlichen und zu verifizieren, ohne etwas zu bezahlen. Höherer Rechenbedarf (GPU-Zugriff, größere Teams, private VPC-Bereitstellung) wechselt zu individuellen Enterprise-Preisen.
| Das bekommen Sie | Das bekommen Sie nicht |
|---|---|
| Kostenlose Stufe für akademische Labore: 25 Nutzende, 10 Rechenstunden/Monat, 20 GB Speicher | Rechenstunden der kostenlosen Stufe sind bescheiden für alles über Verifikationsläufe hinaus |
| Ein-Klick-Reproduktion eines vollständigen Pakets aus Code, Daten und Umgebung | Höherer oder GPU-basierter Rechenbedarf erfordert individuelle Enterprise-Preise |
| Automatisierte Herkunfts- und Abstammungsverfolgung für jedes Ergebnis | Nicht gebaut für Laborprotokolle oder Nasslabor-Aufzeichnungen |
| Zunehmend abgestimmt auf Reproduzierbarkeitsanforderungen von Fachzeitschriften | Neuer in der Mainstream-Verbreitung als universelle Notebook-Tools |
Preise: Kostenlos (akademisch, bis zu 25 Nutzende); Enterprise/VPC individuell, laut Code Oceans FAQ
Am besten für: Autor:innen, die eine nachweislich reproduzierbare Version ihres Codes und ihrer Daten zusammen mit einer Publikation liefern müssen
7. Benchling AI: Einheitliches ELN, LIMS und KI-Copilot für Life Sciences
Benchling kommt einem Betriebssystem für ein Biotech- oder Pharma-F&E-Team auf dieser Liste am nächsten. Die Life Sciences R&D Cloud vereint sieben integrierte Anwendungen (Notebook, Molecular Biology, Registry, Inventory, Workflows, Studies und Insight), sodass Sequenzdesign, Probenverfolgung, Experimentaufzeichnungen und ein KI-Copilot zur Abfrage über all das hinweg in einer Plattform statt in sechs getrennten Tools existieren. Das ist besonders für die Protokoll- und Datenerfassungsphase relevant: Ein in Benchling erfasstes Ergebnis wird automatisch mit dem Konstrukt, der Probe und dem Workflow verknüpft, die es erzeugt haben, eine deutlich stärkere Reproduzierbarkeitsgarantie als ein Ordner voller Tabellenkalkulationen.
Die Preisgestaltung ist vollständig individuell und angebotsbasiert, ohne öffentliche Stufen und ohne kostenlosen Plan. Das spiegelt den Zielmarkt wider: mittelgroße bis große Biotech- und Pharma-F&E-Organisationen, nicht einzelne akademische Labore oder Einzelforschende, wo die Breite der Plattform rechtfertigt, was typischerweise eine Verpflichtung im Enterprise-Maßstab ist.
| Das bekommen Sie | Das bekommen Sie nicht |
|---|---|
| Notebook, Registry, Inventar und Workflows vereint in einer Plattform | Keine öffentlichen Preise und keine kostenlose Stufe, erfordert ein Verkaufsgespräch |
| KI-Copilot kann über Notizbucheinträge, Proben und Ergebnisse hinweg abfragen | Individuelle Angebote setzen die Einstiegskosten typischerweise in den Tausenden pro Monat an |
| Ergebnisse automatisch mit der Probe und dem Workflow verknüpft, die sie erzeugt haben | Überdimensioniert für ein einzelnes akademisches Labor, am besten geeignet für organisationsweite Biotech-F&E |
| Speziell für Compliance-Anforderungen in Biotech und Pharma gebaut | Weniger relevant außerhalb der Life Sciences (Chemie, Physik, Sozialwissenschaften) |
Preise: Individuell, angebotsbasiert, keine öffentlichen Stufen, laut Benchlings Preisseite
Am besten für: Biotech- und Pharma-F&E-Teams, die ein verbundenes System über Notebook, Registry, Inventar und Workflow-Tracking hinweg brauchen
8. protocols.io: Versionierte, teilbare Laborprotokolle
Ein Methodenabschnitt in einem Paper ist eine Zusammenfassung. protocols.io ist der Ort, an dem die tatsächliche, schrittweise, reproduzierbare Version dieser Methode existiert, mit nummerierten Schritten, eingebetteten Medien und vollständiger Versionshistorie, sodass eine Laborkollegin oder ein Leser in einem anderen Land genau nachvollziehen kann, was Sie getan haben, bis hin zu Reagenzchargen-Nummern und Timing. Protokolle können geforkt werden, sodass ein Labor, das eine veröffentlichte Methode anpasst, vom Original ausgeht und seine eigenen Änderungen nachverfolgt, statt alles aus einem PDF neu zu schreiben. Es ist nahezu zum Standard für Multi-Standort-Studien geworden, bei denen jedes teilnehmende Labor genau dasselbe Verfahren ausführen muss.
Die zentrale Open-Research-Stufe zur Veröffentlichung öffentlicher Protokolle ist kostenlos. Das private Teilen von Protokollen erfordert einen Premium Workspace, abgerechnet pro Mitglied, mit Preisen auf Anfrage. Startups erhalten eine festgelegte jährliche Enterprise-Rate von 11.700 $. Beachten Sie, dass protocols.io 2023 von Springer Nature übernommen wurde und die institutionellen Abonnementpreise seither stark gestiegen sind, wobei manche Institutionen 2025 Erhöhungen von über 700% meldeten. Prüfen Sie daher die aktuellen Konditionen direkt, bevor Sie sich auf institutioneller Ebene verpflichten.
| Das bekommen Sie | Das bekommen Sie nicht |
|---|---|
| Kostenlose, öffentliche Protokollveröffentlichung mit vollständiger Versionshistorie | Preise für den privaten Premium Workspace sind nicht öffentlich gelistet |
| Forking erlaubt es einem Labor, eine veröffentlichte Methode anzupassen und Änderungen nachzuverfolgen | Institutionelle Preise sind seit der Springer-Nature-Übernahme 2023 stark gestiegen |
| Weit verbreitet in Multi-Standort-Studien, die ein identisches Verfahren benötigen | Konsortial-Pläne (mehrere Institutionen) erfordern ein direktes Verkaufsgespräch |
| Eingebettete Medien und Detailtiefe auf Schrittebene, die über einen Methodenabschnitt hinausgeht | Kein Daten- oder Probenverfolgungssystem, rein Protokolldokumentation |
Preise: Kostenlos (öffentliche Protokolle); Preise für den Premium Workspace pro Mitglied auf Anfrage; Startup-Enterprise 11.700 $/Jahr, laut protocols.ios Seite zu den Plänen
Am besten für: Labore, die eine schrittweise Methode über ein Paper, eine Kollaboration oder eine Multi-Standort-Studie hinweg veröffentlichen oder teilen
9. LabArchives: Allgemeines elektronisches Laborbuch
LabArchives ist die breitere, fachunabhängige Alternative zu einer spezialisierten Plattform wie Benchling: ein unkompliziertes elektronisches Laborbuch, gebaut für compliance-fertige Protokollführung über Biologie, Chemie, Physik und mehr hinweg, ohne die Proben-Registry- und Molekulardesign-Funktionen zu benötigen, die ein biotech-spezifisches Tool mitbringt. Einträge sind zeitgestempelt, versioniert und auditierbar, was für die Compliance bei Förderanträgen, IP-Streitigkeiten und jedes Labor wichtig ist, das genau nachweisen muss, wann ein Ergebnis erfasst wurde.
Die kostenlose Stufe ist wirklich begrenzt: zwei eigene Notizbücher, 1 GB Gesamtspeicher und eine Obergrenze von 25 MB pro Datei, was die meisten aktiven Labore innerhalb weniger Wochen überschreiten. Die akademischen Professional-Preise beginnen bei 330 \(pro Jahr; die Unternehmenspreise beginnen bei 575\) pro Nutzer und Jahr. Eine Kursverwaltungsoption kostet 25 $ pro Studierendem und Semester für Lehrlabore. Viele Universitäten haben bereits eine institutionelle Lizenz, die diese Kosten für ihre Forschenden abdeckt, prüfen Sie das also, bevor Sie annehmen, direkt zahlen zu müssen.
| Das bekommen Sie | Das bekommen Sie nicht |
|---|---|
| Fachunabhängiges ELN, geeignet für jedes Labor, nicht nur Biotech | Kostenlose Stufe (2 Notizbücher, 1 GB, 25-MB-Dateien) ist über einen kurzen Pilotversuch hinaus unpraktisch |
| Zeitgestempelte, versionierte, auditbereite Einträge für Compliance-Anforderungen | Keine nativen KI-Funktionen über Aufzeichnungsorganisation und -suche hinaus |
| Course-Manager-Stufe speziell für Lehrlabore gebaut | Viele Institutionen bieten bereits Zugang, prüfen Sie das also, bevor Sie direkt zahlen |
| Akademische Preise ab 330 $/Jahr sind für einzelne Labore erschwinglich | Weniger integriert als Benchling für proben- und inventarintensive Biotech-Arbeit |
Preise: Kostenlos (2 Notizbücher, 1 GB); Professional (akademisch) ab 330 $/Jahr; Corporate ab 575 $/Nutzer/Jahr; Course Manager 25 $/Studierendem/Semester, laut LabArchives' Preisseite
Am besten für: Labore jeder Fachrichtung, die ein compliance-fertiges elektronisches Notizbuch ohne eine vollständige F&E-Plattform brauchen
10. Scholarcy: Schnelle KI-Zusammenfassungen und Karteikarten für umfangreiche Papers
Scholarcy erfüllt ein schmales, aber ständiges Bedürfnis in der Mitte eines Forschungsprojekts: Sie haben mehr Papers zu bewältigen, als die Zeit erlaubt, und brauchen die wichtigsten Aussagen, Methoden und Abbildungen schnell extrahiert, ohne jede Seite zu lesen. Es wandelt ein PDF in eine strukturierte, karteikartenähnliche Zusammenfassung um, komplett mit einer Synopse in einfacher Sprache, den wichtigsten Erkenntnissen und einem Ein-Klick-Literatureintrag, und funktioniert gut als Triage-Schritt, bevor Sie entscheiden, welche Papers eine vollständige Lektüre verdienen. Es ist ein grundlegend anderes Tool als ein Screening-Tool für systematische Reviews oder ein Zitationsprüfungstool, wie sie in unserem Leitfaden zur Literaturrecherche behandelt werden: Scholarcy ist auf Verständnisgeschwindigkeit ausgelegt, nicht auf Klassifizierung oder Evidenzgewichtung.
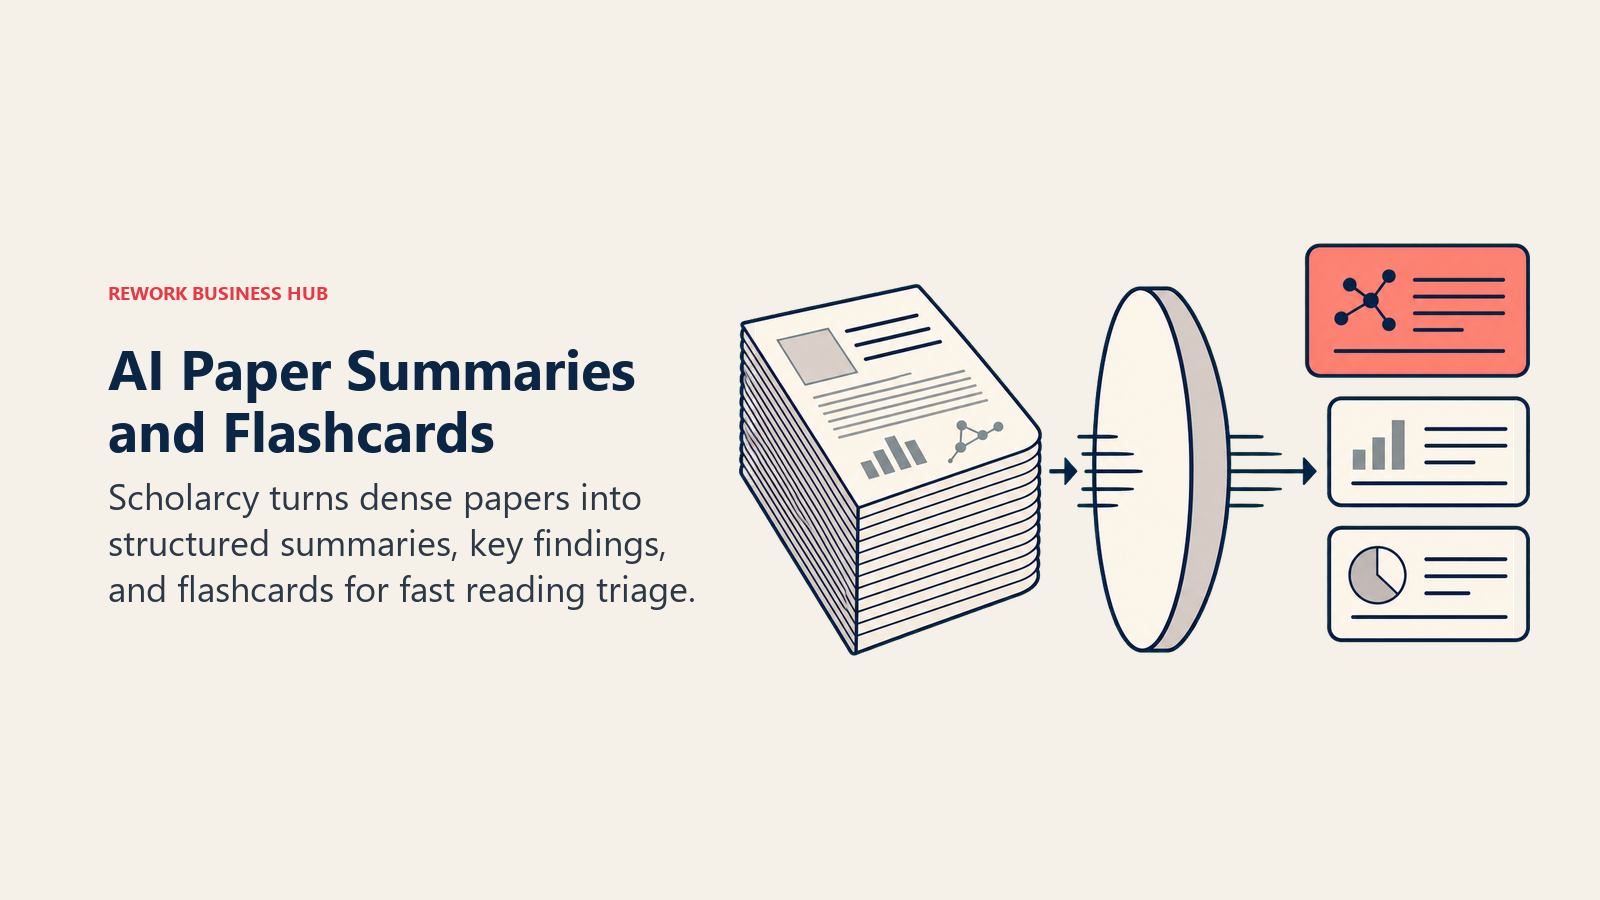
Der kostenlose Plan erlaubt insgesamt bis zu 10 Zusammenfassungen, gedeckelt auf eine pro Tag, genug, um die Ausgabequalität zu testen, aber nicht, um einen echten Leserückstand zu bewältigen. Der kostenpflichtige Zugang kostet 9,99 $/Monat oder 7,99 $/Monat (rund 90 $/Jahr) bei jährlicher Abrechnung und schaltet unbegrenzte Zusammenfassungen, erweiterte Karteikarten und die Erstellung einer Literaturmatrix frei. Institutionen können Scholarcy Library organisationsweit lizenzieren, ab 8.000 $/Jahr, und eine API ist zur Integration verfügbar für 225 $/Monat (1.000 Aufrufe) oder 750 $/Monat (4.000 Aufrufe).
| Das bekommen Sie | Das bekommen Sie nicht |
|---|---|
| Strukturierte Karteikarten-Zusammenfassungen aus einem rohen PDF in Sekunden | Kostenlose Stufe auf insgesamt 10 Zusammenfassungen begrenzt, 1 pro Tag |
| Ein-Klick-Literaturerstellung zusammen mit jeder Zusammenfassung | Kein Screening-, Extraktions- oder Systematic-Review-Tool |
| Literaturmatrix-Funktion zum Vergleichen von Papers nebeneinander (kostenpflichtig) | Zusammenfassungsqualität hängt weiterhin davon ab, wie gut strukturiert das Quell-PDF ist |
| Institutionelle und API-Preise für organisationsweite Bereitstellung verfügbar | Unbegrenzte Nutzung erfordert die kostenpflichtige Stufe für 9,99 $/Monat (oder 90 $/Jahr) |
Preise: Kostenlos (10 Zusammenfassungen, 1/Tag); kostenpflichtig 9,99 $/Monat oder 90 $/Jahr; Academic Institution License ab 8.000 $/Jahr; API ab 225 $/Monat, laut Scholarcys Preisseite
Am besten für: Forschende, die schnell einen großen Stapel Papers sichten müssen, bevor sie sich für eine vollständige Lektüre entscheiden
11. Overleaf (mit Writefull KI): Gemeinsames wissenschaftliches Schreiben
Overleaf ist der gemeinsame LaTeX-Editor, den die meisten MINT-Forschenden bereits verwenden, um Manuskripte zu entwerfen und gemeinsam zu verfassen, und seine Integration mit Writefull ergänzt eine KI-gestützte Sprachpolitur, die speziell auf wissenschaftliches Schreiben abgestimmt ist, nicht auf generische Prosa. Writefull markiert unbeholfene Formulierungen, schlägt präzisere wissenschaftliche Fachbegriffe vor und prüft auf die Art von Konsistenzproblemen (Zeitform, Terminologie, Formatierung), die ein generischer Grammatikprüfer in einem technischen Manuskript übersieht. Da Overleaf und Writefull beide Digital Science gehören, ist die Integration nativ statt nachträglich angebaut.
Overleaf selbst hat eine funktionale kostenlose Stufe für Einzelnutzung und kleine Kollaborationen. Standard kostet rund 21 $/Monat (etwa 199 $/Jahr) und umfasst 10 KI-Nutzungen pro Tag über alle seine Tools hinweg; Professional kostet rund 42 $/Monat (etwa 399 $/Jahr) und schaltet das volle tägliche KI-Kontingent frei. Writefulls eigene Premium-Stufe, für unbegrenzte KI-Schreibunterstützung über Overleaf, Word und den Browser hinweg, ist ein separates Add-on für 150 $/Jahr, wenn Sie KI-Unterstützung außerhalb der Kontingente von Overleaf selbst wollen.
| Das bekommen Sie | Das bekommen Sie nicht |
|---|---|
| Gemeinsames LaTeX-Editieren in Echtzeit, der Standard für MINT-Manuskripte | Standard-Stufe begrenzt die KI-Tool-Nutzung auf 10 Nutzungen pro Tag |
| Writefull-Integration, abgestimmt auf wissenschaftliches Vokabular und Formulierung | Volles KI-Kontingent erfordert die Professional-Stufe (~42 $/Monat) |
| Writefull Premium (150 $/Jahr) erweitert die KI-Hilfe auch auf Word und den Browser | Overleaf selbst prüft weder Zitate noch statistische Aussagen |
| Kostenlose Stufe unterstützt kleines Einzel- oder gemeinsames Schreiben | Team- und institutionelle Lizenzierung erfordern eine separate Verhandlung |
Preise: Kostenlos; Standard ~21 $/Monat; Professional ~42 $/Monat; Writefull-Premium-Add-on 150 $/Jahr, laut Overleafs Seite zu den Plänen
Am besten für: Alle, die gemeinsam ein LaTeX-Manuskript verfassen und speziell auf wissenschaftliches Schreiben abgestimmte KI-Sprachhilfe wollen
12. OSF: Präregistrierung und projektweite Reproduzierbarkeit
Das Open Science Framework (OSF), betrieben vom gemeinnützigen Center for Open Science, adressiert Reproduzierbarkeit früher als fast alles andere auf dieser Liste: Es erlaubt Ihnen, eine Hypothese und einen Analyseplan zu präregistrieren, bevor Sie Daten erheben, die stärkste Verteidigung gegen die Art von nachträglicher Schlussfolgerung, die die von Nature 2016 dokumentierte Reproduzierbarkeitskrise antreibt. Über die Präregistrierung hinaus fungiert OSF als vollständiger Projekt-Hub: Sie können Daten, Code, Materialien und eine vollständige Versionshistorie gemeinsam archivieren, mit Mitarbeitenden verknüpfen und einen dauerhaften, zitierfähigen Nachweis des gesamten Projekts erzeugen, nicht nur des finalen Papers.
Es ist kostenlos, ohne Gebühren oder Lizenz für Forschende, Institutionen oder die Öffentlichkeit. Der Speicher ist bei privaten Projekten auf 5 GB pro Komponente begrenzt und bei öffentlichen Projekten auf 50 GB, aber weil ein Projekt unbegrenzt viele Komponenten haben kann, ist der Speicher für die meisten Labore funktional unbegrenzt, nur anders organisiert als ein einzelner flacher Ordner.
| Das bekommen Sie | Das bekommen Sie nicht |
|---|---|
| Präregistrierung von Hypothesen und Analyseplänen vor der Datenerhebung | 5-GB-Limit pro Komponente bei privaten Projekten (über Komponenten umgehbar) |
| Kostenlos, keine Lizenz, keine Gebühren für jeden Nutzertyp | Kein Laborbuch, keine schrittweise Protokoll- oder Probenverfolgung |
| Archiviert Daten, Code und Materialien gemeinsam mit vollständiger Versionshistorie | Weniger strukturiert als Zenodo für eine einzelne, zitierfähige Datensatzhinterlegung |
| Öffentliche Projekte erhalten 50 GB Speicher und funktional unbegrenzte Komponenten | Am besten geeignet für projektweite Organisation, nicht individuelle Dateiarchivierung |
Preise: Kostenlos, keine Gebühren, laut OSFs eigener Dokumentation
Am besten für: Teams, die eine Studie präregistrieren und das gesamte Projekt, nicht nur den finalen Datensatz, an einem Ort reproduzierbar halten wollen
13. Zenodo: Dauerhafte, DOI-gestützte Archivierung für Daten und Code
Zenodo, betrieben von CERN über das OpenAIRE-Programm, ist der Endpunkt, den die meisten Forschenden ansteuern, wenn eine Fachzeitschrift oder ein Förderer ein dauerhaftes, zitierfähiges Archiv eines bestimmten Datensatzes oder einer Code-Veröffentlichung verlangt. Verbinden Sie ein GitHub-Repository, und Zenodo kann automatisch bei jedem Release-Tag einen Snapshot archivieren und eine DOI für genau diese Version vergeben, was das Problem löst, dass sich ein GitHub-Repository ändert (oder verschwindet), nachdem ein Paper es zitiert hat. Es ist kostenlos, universell für jede Fachrichtung, und erfordert keine institutionelle Zugehörigkeit zur Nutzung.
Es gibt keine Gesamtspeichergrenze, aber jeder einzelne Datensatz (eine einzelne Hinterlegung, wie ein Datensatz oder ein Code-Release) ist auf 50 GB begrenzt. Für die meisten Datensätze und Code-Repositories, die mit einem einzelnen Paper verknüpft sind, ist diese Obergrenze selten eine praktische Einschränkung.
| Das bekommen Sie | Das bekommen Sie nicht |
|---|---|
| Kostenlose, dauerhafte, DOI-gestützte Archivierung für jeden Datensatz oder jedes Code-Release | 50-GB-Obergrenze pro einzelnem Datensatz (kein Gesamtkontolimit) |
| Automatische GitHub-Integration archiviert einen Snapshot bei jedem getaggten Release | Kein Kollaborations- oder Projektmanagement-Tool wie OSF |
| Keine institutionelle Zugehörigkeit erforderlich, offen für jede:n Forschende:n | Am besten für eine einzelne Artefakthinterlegung geeignet, weniger für ein sich entwickelndes Projekt |
| CERN/OpenAIRE-betrieben, starke langfristige Stabilitätsgarantie | Metadaten und Auffindbarkeit hängen davon ab, wie gut Sie die Hinterlegung taggen |
Preise: Kostenlos, keine Kontoobergrenze, 50 GB pro Datensatz, laut Zenodos Plattform
Am besten für: Die Archivierung eines bestimmten Datensatzes oder Code-Releases mit einer dauerhaften DOI, sobald ein Paper zur Zitierung bereit ist
Reproduzierbarkeitsfehler, die Sie vermeiden sollten
Das richtige Tool für jede Phase zu wählen, erzeugt nicht automatisch reproduzierbare Forschung. Ein paar Gewohnheiten entscheiden darüber, ob das alles unter genauer Prüfung tatsächlich standhält.
| Fehler | So sieht es aus | Was Sie stattdessen tun sollten |
|---|---|---|
| Einer KI-generierten Hypothese vertrauen, ohne ihre Evidenz zu prüfen | Eine von FutureHouse oder einem Chatbot vorgeschlagene Hypothese direkt an die Laborbank bringen | Prüfen Sie, ob die zugrunde liegenden Zitate existieren und die Aussage tatsächlich stützen, bevor Sie ein Experiment darauf aufbauen |
| Protokolle in einem persönlichen Dokument statt in einem versionierten System aufbewahren | Eine Methode, die nur im Word-Dokument oder Gedächtnis einer Person existiert | Verschieben Sie sie in protocols.io oder Ihr ELN, damit Versionshistorie und Forking möglich sind |
| Daten analysieren, ohne den Lauf zu protokollieren | Ein Skript ausführen, ein Ergebnis erhalten und die exakte Codeversion oder die verwendeten Parameter nicht dokumentieren | Protokollieren Sie jeden Lauf in Weights & Biases oder einem gleichwertigen Tracker, auch bei "schnellen" explorativen Analysen |
| Ohne reproduzierbare Kapsel oder Archiv veröffentlichen | Einen GitHub-Link teilen, der sich unweigerlich ändern oder veralten wird | Archivieren Sie einen festen Snapshot in Code Ocean oder Zenodo und zitieren Sie die DOI, nicht das lebende Repository |
| Präregistrierung bei konfirmatorischen Studien überspringen | Den Analyseplan erst festlegen, nachdem Sie gesehen haben, wie die Daten aussehen | Präregistrieren Sie Hypothese und Analyseplan in OSF, bevor die Datenerhebung beginnt |
| Annehmen, codelastige KI-Ausgaben seien korrekt, weil sie laufen | Ein KI-generiertes Analyseskript akzeptieren, weil es fehlerfrei ausgeführt wurde | Prüfen Sie die statistische Ausgabe stichprobenartig gegen ein bekanntes Ergebnis oder eine zweite Methode, genau wie Sie die Arbeit einer wissenschaftlichen Hilfskraft prüfen würden |
Entscheidungsrahmen
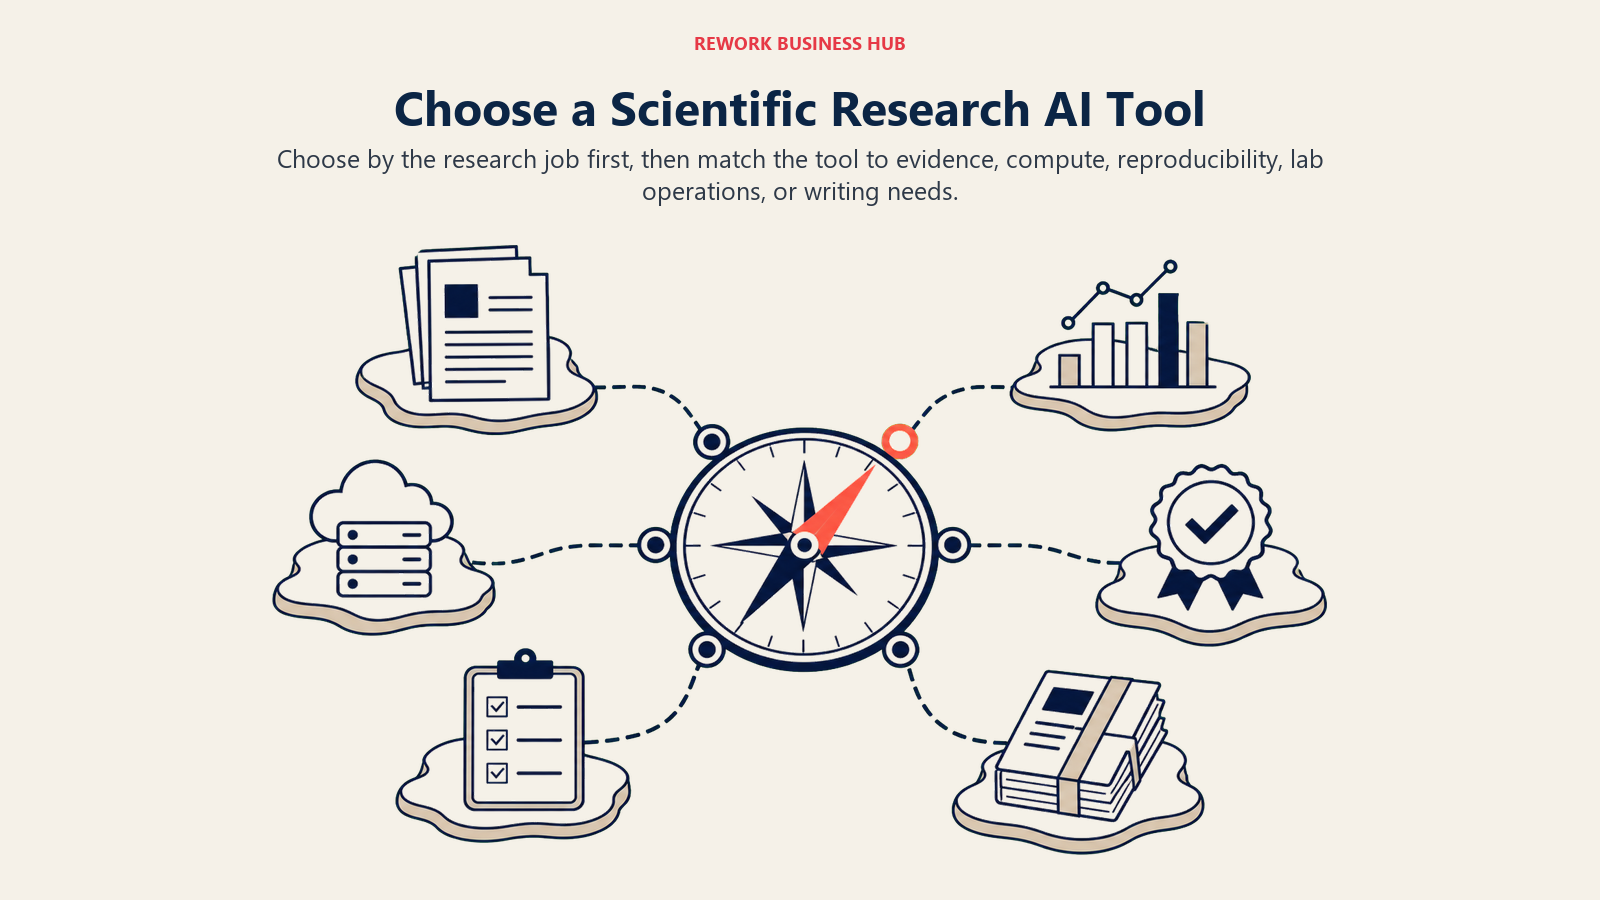
Die praktische Wahl beginnt mit der Forschungsaufgabe, von Hypothesengenerierung und Analyse bis zu Reproduzierbarkeit, Laborbetrieb, Paper-Triage oder wissenschaftlichem Schreiben.
| Wenn Sie brauchen... | Wählen Sie... | Warum |
|---|---|---|
| Einen KI-Agenten, der eine Hypothese vorschlägt und evidenzbasiert prüft | FutureHouse Platform | PaperQA2 erreicht oder übertrifft die Genauigkeit der Literaturrecherche auf PhD-Niveau |
| Statistiken und Diagramme, ohne Analysecode zu schreiben | Julius AI | Prompts in natürlicher Sprache führen echte Statistiken aus und erzeugen Visualisierungen |
| Kostenlose oder günstige Rechenleistung für Python-basierte Forschung | Google Colab | Kostenloser GPU-Zugriff plus Gemini-gestütztes Coding, kein Setup nötig |
| Einen KI-Pair-Programmer für eine echte Forschungscodebasis | GitHub Copilot | 55% schnellere Aufgabenerledigung in GitHubs eigener kontrollierter Studie |
| Um jeden Experimentlauf für Reproduzierbarkeit zu verfolgen | Weights & Biases | Protokolliert Hyperparameter, Codeversion und Ergebnisse automatisch |
| Um reproduzierbaren Code und Daten mit einer Publikation zu liefern | Code Ocean | Ein-Klick-Compute-Kapseln, die Fachzeitschriften unabhängig erneut ausführen können |
| Eine verbundene Plattform für den Biotech-F&E-Betrieb | Benchling AI | Notebook, Registry, Inventar und KI-Copilot in einem einzigen System |
| Um ein versioniertes Laborprotokoll zu dokumentieren und zu teilen | protocols.io | Schrittweise, forkbare Protokolle mit vollständiger Versionshistorie |
| Ein universelles, compliance-fertiges Laborbuch | LabArchives | Fachunabhängiges ELN mit auditbereiten Einträgen |
| Um schnell einen großen Stapel Papers zu sichten | Scholarcy | Karteikarten-ähnliche KI-Zusammenfassungen in Sekunden pro Paper |
| KI-gestütztes gemeinsames wissenschaftliches Schreiben | Overleaf (+ Writefull) | Gemeinsame LaTeX-Bearbeitung in Echtzeit mit wissenschaftlich abgestimmten Sprachprüfungen |
| Um eine Studie zu präregistrieren und das gesamte Projekt zu archivieren | OSF | Kostenlose Präregistrierung plus Daten, Code und Materialien an einem Ort |
| Eine dauerhafte, zitierfähige DOI für einen Datensatz oder ein Code-Release | Zenodo | Kostenlos, CERN-betrieben, automatische GitHub-Release-Archivierung |
Wenn sich Ihre Arbeit mit der Phase der Literaturentdeckung und Zitationsprüfung überschneidet, gehen unsere Leitfäden Die besten KI-Tools für die akademische Forschung und Die besten KI-Tools für Literaturrecherchen tiefer auf diesen Teil des Workflows ein. Wenn Ihre Analysearbeit umfangreich genug ist, um einen eigenen tiefen Einblick auf der Datenseite zu brauchen, decken Die besten KI-Tools für Datenanalyse und Die besten KI-Coding-Tools das ausführlicher ab, und Cursor vs Copilot vs Windsurf schlüsselt speziell die KI-Coding-Assistenten auf, falls Sie zwischen ihnen wählen. Budgetbewusste Forschende sollten außerdem Die besten KI-Tools für Studierende für Ideen zum Kombinieren kostenloser Stufen prüfen.
Häufig gestellte Fragen zu KI-Tools für die wissenschaftliche Forschung
Was ist das beste KI-Tool für die wissenschaftliche Forschung 2026?
Es gibt kein einzelnes bestes Tool, weil wissenschaftliche Forschung ein mehrstufiger Lebenszyklus ist. FutureHouses Plattform ist am stärksten für die Hypothesengenerierung, Julius AI und Google Colab für die Datenanalyse, Weights & Biases und Code Ocean für Reproduzierbarkeit, Benchling AI und protocols.io für Laborprotokolle, und Overleaf plus OSF und Zenodo für Schreiben und Archivierung. Die meisten aktiven Labore nutzen mehrere davon gemeinsam, nicht nur eines.
Wie unterscheidet sich das von einem Leitfaden zur akademischen Forschung oder Literaturrecherche?
Leitfäden zur akademischen Forschung und Literaturrecherche konzentrieren sich auf das Finden, Sichten und Synthetisieren bestehender Papers. Dieser Leitfaden setzt danach an: eine testbare Hypothese generieren, das Experiment entwerfen und dokumentieren, die entstehenden Daten analysieren, sie für Reproduzierbarkeit nachverfolgen und das Paper fertigstellen und archivieren. Manche Forschenden brauchen je nach Projektphase beide Stacks.
Können KI-Tools tatsächlich eine echte wissenschaftliche Hypothese generieren?
Das Robin-System von FutureHouse hat das demonstriert, indem es eine Hypothese zu einer Krankheitsbehandlung in rund 2,5 Monaten vom Konzept zu einem entworfenen, evidenzgestützten Paper brachte. Aber diese Ausgaben brauchen weiterhin eine fachkundige Überprüfung, bevor Laborzeit investiert wird, genauso wie Sie eine von einer jüngeren Kollegin vorgeschlagene Hypothese kritisch prüfen würden.
Was ist der Unterschied zwischen Weights & Biases und Code Ocean?
Weights & Biases verfolgt Experimente, während Sie sie durchführen, und protokolliert jeden Hyperparameter, jede Codeversion und jedes Ergebnis, damit Sie Läufe vergleichen und zurückverfolgen können, was eine bestimmte Ausgabe erzeugt hat. Code Ocean verpackt ein fertiges Stück Arbeit (Code, Daten und Umgebung) in eine einzige Kapsel, die ein Gutachter oder eine Leserin mit einem Klick erneut ausführen kann. Viele computergestützte Labore nutzen beides: W&B während der Forschungsphase, Code Ocean zum Publikationszeitpunkt.
Lohnt sich Benchling für ein kleines akademisches Labor?
Wahrscheinlich nicht allein. Die Preisgestaltung und der Funktionsumfang von Benchling sind für organisationsweite Biotech- und Pharma-F&E-Abläufe gebaut. Ein einzelnes akademisches Labor ist meist besser mit einer leichteren, günstigeren Kombination wie LabArchives für Notizbuchaufzeichnungen und protocols.io für gemeinsame Methoden bedient.
Brauche ich sowohl OSF als auch Zenodo?
Sie lösen verwandte, aber unterschiedliche Probleme. OSF ist um das gesamte Projekt herum gebaut (Präregistrierung, laufende Dateien, Mitarbeitendenzugriff), während Zenodo für die Archivierung eines bestimmten, fertigen Artefakts (ein Datensatz, ein Code-Release) mit einer dauerhaften DOI gebaut ist. Viele Forschende präregistrieren und verwalten das Projekt in OSF und veröffentlichen dann einen finalen Datensatz oder ein Code-Release in Zenodo für die zitierfähige, dauerhafte Kopie.
Wie zuverlässig ist KI-generierter Analysecode?
Behandeln Sie ihn so, wie Sie ein von einer neuen wissenschaftlichen Hilfskraft geschriebenes Skript behandeln würden: nützlich als Ausgangspunkt, aber nichts, dem Sie blind vertrauen sollten. Stack Overflows Umfrage von 2025 ergab, dass das Vertrauen der Entwicklerinnen und Entwickler in die Genauigkeit von KI-generiertem Code auf 29% gesunken ist, und 66% gaben an, mehr Zeit damit zu verbringen, "fast richtige" KI-Ausgaben zu korrigieren. Prüfen Sie statistische Ergebnisse stichprobenartig gegen eine bekannte Methode, bevor sie in ein Paper gelangen.
Was ist der günstigste Weg, einen reproduzierbarkeitsorientierten Forschungs-Stack aufzubauen?
Die kostenlose Stufe von Google Colab, der kostenlose persönliche Plan von Weights & Biases (200 GB Speicher), OSF (vollständig kostenlos) und Zenodo (vollständig kostenlos) decken zusammen Rechenleistung, Experiment-Tracking, Präregistrierung und dauerhafte Archivierung ohne Abonnement ab. Das wichtigste Upgrade, das die meisten Labore irgendwann bezahlen, ist GitHub Copilot oder Julius AI, sobald das Coding- oder Analysevolumen über das hinauswächst, was ohne Unterstützung noch komfortabel ist.
Die nächsten Schritte
Ordnen Sie Ihr eigenes Projekt den sechs Phasen oben zu und wählen Sie ein Tool pro Phase, statt nach einer einzigen Plattform zu suchen, die alles kann. Ein vernünftiger Startstack kostet nichts: Google Colab für Rechenleistung, die kostenlose Stufe von Weights & Biases für Experiment-Tracking, protocols.io oder OSF für die Dokumentation und Zenodo für das finale Archiv. Ergänzen Sie ein kostenpflichtiges Tool erst, sobald Sie auf einen echten Engpass gestoßen sind, sei es GitHub Copilot, sobald Ihre Codebasis über die Einzelpflege hinauswächst, Julius AI, sobald Sie es leid sind, dasselbe Analyseskript immer wieder von Hand zu schreiben, oder Benchling, sobald die Protokolle und das Inventar Ihres Labors eine Tabellenkalkulation hinter sich lassen. Testen Sie die kostenlosen Stufen an Ihrem aktuellen Projekt, bevor Sie irgendetwas abonnieren, und sobald Ihre Ergebnisse zur Verschriftlichung bereit sind, deckt unser Vergleich Claude vs ChatGPT vs Gemini die universellen Assistenten ab, die sich für das eigentliche Verfassen mit den spezialisierten Tools oben kombinieren lassen.
Principal Product Marketing Strategist
On this page
- Wichtige Fakten
- Was sich 2026 geändert hat
- Der Lebenszyklus der wissenschaftlichen Forschung: Wo jedes Tool ansetzt
- Schnellvergleichstabelle
- Workflow-Passungsmatrix
- Größen- und Zielgruppentabelle
- 1. FutureHouse Platform: KI-Agenten für literaturgestützte Hypothesengenerierung
- 2. Julius AI: Statistik und Datenanalyse in natürlicher Sprache
- 3. Google Colab: Kostenlose Cloud-Notebooks mit Gemini-gestütztem Coding
- 4. GitHub Copilot: KI-Pair-Programming für Forschungscodebasen
- 5. Weights & Biases: Experiment-Tracking für reproduzierbare computergestützte Forschung
- 6. Code Ocean: Reproduzierbare Compute-Kapseln für Publikationen
- 7. Benchling AI: Einheitliches ELN, LIMS und KI-Copilot für Life Sciences
- 8. protocols.io: Versionierte, teilbare Laborprotokolle
- 9. LabArchives: Allgemeines elektronisches Laborbuch
- 10. Scholarcy: Schnelle KI-Zusammenfassungen und Karteikarten für umfangreiche Papers
- 11. Overleaf (mit Writefull KI): Gemeinsames wissenschaftliches Schreiben
- 12. OSF: Präregistrierung und projektweite Reproduzierbarkeit
- 13. Zenodo: Dauerhafte, DOI-gestützte Archivierung für Daten und Code
- Reproduzierbarkeitsfehler, die Sie vermeiden sollten
- Entscheidungsrahmen
- Die nächsten Schritte